資訊悅報 Vol.64|RE:FORM REASON: 多數服務中斷都始於一次變更:REASON Change Adviser 正式登場

多數服務中斷都始於一次變更:REASON Change Adviser 正式登場

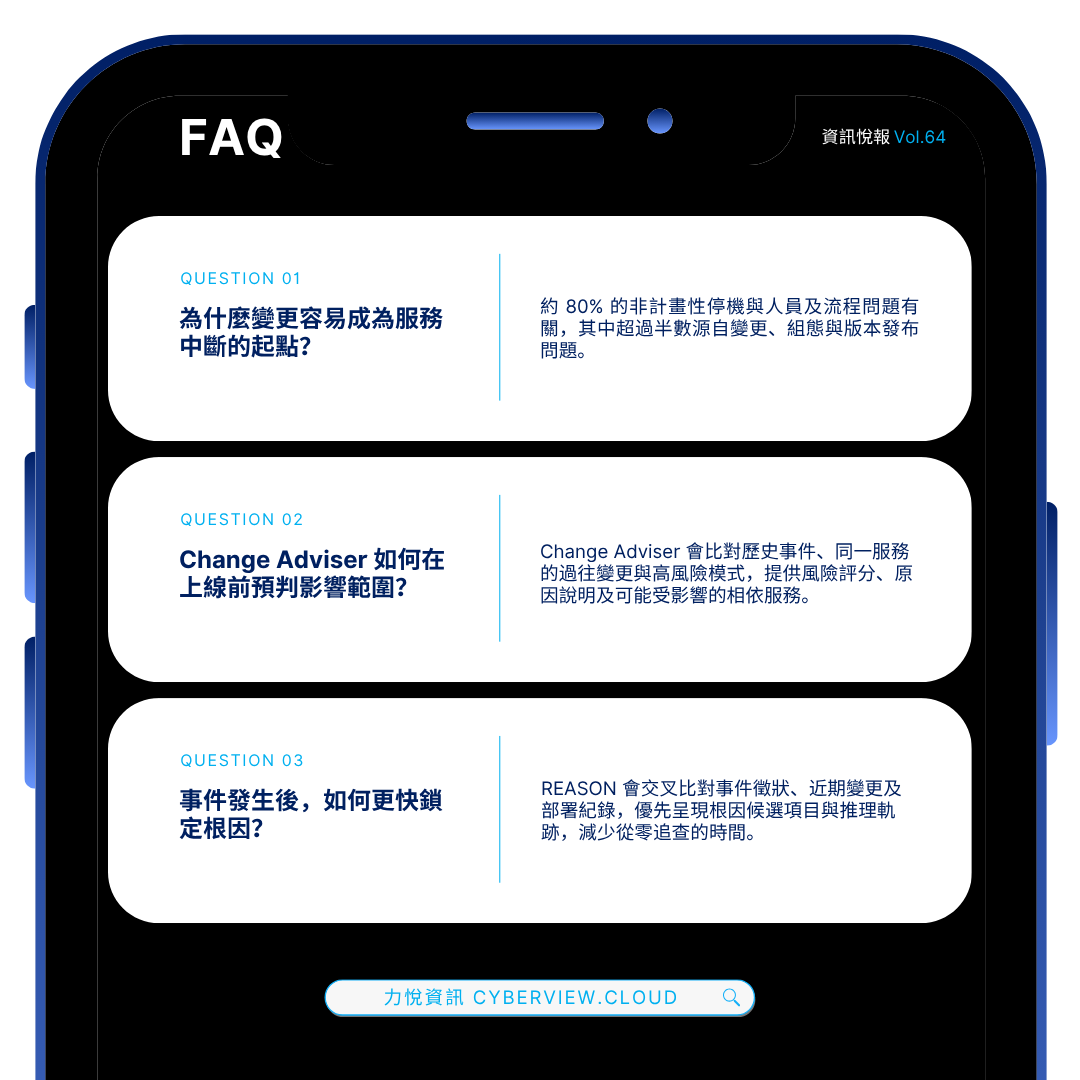
Gartner 研究團隊用數據量化了每位值班工程師早已憑直覺知道的事:影響關鍵任務服務的非計畫性停機,約有 80% 可追溯至人員與流程問題,而非硬體或災害;其中超過半數更明確源自變更、組態與版本發布問題。¹

換句話說,多數事件並非始於難解的謎團,而是始於一次部署、一項組態修改,或某人在週五下午核准的「小」變更。

REASON 已能在事件發生後進行推理,如同團隊中最優秀的工程師,將告警轉化為可執行的修復措施。Change Adviser 將同一套推理引擎往前推進一步,讓更多事件根本不會演變成告警。


沒有人有時間追查的變更與事件關聯

變更管理失效,不是因為團隊不在乎,而是因為真正重要的兩套系統——變更紀錄與事件歷史——通常彼此不相通。

結果隨處可見:

  • 風險評估只是勾選欄位,而非實質分析。 變更諮詢委員會根據描述欄位與直覺判斷核准變更,而非檢視相似變更過去曾對系統造成哪些實際影響。
  • 根因調查每次都從零開始。 事件發生時,工程師必須手動翻查近期部署、組態修改與基礎架構變更,才能找出可能的觸發原因,往往將事件處理最寶貴的時間耗費在搜尋上。
  • 相同錯誤在不同團隊間重複發生。 某項變更六個月前曾造成一項服務中斷,卻又在另一項服務中獲得核准,只因為沒有人將兩者關聯起來。
  • 70% 的變更計畫難以按照原定規畫落實。 缺少回饋循環時,組織便無法辨識自身哪些變更持續帶來較高風險。²

這與其說是推理失效,不如說是可視性不足。預防或診斷多數事件所需的資訊其實早已存在,只是分散在工單系統、部署紀錄,以及團隊口耳相傳的經驗之中。


REASON Change Adviser 正式登場

Change Adviser 將 REASON 的 Tree of Thought 推理與您的變更及部署歷程連結,並運用在事件生命週期中的兩個階段:

1. 變更前風險評分

部署或組態變更上線前,REASON 會分析您的歷史事件資料、同一服務過去的變更,以及已知的高風險模式,產出風險評分,並以易於理解的文字說明評分原因。

  • 預測影響範圍。 REASON 會根據過往事件,標示變更一旦出錯,最可能受到影響的下游服務與相依項目。
  • 依歷史案例推理,而非採用靜態檢核表。 REASON 不使用固定規則引擎,而是將預定變更拆解為可驗證的假設,再逐一對照您的實際歷史紀錄,方式與分析即時事件時相似。
  • 為核准環節而設計。 風險評分與推理軌跡會直接寫入既有的變更申請或 CAB 工作流程,讓審查人員不必離開原本使用的工具,就能取得第二意見。

2. 變更與事件關聯分析

事件發生時,REASON 會自動檢查近期變更與部署紀錄,將其列為可能的根因候選項目;這項分析在工程師開啟終端機前就已開始。

  • 縮短建立假設的時間。 REASON 會交叉比對事件徵狀,以及受影響服務與其相依項目的近期變更,優先呈現最可能的原因。
  • 依據證據,而非猜測。 每個候選項目都附有相應的推理軌跡,讓工程師能快速驗證或排除,不必毫無線索地從頭展開調查。
  • 回饋至循環。 每項經確認或排除的關聯都會成為訓練訊號;同一套人員回饋循環,也會讓 REASON 的事件分流隨時間逐步提高準確度。

Change Adviser 採用與 REASON 其他功能相同的架構:預設採地端部署,不綁定特定 LLM 或 GPU,並可透過 MCP、API 或 A2A 整合至您既有的 ITSM 與部署工具。不需要遷移資料,也不必重建工作流程。


以同一套推理引擎實現預防與應變

多數工具將變更風險與事件應變視為兩個不同領域,並分別使用兩套工具處理。Change Adviser 則將兩者視為同一個問題:讓 REASON 能在正式環境中進行事件分流的推理能力,正是在高風險變更演變成事件前將其找出的必要能力。

對於同時使用 REASON 與 RE:FORM DEPLOY 的團隊而言,這能進一步完成整個循環——從變更如何發布、核准時能有多大把握,到問題仍然發生時能多快完成診斷。


準備好在高風險變更演變成事件之前,先一步將它找出來了嗎?

預約產品展示


1 Gartner RAS 核心研究:非計畫性停機,以及變更、組態與版本發布管理;經 2026 年產業變更管理研究引述。

2 變更管理統計,2026 年產業報導。

資訊悅報 Vol.63|Vicarius: 漏洞工單六週仍未清空?2026 年持續威脅暴露管理(CTEM)導入指南

部落格來源網址:How to implement CTEM in 2026


如何在 2026 年導入持續威脅暴露管理(CTEM)

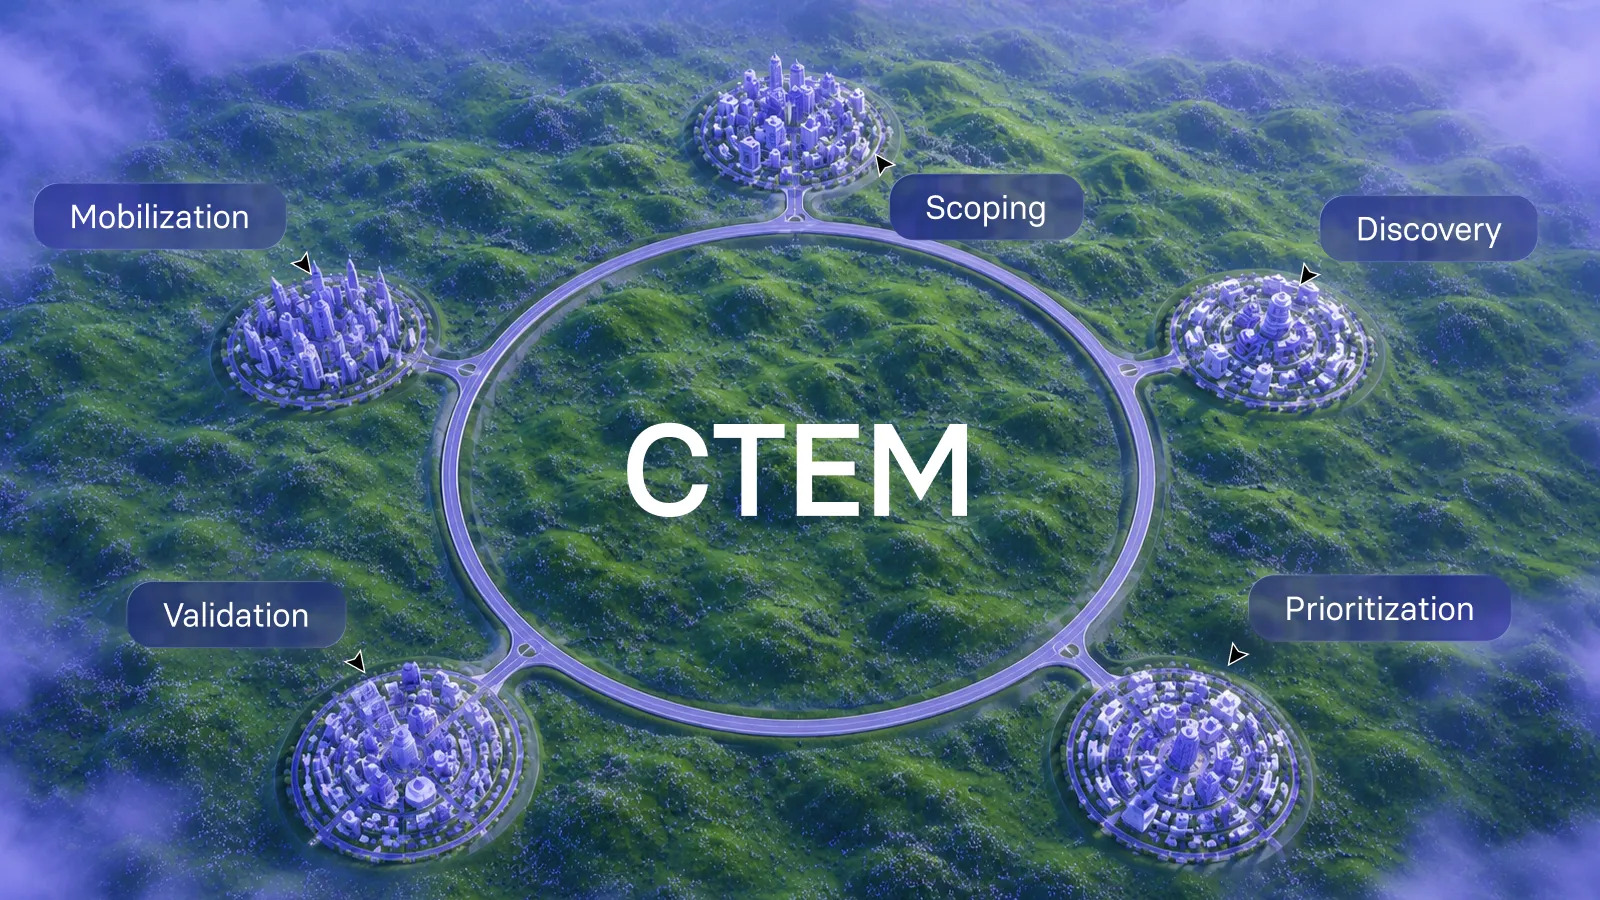
你的資安團隊執行掃描、標記漏洞並建立工單。六週後,同一批常見漏洞與暴露(Common Vulnerabilities and Exposures, CVE)仍躺在處理佇列中。是否似曾相識?持續威脅暴露管理(Continuous Threat Exposure Management, CTEM)導入提供了一條跳脫這種循環的路徑,透過範圍界定、探索、優先排序、驗證與推動處置五階段循環,將漏洞資料轉化為經確認的風險降低成果。
本指南將帶領企業資安與 IT 團隊建立可實際執行的持續威脅暴露管理(CTEM)計畫。你將學會如何界定攻擊面、將曝險對應至業務影響、驗證攻擊者能夠利用哪些弱點,以及推動補救工作,徹底關閉漏洞。


重點摘要:導入持續威脅暴露管理(CTEM)

  • 持續威脅暴露管理(CTEM)是一套五階段循環,透過範圍界定、探索、優先排序、驗證與推動處置,將漏洞發現轉化為可衡量的曝險降低成果。
  • 範圍界定會在探索開始前,先定義關鍵資產、攻擊面邊界,以及與業務風險連結的成功指標,避免範圍無限制擴張。
  • 優先排序結合通用漏洞評分系統(Common Vulnerability Scoring System, CVSS)嚴重程度、漏洞利用預測評分系統(Exploit Prediction Scoring System, EPSS)利用機率,以及美國網路安全暨基礎設施安全局已知遭利用漏洞清單(CISA Known Exploited Vulnerabilities, CISA KEV),依真實世界風險而非理論嚴重程度排列漏洞。
  • 驗證會確認漏洞是否能在你的環境中遭到利用,減少誤判,並提高工程團隊對補救需求的信心。
  • Vicarius vRx 透過自動化補丁、虛擬補丁(Patchless Protection)與腳本式補救,處理整個漏洞佇列,縮小補救缺口。

什麼是持續威脅暴露管理(CTEM),為何它在 2026 年如此重要?

CTEM 代表持續威脅暴露管理(Continuous Threat Exposure Management)。Gartner 提出這套架構,協助組織從週期性的漏洞掃描,轉向以降低資安曝險為目標的結構化營運模式。

傳統漏洞管理(Vulnerability Management)著重於找出弱點,持續威脅暴露管理(CTEM)則著重於將弱點補救完成。這套架構採用持續循環,而非單一時間點的評估,讓資安態勢能隨著環境變化持續維持最新狀態。

攻擊面的成長速度超過資安團隊的人力擴充速度。雲端工作負載每天持續建立,第三方整合不斷增加,舊版系統也經常在生命週期終止後持續於正式環境運作。以週期性評估為核心的計畫,無法跟上這樣的變化速度。


持續威脅暴露管理(CTEM)五階段解析

持續威脅暴露管理(CTEM)將暴露管理(Exposure Management)拆分為五個階段,形成反覆執行的循環。每個階段都會產生具體成果,並成為下一階段的輸入。若能妥善執行,這套循環會隨時間持續精進。

階段一:範圍界定(Scoping)

範圍界定會定義持續威脅暴露管理(CTEM)計畫要保護的對象,以及衡量成功的方式。若缺乏明確範圍,持續威脅暴露管理(CTEM)就會變成試圖管理所有事物的漏洞管理計畫,最後反而什麼都管不好。

首先找出關鍵業務服務,再將這些服務對應至支援它們的資產。定義攻擊面邊界並建立成功指標。良好的範圍應是一項業務風險假設,而不是一份組態管理資料庫(Configuration Management Database, CMDB)匯出清單。

第一次執行循環時,應選擇補救量能足以負荷的小範圍領域。先在中度風險領域完成一次試行,有助於建立可信度與實務經驗,讓後續循環能進一步處理風險更高的領域。

階段二:探索(Discovery)

探索要回答兩個問題:環境中有哪些資產,以及這些資產出了什麼問題?這個階段不只進行常見漏洞與暴露(CVE)掃描,也涵蓋錯誤組態、身分安全弱點、軟體即服務(Software as a Service, SaaS)安全態勢缺口,以及第三方整合風險。

針對已界定的範圍建立資產清冊(Asset Inventory),記錄資產識別資訊、負責人、業務關鍵性與曝險態勢。探索工具不可或缺,但分類發現項目、連結業務情境並指派負責人,仍需要投入大量人力。

涵蓋範圍缺口本身也是一項發現。若掃描工具未涵蓋範圍內十二項服務中的三項,這個缺口就代表尚未受到監控的曝險。

階段三:優先排序(Prioritization)

面對多數組織所發現的大量曝險,優先排序將決定團隊能否持續推進,或被工單淹沒。這個階段會依據可利用性、業務影響與既有資安控制措施排列風險。

通用漏洞評分系統(CVSS)本身只是嚴重程度分數,不等同於風險評估。只存在於內部非正式環境、CVSS 為 9.8 的漏洞,實際急迫性確實可能低於位於網際網路對外身分驗證服務、CVSS 為 7.0 的漏洞。應將 CVSS 與漏洞利用預測評分系統(EPSS)利用機率及 CISA 已知遭利用漏洞(KEV)資料結合,建立能反映真實世界風險的排序模型。

風險導向優先排序(Risk-Based Prioritization)除了威脅情資(Threat Intelligence),也會納入資產關鍵性與業務情境。最終成果是一份具備充分依據的優先順序清單,並搭配工程團隊能夠履行的服務等級協議(Service-Level Agreement, SLA)。

階段四:驗證(Validation)

驗證會將「理論上存在風險」轉化為「實際可遭利用」。這個階段會測試攻擊能否在你的環境中成功執行、控制措施是否如預期阻擋或偵測攻擊,以及補救措施是否已降低或移除曝險。

驗證並不是滲透測試(Penetration Test)。你已經掌握特定曝險,也對其可利用性提出明確假設,接著再對該假設進行測試。目標是速度與精準度,而不是沒有明確邊界的開放式評估。

依原文敘述,可預期有 30% 至 40% 的第一優先級與第二優先級(P1/P2)曝險會在驗證後調降,原因可能是補償性控制措施(Compensating Controls)確實有效,或該利用方式不適用於現有組態。另有 10% 至 15% 的曝險可能在測試發現實際風險高於掃描工具判定時調升。

階段五:推動處置(Mobilization)

推動處置會將已驗證的發現項目轉化為實際執行的補救行動。發現項目會成為具備證據、負責人與服務等級協議(SLA)的工程層級工作項目。例外情況會納入治理,相關指標則呈現實際降低的曝險程度。

補救工單的品質會直接影響工程團隊是否採取行動。應以業務影響與驗證證據為主,而不是只提供發現項目數量。工單也應包含明確的補救方式,例如要升級的程式庫版本、需要套用的組態變更,或必須新增的規則。

每次完成補救後,都應重新執行先前用來證明漏洞可遭利用的相同測試。若補救有效,該利用測試就應失敗;若測試沒有失敗,就表示補救並未成功,必須退回重新處理。


如何啟動持續威脅暴露管理(CTEM)計畫:90 天路線圖

許多組織在導入持續威脅暴露管理(CTEM)時陷入停滯,原因是尚未透過專案證明方法有效,就急著將其全面轉化為正式計畫。第一次循環應視為具有時間限制的試行專案:範圍明確、交付成果具體,並在第 90 天設定清楚的決策點。

第 1 至 30 天:定義試行範圍

依據三項條件選擇試行領域。第一,哪些領域具備足夠的補救量能?應選擇負責補救的團隊具備時間與執行意願的領域。第二,哪些領域能取得曝險資料?應選擇不需要歷經數月整合專案,就能盤點資產的領域。第三,哪些領域能展現與業務相關的風險降低成果?

撰寫範圍章程,納入威脅情境、有明確理由的排除項目,以及具體且可驗證的成功標準。只寫著「降低重大曝險」的章程缺乏可驗證的明確目標;若寫成「移除所有可從網際網路連線至管理介面的路徑」,就能為所有人提供清楚的執行目標。

第 31 至 60 天:探索並排列優先順序

針對已界定的範圍建立資產清冊,納入資產識別資訊、負責人、業務關鍵性與曝險態勢。設定明確界線:到了第六週結束時,就以目前掌握的資料繼續推進;缺少的部分則列為發現項目。

在資產清冊上疊加曝險資料。只針對範圍內資產,查詢漏洞掃描工具、雲端安全態勢管理(Cloud Security Posture Management, CSPM)工具、身分平台、網域名稱系統(Domain Name System, DNS)紀錄與程式碼儲存庫。接著套用優先排序模型,建立已排序的處理佇列。

第 61 至 90 天:驗證並推動處置

測試利用方式能否在環境中成功執行,以驗證第一優先級與第二優先級(P1/P2)曝險。記錄驗證結果,並提供工程團隊可據以採取行動的證據。

建立補救工單,明確說明需要執行的變更、未完成補救可能造成的業務影響,以及驗證補救是否有效的方法。追蹤進度、升級處理阻礙,並在關閉每一項完成的補救工作前重新驗證。


持續威脅暴露管理(CTEM)與傳統漏洞管理有何不同?

漏洞管理(Vulnerability Management)聚焦於以常見漏洞與暴露(CVE)編號識別的軟體弱點。持續威脅暴露管理(CTEM)則涵蓋任何可能讓資料、身分或基礎架構面臨風險的曝險,包括憑證外洩、仿冒網域、錯誤組態與受感染裝置等。

掃描工具產生發現項目,持續威脅暴露管理(CTEM)則透過結構化工作流程,產出已完成補救的曝險。兩者的差異在於探索之後發生了什麼:優先排序納入業務情境、驗證證明實際可利用性,並透過推動處置完成補救。

如果掃描工具產生的報告只是停留在處理佇列中,再增加一套掃描工具也無法解決問題。你需要的是一套能將發現問題推進至完成補救的系統。


克服常見的持續威脅暴露管理(CTEM)導入挑戰

組織在導入持續威脅暴露管理(CTEM)時,通常會遇到可預期的障礙。事先理解這些問題,有助於提前規劃應對方式。

挑戰:補救工作卡在跨團隊協作

資安團隊識別風險,IT 團隊負責補救。雙方的優先順序與急迫性定義不同,導致關鍵漏洞持續卡在處理佇列中。這也是台灣企業既有 WSUS/SCCM 維運與變更窗口中常見的情境,資安與 IT 團隊往往都在等待適當的維護時段。

解決方式是在曝險獲得確認的當下立即進行控制。虛擬補丁(Patchless Protection)能在記憶體層阻擋漏洞利用路徑,不需要立即安裝正式補丁或重新啟動,讓 IT 團隊有時間安排正式補救,同時避免組織持續處於曝險狀態。

挑戰:發現項目數量過於龐大

探索階段會產生數千項發現。若缺乏以實際風險為基礎的優先排序,團隊將不斷進行分類,補救速度卻持續緩慢。

在發現項目進入處理佇列前先降低雜訊。將通用漏洞評分系統(CVSS)、漏洞利用預測評分系統(EPSS)與已知遭利用漏洞(KEV)資料結合資產情境,排除僅存在理論風險的項目。驗證則能再增加一層確認,判斷剩餘漏洞中有哪些確實能在特定環境內遭到利用。

挑戰:無法確認曝險是否已經消失

補丁已完成部署,工單也已關閉,但沒有人確認漏洞是否真的消失。錯誤組態、遺漏的資產或部署失敗,都可能使曝險持續存在。

將重新驗證納入工作流程。每一項已完成補救的漏洞都應重新測試,以確認補救確實有效。Vicarius vRx 會在資產層級確認補救成果,驗證每項漏洞已無法再遭利用。


證明持續威脅暴露管理(CTEM)計畫價值的指標

追蹤能夠證明成果的指標,而不是只衡量活動數量。已完成多少次掃描或建立多少張工單,無法告訴管理層風險是否正在下降。

重要指標

第一優先級(P1)曝險完成補救的比例,可顯示工作流程是否真正關閉關鍵缺口。從發現 P1 曝險到完成補救的天數中位數,可顯示作業流程是否具備足夠速度。驗證後遭到調降的曝險數量,則可證明驗證工作確實節省了補救資源。

範圍內資產已指派負責人的比例,可顯示組織是否具備推動處置的能力。每次循環中的曝險數量趨勢,則能顯示整體風險是否正在下降,而不只是發現更多問題。

應避免的指標

發現項目總數衡量的是數量,而不是價值。數量龐大可能代表範圍界定不佳,或工具產生過多雜訊。掃描次數衡量的是活動,而不是成果。建立的工單數量代表產生了多少工作,並不代表完成了多少工作。


Vicarius 如何支援持續威脅暴露管理(CTEM)導入

Vicarius vRx 透過單一平台涵蓋從探索到補救的流程,與持續威脅暴露管理(CTEM)架構相互對應。資產探索能找出應用程式、作業系統與第三方軟體中的漏洞。

風險導向優先排序(Risk-Based Prioritization)會將通用漏洞評分系統(CVSS)、漏洞利用預測評分系統(EPSS)與已知遭利用漏洞(KEV)訊號,結合資產關鍵性及業務情境排列漏洞。漏洞管理(Vulnerability Management)能力不只涵蓋掃描,也包含自動化補丁管理(Patch Management)、用於自訂補救的腳本引擎(Scripting Engine),以及保護零時差漏洞(Zero-Day)與舊版系統的虛擬補丁(Patchless Protection)。

閉環驗證(Closed-Loop Verification)會確認每一項補救成果,驗證漏洞確實已經消失,而不是假設問題已解決。依原文敘述,這種方法能將平均補救時間(Mean Time to Remediate, MTTR)縮短 60% 至 70%,並減少維持攻擊面持續縮減所需的人工投入。

了解 vRx 如何融入你的持續威脅暴露管理(CTEM)技術架構——申請產品展示。


建立支援持續威脅暴露管理(CTEM)的技術架構

持續威脅暴露管理(CTEM)是一套營運模式,而不是單一產品。然而,合適的工具能加速循環中的每個階段。

探索工具

需安裝代理程式的掃描工具(Agent-Based Scanner),以及透過網路進行遠端檢測的掃描工具(Agentless Scanner),可分別涵蓋不同類型的資產。以軟體物料清單(Software Bill of Materials, SBOM)為基礎的偵測,能找出特徵碼掃描工具遺漏的相依元件漏洞。外部攻擊面管理(External Attack Surface Management, EASM)工具則能識別對外曝露的資產。

優先排序工具

威脅情資(Threat Intelligence)來源會以漏洞利用機率與武器化狀態豐富常見漏洞與暴露(CVE)資料。資產關鍵性評分則為每項資產指派業務價值。風險評分引擎會整合這些輸入資料,產生可採取行動的優先順序。

補救工具

自動化補丁部署(Patch Deployment)負責處理例行更新。腳本引擎(Scripting Engine)將組態變更與自訂補救工作自動化。記憶體層級防護則涵蓋尚無補丁,或無法立即部署補丁時產生的缺口。


下一步:從小範圍開始,證明模式有效,再逐步擴大

導入持續威脅暴露管理(CTEM)不需要歷經多年的轉型。先針對明確領域啟動 90 天試行計畫。定義需要保護的對象、探索現有曝險、依實際風險排列優先順序、驗證可利用性,並推動補救工作直到完成。

完成一次能降低第一優先級(P1)曝險的循環,就能建立擴大導入所需的可信度。後續每次循環都會讓流程更加緊密:範圍界定更精準、探索更準確、優先排序更具依據、驗證更有效率,推動處置也更加可預測。

目標不是只完成一次五階段流程,而是隨時間加快每次循環並提高精準度,以可衡量的方式降低真正影響組織的曝險。


持續威脅暴露管理(CTEM)導入常見問題

CTEM 代表什麼?這套架構由誰提出?

CTEM 代表持續威脅暴露管理(Continuous Threat Exposure Management)。Gartner 提出這套五階段架構,協助組織透過範圍界定、探索、優先排序、驗證與推動處置,有系統地降低資安曝險。與週期性評估不同,持續威脅暴露管理(CTEM)採用持續循環,並隨著環境變化進行調整。

導入持續威脅暴露管理(CTEM)計畫需要多長時間?

一次聚焦特定範圍的試行循環約需 90 天。第 1 至 30 天進行範圍界定;第 31 至 60 天進行探索與優先排序;第 61 至 90 天進行驗證與推動處置。隨著團隊建立流程成熟度並精進工具,後續循環的執行速度會逐步加快。

持續威脅暴露管理(CTEM)與漏洞管理有什麼不同?

漏洞管理(Vulnerability Management)著重於找出軟體弱點。持續威脅暴露管理(CTEM)則著重於補救各種類型的曝險,包括錯誤組態、身分安全弱點與憑證外洩。Vicarius vRx 將漏洞探索、自動化補救、虛擬補丁(Patchless Protection)與閉環驗證(Closed-Loop Verification)整合,協助持續威脅暴露管理(CTEM)確認每一項補救成果。

持續威脅暴露管理(CTEM)的優先排序與通用漏洞評分系統(CVSS)有何不同?

通用漏洞評分系統(CVSS)衡量理論上的嚴重程度。持續威脅暴露管理(CTEM)的優先排序則會將 CVSS 與漏洞利用預測評分系統(EPSS)利用機率、CISA 已知遭利用漏洞(KEV)的實際利用資料、資產關鍵性及業務情境結合。這種方法會找出攻擊者正在鎖定、且存在於最關鍵資產上的漏洞,而不是只依一般嚴重程度排序。

什麼是驗證階段?為什麼它如此重要?

驗證會測試漏洞是否能在特定環境中遭到利用。它能確認補償性控制措施(Compensating Controls)是否如預期運作,以及補救是否已移除曝險。依原文敘述,Vicarius vRx 的驗證能力可減少 95% 的誤判,並讓工程團隊確信補救需求反映的是真實風險。

持續威脅暴露管理(CTEM)能與既有資安工具搭配使用嗎?

可以。持續威脅暴露管理(CTEM)是一套可與現有掃描工具、安全資訊與事件管理(Security Information and Event Management, SIEM)及端點偵測與回應(Endpoint Detection and Response, EDR)工具搭配使用的營運模式。Vicarius vRx 等平台能接收既有工具的訊號,將發現項目標準化並整合至單一處理佇列,再加入補救層,關閉從發現漏洞到完成補救之間的缺口。


立即聯絡我們  

資訊悅報 Vol.62|Bitdefender: AI 攻擊速度愈來愈快,IT 團隊如何在告警出現前減少可被利用的攻擊機會?

部落格來源網址:The New AI Arms Race Starts Before the Attack


新一波 AI 軍備競賽,在攻擊發生前就已開始

人工智慧正在形成一個企業必須保護的新 Attack Surface(攻擊面)。而多股力量彼此碰撞,也讓這個攻擊面變得更加複雜:

外部 AI 威脅(External AI Threats): 攻擊者正在利用 AI 提高攻擊速度、攻擊量,以及攻擊內容的個人化程度。

內部 AI 風險(Internal AI Risk): AI 的採用正在帶來新的曝險、連線關係與資料外洩風險,而這些變化的速度,已快到許多資安團隊難以及時治理相關風險。

如果企業面對這兩項發展,只是在可疑活動開始後產生更多 Alert,防禦方將陷入一場無法長期勝出的競賽。因此,新一波 AI 軍備競賽其實早在攻擊發生之前就已開始,企業需要具備 AI Visibility、Control,以及運用 AI 縮減 Attack Surface 的能力。


AI 生成惡意程式成長得有多快?

談到 AI 生成惡意程式,其成長趨勢正持續快速上升。

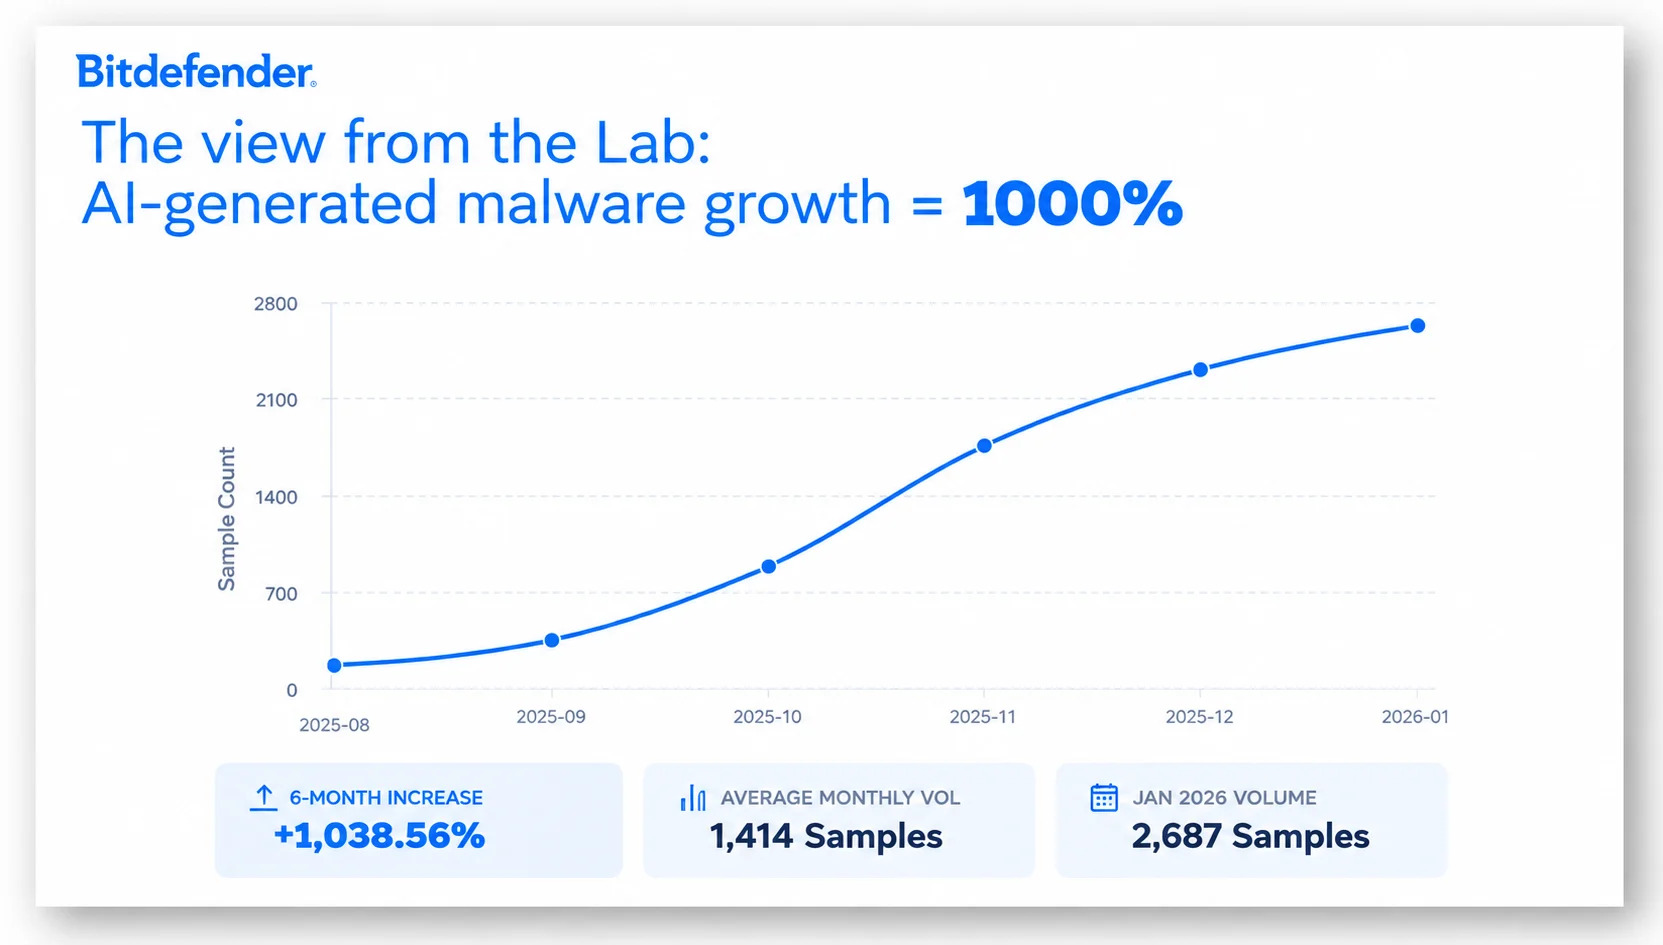
從 2025 年 8 月到 2026 年 1 月,Bitdefender Labs 追蹤到 AI 生成惡意程式樣本增加超過 1,000%。這是一個早期警訊,顯示攻擊者正在快速測試如何利用 AI 建立、修改並大規模擴展惡意程式碼。

資安團隊目前正在遇到哪些 AI 輔助網路攻擊?

根據 Bitdefender《2026 Cybersecurity Assessment》針對 1,200 名 IT 與資安專業人員進行的調查,59% 表示其組織曾遭遇他們認為涉及 AI 的 Social Engineering 攻擊,另有 56% 表示曾遭遇 AI 生成惡意程式所發動的攻擊。

更值得注意的是,70% 的受訪者表示,他們正看到由 AI 工具協助、且複雜程度持續提高的 Phishing 攻擊。

因此,53% 的受訪者認為,AI 對攻擊者帶來的幫助比對防禦方更多。


AI 輔助攻擊帶來的一項重大挑戰是什麼?

核心問題不只是防禦方能否偵測這些攻擊,更在於當攻擊能以機器速度產生、調整並發動時,企業是否還能繼續如此高度依賴 Detection & Response。


AI 如何從企業內部擴大 Attack Surface?

AI 工具的採用速度已經超前治理速度。資安團隊如今必須對一個可能連看都看不清楚、更難以持續一致控管的 Attack Surface 負責。

員工正在使用各式各樣的公開 AI 服務。許多原本已獲核准的工具,如今也開始加入 AI 功能。開發人員則透過 API,將模型與企業系統及資料連接起來。此外,也不能忽略一般使用者可能正在與 AI 分享的各種敏感資訊。

數據顯示,IT 與資安團隊正在面臨這項挑戰:Cybersecurity Assessment 發現,44.8% 的 IT 與資安專業人員對組織內部的 AI 使用情況只有部分可視性。而談到 2026 年的優先事項,根據這項研究,排名第一的是「建立全面性的內部 AI Governance」。


為什麼企業正在轉向 Prevention?

新一波 AI 軍備競賽需要重新平衡資安工作的優先順序,並將重心轉向 Prevention。Prevention-first 策略不再只問:「我們可以多快偵測到這次攻擊?」而是進一步問:「在 Threat Actor 採取行動之前,我們可以先移除多少攻擊機會?」

Detection & Response 仍然提供至關重要的安全網。Prevention 則能降低這張安全網真正必須接住威脅的頻率,同時降低攻擊造成實質損害的可能性。


內部 AI Visibility 是起點

從內部 AI 風險來看,Prevention 必須從 Visibility 開始。企業無法縮減一個自己根本看不見的 Attack Surface。

資安與 IT 團隊需要了解目前正在使用哪些 AI 服務、這些服務可以接觸哪些資料與系統,以及哪些使用行為帶來最高風險。如此一來,團隊就能依風險排定 Governance 優先順序,而不是採取員工可能設法繞過的全面性限制。

這也能讓企業運用目前可能已經具備的 Control。

Web Access Policy 可以處理高風險服務。Hardening Policy 可以減少容易遭利用的組態與不必要功能。Web Filtering 則可以限制對公開雲端模型及 Shadow AI 的存取。

目標不應該是阻止 AI 的採用,而是讓 AI 的採用變得可視、有明確規劃,而且更加安全,同時避免再建立另一套彼此孤立的資安計畫,增加更多工具、Console 與維運複雜度。


防禦方如何運用 AI 強化 Cyber Defense?

企業必須將 AI 納入現代化 Security Operations Center(SOC),或選擇在 SOC 中運用 AI 的 MDR 服務供應商。AI 能協助團隊分析 Signal、加速 Investigation、自動化重複性工作並更快速回應事件。隨著威脅速度持續加快、數量持續增加,這些能力也會變得愈來愈重要。

然而,AI 軍備競賽不會只靠建立更快速的 Detection 就能勝出。企業也必須運用 AI 驅動的工具來縮減 Attack Surface,並為每位使用者建立專屬的安全設定。

防禦方必須在 Incident 發生之前就運用 Intelligence:找出 Exposure、降低 Privilege、強化環境、治理 AI 使用方式,並持續移除潛在的 Attack Path。如此一來,企業才能改變攻防局勢,不再只是競相圍堵每一次 AI 輔助攻擊,而是從一開始就剝奪更多攻擊成功的機會。


延伸解法|PHASR 如何因應 AI 加速攻擊?

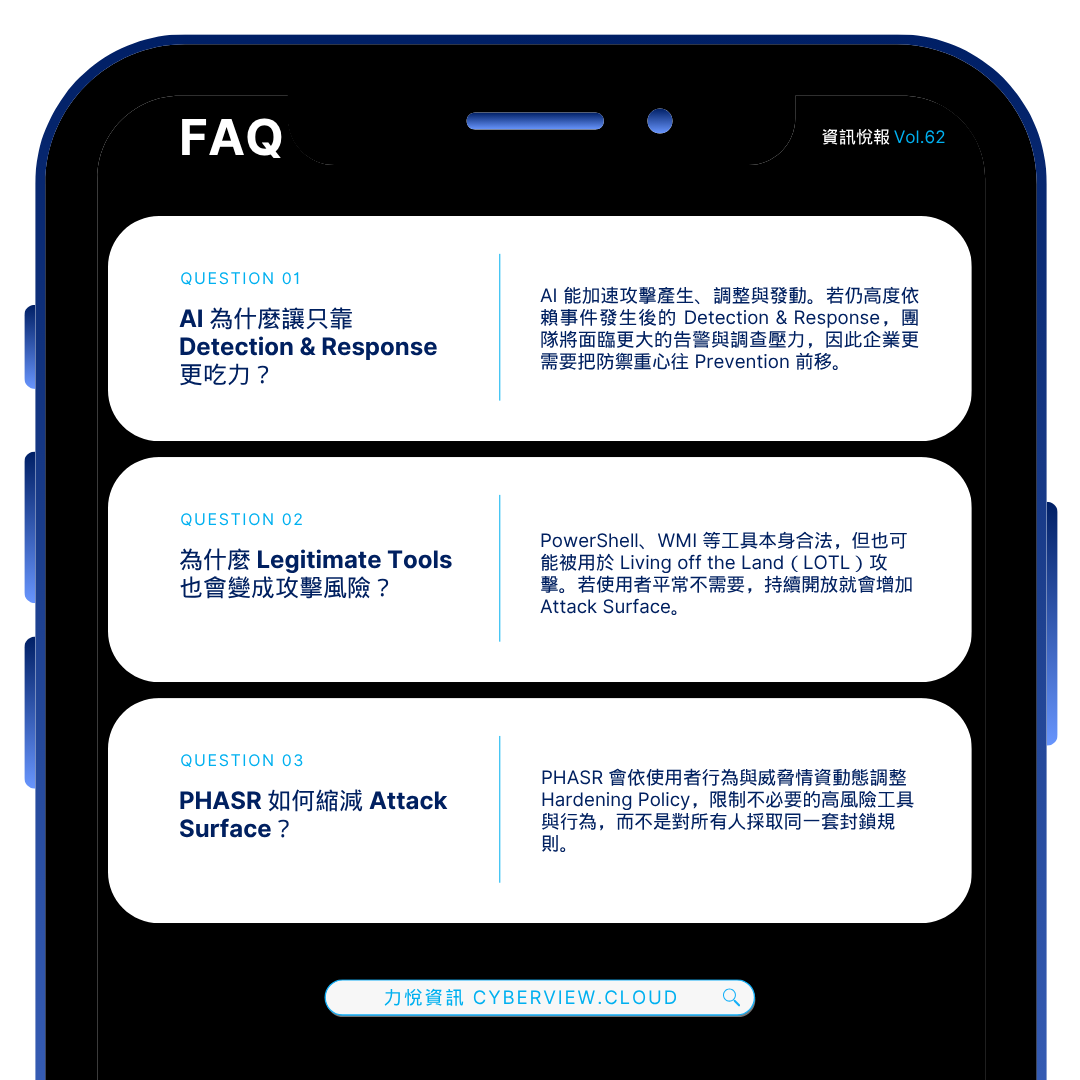
當 AI 讓攻擊產生、調整與發動得更快,企業不能只依賴事後的 Detection & Response。Bitdefender GravityZone PHASR 會依使用者行為動態調整 Hardening,限制不必要的高風險工具與 Attack Path,在攻擊發生前縮減 Attack Surface。

最新 GravityZone 6.77 更支援 PHASR for AI Agents,可將 AI Agent 與端點使用者分開控管;即使 Agent 需要 PowerShell,也不必同步放大人員權限。Autopilot 也新增人工覆寫機制,讓管理員可在必要時暫時調整限制,同時保留 PHASR 的自動化強化能力。

PHASR 關鍵亮點

  • 事前縮減 Attack Surface
  • AI Agent 與人員權限分流
  • 動態 Hardening,降低 LOTL 攻擊機會


立即聯絡我們  

資訊悅報 Vol.61|Idira:保護 AI Agent:強化 MCP 資料存取的控制與可視性

部落格來源:https://www.paloaltonetworks.com/blog/identity-security/secure-ai-agents-controls-visibility-mcp-data-access/


創新能發揮多少價值,取決於你擁有多少可視性。當組織快速導入 AI Agent,以自動化工作流程並提升生產力時,資安團隊卻往往被迫以機器般的速度前進,手上卻沒有完整的飛行計畫。AI Agent 具有非確定性的特性,代表 Agent 可能以難以預期的方式與組織系統及資料互動,也因此帶來新的安全風險。

AI Agent 是一種新的特權身分類型,它同時具有人類身分與機器身分的特性,可以自主採取行動,也能代表使用者存取企業敏感系統。保護這類身分,不能只依靠基本的伺服器端設定,而需要 Agentic AI 治理、身分代理,以及能跟上發展速度的 AI 最小權限存取控制。

當 AI Agent 執行任務時,往往會仰賴 Model Context Protocol,以下簡稱 MCP,Server 作為連接企業資料來源與系統的重要橋梁。然而,MCP 缺乏一致的身分驗證與安全控制,而且資安團隊甚至可能根本看不到它們。開發人員可以,也確實會從公開 Registry 下載開源或其他 MCP Server,讓自己的 Agent 存取資料來源。這些未受保護的 MCP,可能因此成為攻擊者鎖定的重要目標。

如果缺乏集中式可視性與受治理的存取控制,CISO 與資安團隊就無法清楚掌握 AI Agent 實際正在存取哪些目標資源,例如資料庫、雲端環境與 SaaS 應用程式。

以下將介紹 Idira™ Secure AI Agents 解決方案擴充後的功能,如何讓這些重要的橋梁不再隱藏於視線之外,協助資安團隊因應內部與外部資料存取控制的挑戰,並強化 MCP Server 的安全。


為什麼 MCP 的基本安全控制還不夠?

許多組織目前仍只依賴 MCP Server 原生內建的安全設定。這些原生控制可以探索 MCP Server 或監控 Agent 活動,但未必能提供企業所需要的可視性、身分脈絡或存取治理能力。原因如下:

  • 缺乏原生身分驗證: 實際環境中有大量 MCP Server,例如內部開發工具或社群原型,本身完全沒有內建身分驗證。例如,Bloomberry 的研究發現,38% 的 MCP Server 沒有任何身分驗證機制。
  • 身分盲區: 即使 MCP Server 使用原生 OAuth 2.1,也就是許多應用程式用來授予有限資料與系統存取權的標準授權框架,它仍可能只驗證人類使用者所委派的同意。AI Agent 本身對身分與存取管理系統,也就是 IAM,仍然不可見,因此資安團隊更難治理 Agent,也更難將實際操作快速追溯到特定 Agent。
  • 長效 Token: 原生 OAuth 2.1 的設定可能讓長效 Access Token 與 Refresh Token 持續保存在 AI Agent 端。如果 Agent 發生記憶體遭入侵或 Prompt Injection,這些常駐 Token 就可能被竊取並遭到濫用。
  • 政策碎片化: 採用原生身分驗證時,每一台 MCP Server 都可能自行決定安全 Scope、Token 存續時間與 Audit Log。如果一家企業使用 10 台不同的 MCP Server,資安團隊就被迫管理 10 套彼此完全分離的政策與合規介面。

未受管理的 MCP Server 也可能形成新的風險路徑。它們可能讓 Agent 更容易受到 Prompt Injection 影響,也就是惡意程式碼被注入 Prompt,進而劫持 Agent。此外,也可能涉及 供應鏈攻擊 與憑證竊取,例如下載的 MCP 含有惡意程式碼,用來竊取憑證,或之後透過「rug-pull」式更新重新引入風險。另一項需要關注的風險是 權限提升,權限範圍過大的 Token 可能讓攻擊者直接轉向資料庫與程式碼儲存庫。

在更嚴重的情況下,未受管理的 MCP Server 也可能暴露於 遠端程式碼執行,RCE 的風險,被滲透的 MCP Server 可能成為對本機發動 RCE 攻擊的入口,也可能讓遭入侵的 Agent 擷取敏感資料。

簡單來說,差異就在於控制。例如,原生 MCP 安全機制往往會讓可視性、身分驗證與存取決策分散在個別 Server 上;Secure AI Agents 則透過以身分為核心的平台方法,協助集中這些控制。

如果無法清楚掌握哪個 AI Agent 代表哪位使用者、具有哪些權限,以及對哪些資源採取了哪些行動,資安團隊可能很難安全限制 Agent 的存取,也難以控制 Agent 能透過 MCP Server 執行哪些特定工具。


如何透過身分導向方法保護 MCP Server

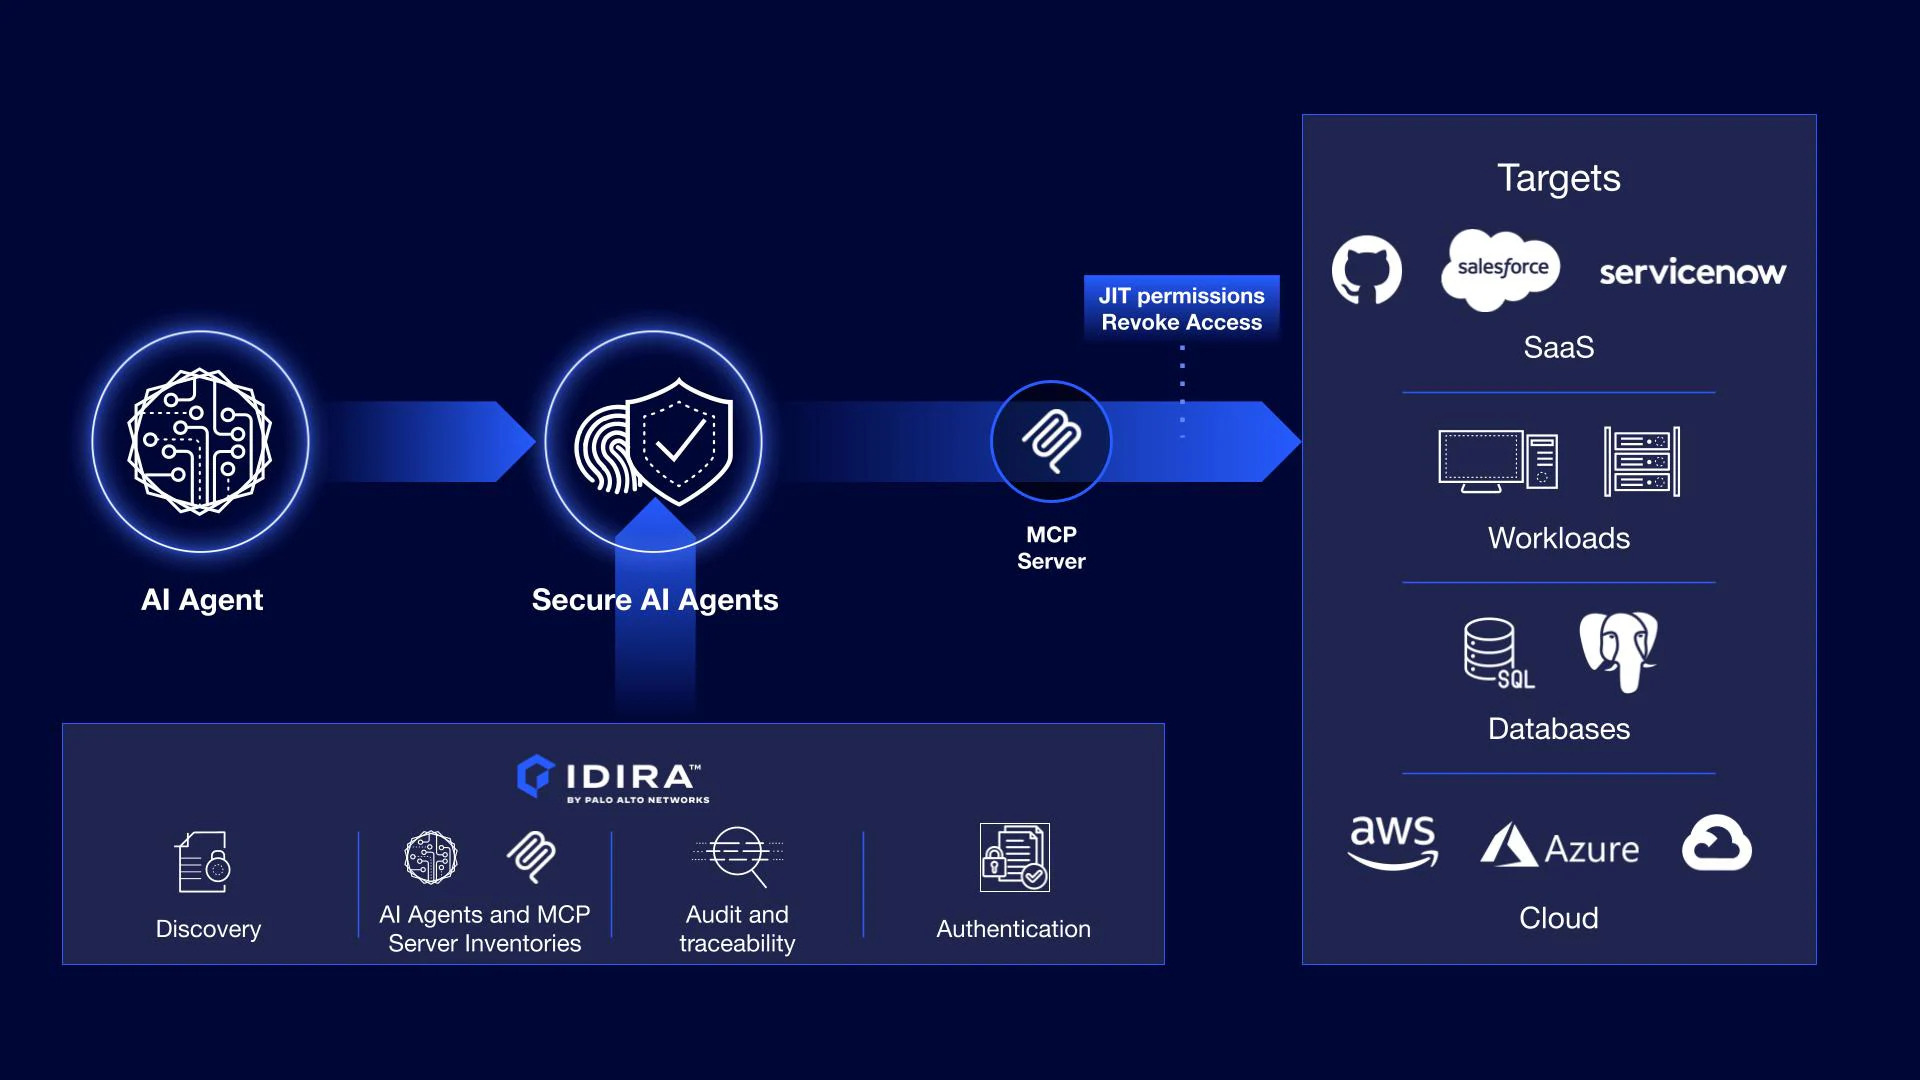
MCP Server 是 AI 模型與 Agent 存取外部資料來源及工具時的重要橋梁。在這類情境中,Secure AI Agents 位於 AI Agent 與遠端 MCP Server 之間。

現在,Secure AI Agents 解決方案可以擔任 MCP 的授權伺服器。Agent 不需要直接持有存取 MCP 所需的憑證,Agent 的通訊會先經過 Secure AI Agents,由平台扮演 Agent Identity Broker,再安全地將請求代理至目標 MCP Server。

這改變了控制點。資安團隊可以從逐台 Server 管理分散的 MCP 存取,轉變為將集中式身分安全控制套用到 Agent 活動上。

例如,當 Agent 完成註冊,並代表使用者透過 OAuth 2.1 向 Identity Broker 驗證身分後,Secure AI Agents 可以協助集中授權,而不是讓存取決策持續分散在個別 MCP Server 上。

將 MCP 活動導向 Identity Broker,可以協助組織在非確定性的 AI 環境中套用確定性的控制,讓敏感資料的存取維持在受治理且可稽核的狀態。


全新擴充功能進一步強化 MCP 安全

Secure AI Agents 可協助資安團隊為 Agentic AI 建立秩序,從單一解決方案探索 Agent、治理 MCP 存取、監控活動,並執行身分安全控制。以下說明它如何提供團隊安全創新所需要的防護機制。

1. 透過集中式清冊與探索,看見更多資訊

要管理 AI 快速擴張,包括 Shadow AI Agent,以及隱藏與未受管理的 MCP Server,第一步就是先知道環境中存在什麼。Secure AI Agents 提供企業內 AI Agent 的統一視圖,不論這些 Agent 是建置在 AWS、Azure、Copilot 或 Claude 上。

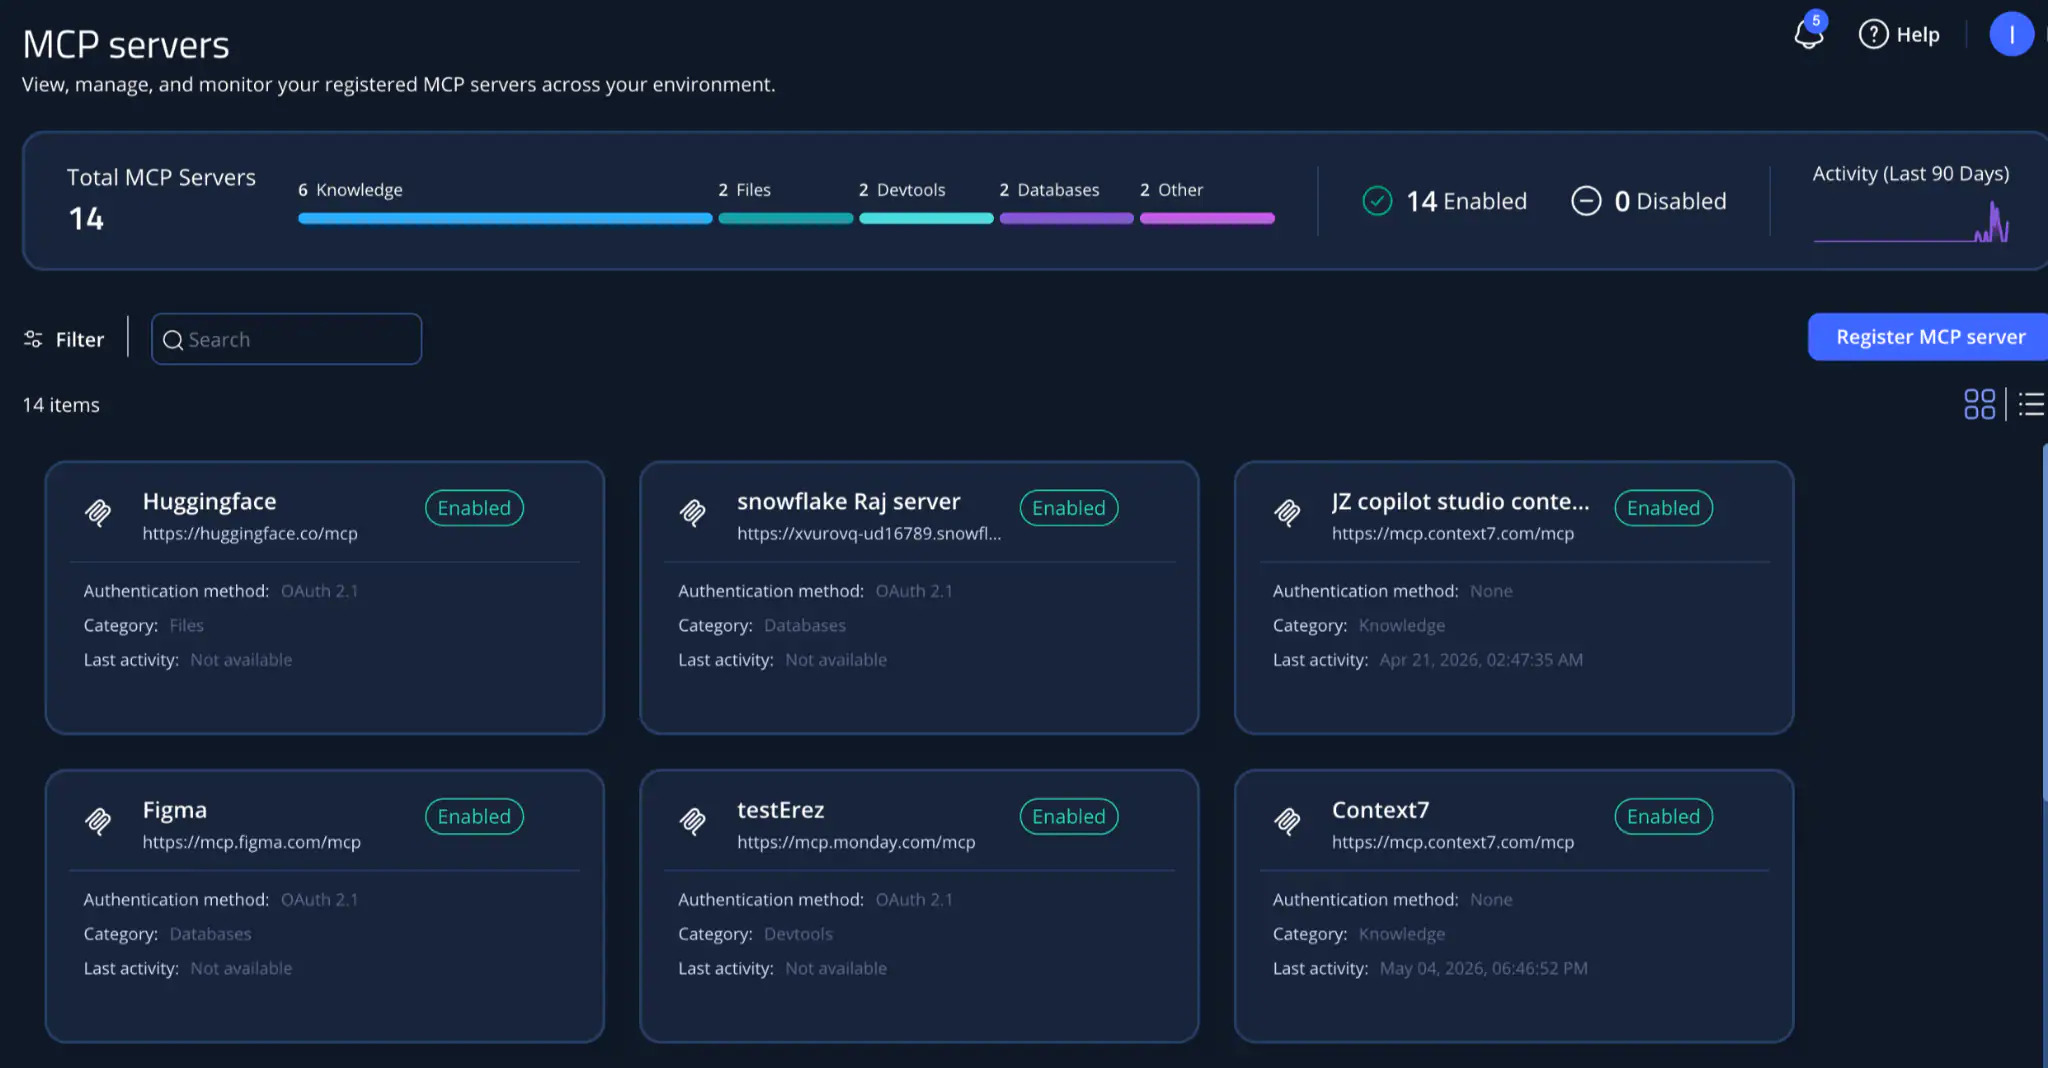
組織現在可以建立遠端 MCP Server 清冊,查看目前正在使用哪些 MCP Server、它們最後一次通訊的時間,並辨識哪些 AI Agent 正等待連線,或尚未設定負責人。

這種可視性也能協助資安團隊成為創新的推動者,建立一份經核准的 MCP Server 清單,讓開發人員知道哪些 MCP 可以安全地提供給 Agent 存取。

MCP Server 儀表板可用來查看、管理並監控整體環境中已註冊的 MCP Server。

2. 透過深度稽核與工作階段監控追蹤 AI Agent

當所有流量都透過 Secure AI Agents 傳遞後,資安團隊可以取得更強的 Agent 活動追溯能力。系統的設計會為每一次互動產生詳盡的稽核軌跡,協助團隊了解 AI Agent 存取了哪一台 MCP Server,以及 AI Agent 實際呼叫了哪些工具或執行哪些動作。

當 Agent 出現非預期行為時,這可以提供資安團隊所需的可視性,協助團隊更快速地調查與回應。

3. 透過受治理的 MCP 存取來控制連線

Secure AI Agents 的核心設計理念之一,是讓開發人員,也就是 Builder,能持續發揮創新能力,同時不犧牲安全。

現在,Builder 可以,而且必須主動註冊新的遠端 MCP Server,才能與 Agent 整合。為了落實嚴格治理,完成 MCP Server 註冊後,系統會先將其設為「停用」狀態。接著必須由資安管理者進行審查,並明確將允許使用的 MCP 標記為「啟用」,AI Agent 才能與它建立連線。

這種做法建立了一套 Human-in-the-loop 的人工核准流程,協助資安團隊維持控制,同時也讓開發人員擁有一條清楚的導入路徑。

4. 透過不受雲端與 Agent 限制的設計,讓 Agent 在任何環境運作

此解決方案的設計具備高度彈性,可以因應持續演進的 AI 環境。無論資安團隊使用 Google、Microsoft 或自行開發的解決方案,Secure AI Agents 都支援不同類型的 AI Agent 連接任何遠端 MCP。隨著 Agentic AI 的採用範圍持續擴大,這能協助組織套用一致的身分安全控制。

Secure AI Agents 提供可視性,並協助建立存取控制。


安全地推進 Agentic AI

AI Agent 是一種快速崛起且功能強大的新型身分,可以代表使用者採取行動,也可以自主運作。

Secure AI Agents 可協助企業套用強化的身分安全控制,例如 JIT 即時權限與嚴格的最小權限原則,將原本可能形成的安全盲區,轉變為更容易管理且可稽核的環境。這讓企業可以更有信心地發揮 AI Agent 的能力,同時不失去對最敏感資料的控制。

這些功能目前已開放給 Secure AI Agents 解決方案的客戶與 Design Partner 使用。想實際看看如何運作?歡迎參加 Webinar:Extend Agentic Identity Security to any MCP Server。

希望進一步針對自身需求討論?與專家聯繫。


FAQ

Q1:MCP Server 主要有哪些安全風險?

主要風險包括缺乏原生身分驗證、身分盲區、長效 Token、政策碎片化,以及 Prompt Injection、憑證竊取與權限提升等威脅。如果缺乏集中式治理,資安團隊可能無法掌握哪些 Agent 正在存取哪些系統、具有哪些權限,或是代表哪些使用者執行操作。

Q2:Secure AI Agents 如何提升 MCP 安全性?

Secure AI Agents 的設計是作為 AI Agent 與 MCP Server 之間的控制點。例如,不讓 Agent 直接持有 MCP 憑證,而是由 Secure AI Agents 代理請求、集中授權、支援更強的稽核能力,並協助資安團隊執行存取政策。

Q3:Secure AI Agents 是否能支援不同的雲端與 Agent 環境?

可以。Secure AI Agents 的設計可支援不同類型的 AI Agent 與遠端 MCP Server,包括 AWS、Azure、Copilot、Claude,以及自行開發的解決方案。


立即聯絡我們  

資訊悅報 Vol.60|RE:FORM DEPLOY: 企業愈大,數位轉型反而愈容易失敗?IT 團隊如何降低跨部門部署風險

部落格來源:9 Most Fascinating Digital Transformation 


9 個最引人入勝、值得借鏡的數位轉型案例

數位轉型將在 2025 年持續成為最重要的商業趨勢之一,全球相關支出預計到 2027 年將接近 4 兆美元。[1] 令人意外的是,研究顯示,每三項數位轉型計畫中,只有一項成功。

究竟是什麼驅動成功的數位轉型?本文將深入探討橫跨零售、銀行、餐飲、物流與消費品等領域的 9 個引人入勝的數位轉型案例。這些令人耳目一新的數位轉型策略,或許能啟發您的企業借鏡其思考方式。現在就讓我們開始。

內容概述

  • 什麼是數位轉型
  • 2025 年數位轉型的四大核心領域
  • 6 個數位轉型策略成功案例
  • 3 個值得借鏡的數位轉型失敗案例
  • RE:FORM 如何為您的數位轉型帶來效益

什麼是數位轉型?

數位轉型(Digital Transformation,簡稱 DX)是企業思維模式的根本轉變,旨在將數位工具與解決方案整合至企業的各個層面。這種「數位優先」的方法不只是採用新的軟體,更要求企業全面重新想像流程、商業模式與客戶體驗。最終目標是運用數位技術,為客戶、員工與企業創造新的價值。


2025 年數位轉型的 4 大核心技術

數位轉型涵蓋一系列正在重塑企業營運方式的技術。根據 IBM 的說法,企業正「愈來愈仰賴資料分析與自動化,以提升獲利能力與客戶滿意度」。[2]

以下是引領下一波數位轉型浪潮的 4 大核心技術:

  1. 人工智慧/機器學習: 這些技術模擬人類智慧,使企業能夠進行即時、資料驅動的決策。應用範圍包括客服聊天機器人、個人化廣告,以及 DevOps 中的自動化。
  2. 混合運算: 將地端基礎架構與雲端解決方案結合,可提供彈性、擴充性與安全性。例如,它支援將工作負載移轉至雲端,同時將關鍵資料保留於地端以因應法遵稽核,並有助於實施災難復原策略。
  3. 資料分析: 透過運用進階資料分析能力,企業可以辨識並預測趨勢、提升營運效率,並推動成長策略。
  4. 物聯網(IoT): IoT 裝置負責蒐集並交換資料,進而自動執行預先定義的動作。例如,智慧感測器可以提升空間利用率,並控制購物中心等室內空間的濕度與溫度等環境因素。

6 個最佳數位轉型成功案例

近年來,無論是歷史悠久的傳統品牌還是市場新秀,都紛紛擁抱創新,以在競爭中保持領先。以下是 6 個出色的數位轉型成功案例,它們不僅讓企業重獲新生,更將企業推向數位時代的新高度。


1. 銀行業數位轉型案例:星展銀行(DBS Bank)

星展銀行的數位轉型成果在金融產業獲得了高度肯定。在過去十年間,他們獲得了多項殊榮,包括「全球最佳銀行」與「全球最佳數位銀行」。

以下是星展銀行幾項值得關注的數位轉型應用:

  • 推出 digibank 行動應用程式等數位平台,為客戶提供流暢的線上銀行服務。此項措施顯著提升了客戶滿意度與參與程度。
  • 建立創新且以技術為核心的企業文化,鼓勵員工保持敏捷並持續創新。這項文化轉型持續推動銀行的數位計畫向前發展。
  • 導入 AI 與機器學習,以改善營運與客戶體驗。例如,星展銀行開發 AI 驅動的解決方案,以簡化流程並提升效率。

星展銀行的數位轉型成果不僅為其贏得產業獎項,也提升了品牌聲譽與客戶滿意度;該銀行股價在 2020 至 2024 年間上漲近 80%,[3] 這在很大程度上歸功於其令人印象深刻的數位化進展。


2. 金融業數位轉型案例:摩根大通(JPMorgan Chase)

摩根大通積極採用 AI 與機器學習技術,用於偵測詐欺、評估風險,以及為客戶提供個人化的財務建議。他們的技術創新同時延伸至內部與外部,為客戶與員工帶來重大影響。例如:

  • 他們的 COiN(Contract Intelligence,合約智慧)平台將法律文件的審查與解讀自動化,把原本需要 360,000 小時完成的工作縮短至數秒。
  • 他們將 AI 與機器學習應用於 300 個使用案例,並於 2023 年創造超過 15 億美元的商業價值。[5]
  • 他們持續投入技術轉型,於 2024 年編列 170 億美元預算,聚焦於核心平台現代化,以及開發推動創新的解決方案。[4]

摩根大通對數位轉型的策略性投資,使其成為技術驅動型金融服務的領導者,為客戶創造實質的商業價值與營運效率。


3. 零售業數位轉型案例:星巴克(Starbucks)

星巴克將飲品點購轉化為更個人化、有趣且具親近感的體驗。他們的數位轉型聚焦於提升客戶參與與營運效率,同時成功支撐穩定的業務成長,而沒有讓營運成本大幅攀升。以下是幾個例子:

  • 行動應用程式與會員獎勵計畫: Starbucks 行動 App 整合點餐、付款與獎勵計畫,提供個人化體驗與促銷活動。這項策略提高了客戶忠誠度,也簡化了交易流程。
  • 人工智慧整合: Starbucks 利用 AI 改善庫存管理並提供個人化客戶互動,進而提升服務效率與滿意度。
  • 數位飛輪策略(Digital Flywheel Strategy): 透過聚焦於獎勵、遊戲化、個人化,以及便利的付款與點餐體驗,Starbucks 將數位與實體的客戶互動整合在一起,進而推動成長並提高客戶留存。

4. 零售業數位轉型案例:樂高集團(LEGO Group)

擁有 92 年歷史的樂高集團,在數位轉型策略的推動下,成功重新活化品牌並擴大市場版圖。

除了開發數位平台與應用程式,提供創新的數位遊戲體驗之外,LEGO 也大幅投資數位解決方案,以支持其永續發展目標。例如,他們利用資料分析改善供應鏈並降低環境衝擊。這與其實現「零衝擊(zero impact)」目標的願景一致。[6]


5. 保險業數位轉型案例:安盛集團(AXA)

AXA 的數位轉型顯著提升了其服務與營運效率。他們尤其投入大量資源發展雲端與混合式解決方案。以下是他們已實施並帶來改變的幾項重要行動:

  • 運用即時資料與分析: 衛星、無人機與感測器負責蒐集資料,以強化 AXA 在風險預防與理賠能力方面的專業知識。[7]
  • Move to the Cloud 計畫: AXA 啟動一項全球計畫,將資料與應用程式移轉至雲端,以提高彈性、擴充性與安全性。該計畫同時支援 AI 與聊天機器人等創新技術的導入。[8]
  • 數位理賠解決方案: AXA 推出數位理賠解決方案,為汽車保險客戶提供流暢的端到端數位體驗。透過更快速、更有效率的理賠處理,這項發展提升了客戶滿意度。

6. 物流業數位轉型案例:Lalamove

最後,Lalamove 的數位轉型將其推向物流產業的前線。其中尤其值得關注的是,Lalamove 的 API 整合提升了公司的營運效率與溝通能力。推動成功的核心措施包括:

  • 行動應用程式平台: Lalamove 開發了一款使用者友善的行動 App,即時媒合客戶與配送司機。[9] 該平台提供即時訂單配對、即時追蹤與多種付款方式等功能,進而提升使用者體驗與營運效率。
  • 資料分析與最佳化: Lalamove 利用資料分析改善配送路線並提升效率。透過分析交通模式與配送資料,Lalamove 得以縮短配送時間並降低營運成本。

這些數位措施強化了 Lalamove 在物流產業中的地位,並促成近年營收與市場占有率的顯著成長。


3 個值得借鏡的數位轉型失敗案例

並非所有的數位轉型努力最終都能成功。相較於中小企業與新創公司,大型組織往往更難成功完成數位轉型。

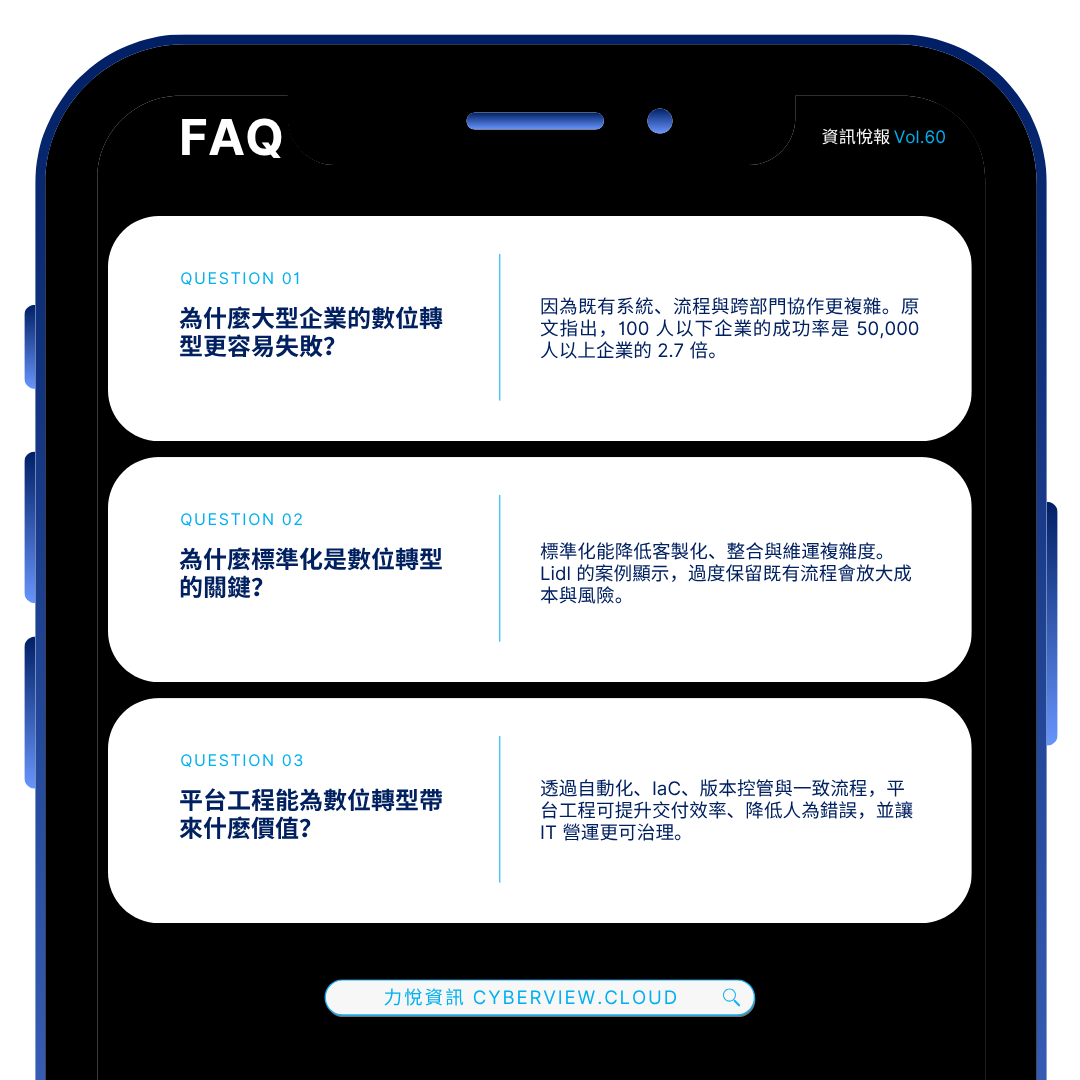
研究顯示,員工人數在 100 人以下的企業,其數位轉型成功機率,是擁有 50,000 名以上員工大型企業的 2.7 倍。[10]

為什麼這些計畫會失敗?我們又能從它們的挫敗中學到什麼?以下將透過 Haribo、McDonald’s 與 Lidl 的案例,了解其策略為何未能達成預期成果。


Haribo:規劃不足導致小熊軟糖短缺

這家以熊形軟糖聞名的糖果大廠,在嘗試導入數位轉型流程以簡化營運時,遭遇了明顯挑戰。最終,由於規劃不足與員工訓練不充分,轉型計畫宣告失敗,進而造成庫存追蹤混亂、原料交付延誤,以及其他供應鏈中斷問題。2018 年的一段期間,其知名小熊軟糖甚至出現供應短缺。

這些問題在轉型後不久造成銷售量下滑 25%,[11] 凸顯大型數位專案中,充分準備與員工訓練的重要性。


McDonald’s:AI 失敗,竟把培根加進冰淇淋

還記得 2024 年那場讓這家餐飲連鎖巨頭陷入停擺的全球技術中斷嗎?從洛杉磯到東京,客戶一度無法點餐與付款,造成重大的銷售損失與聲譽衝擊。但這並非單一事件。這家大型速食連鎖企業近期也曾嘗試將 AI 驅動的點餐系統導入得來速,但最終失敗,導致該計畫終止。

該 AI 系統不但沒有簡化點餐流程,反而經常誤解客戶的訂單,導致錯誤,例如把培根加進冰淇淋。

多次失敗背後的核心原因,歸結於基礎架構可靠性不足與系統整合問題。測試不足,以及缺乏簡便的回滾機制,也進一步阻礙了其數位轉型進程。


Lidl:缺乏標準化,導致 5 億歐元的失敗

平台工程與數位轉型所帶來的最大效益之一,就是標準化。德國折扣零售巨頭 Lidl 在過去的數位轉型過程中,未能有效運用標準化的優勢。他們於 2011 年啟動一項耗資 5 億歐元的專案,希望汰換既有的庫存管理系統。然而,由於幾項關鍵挑戰,該計畫於 2018 年遭到放棄,最終促使這家超市巨頭決定回到原有系統。

導致失敗的關鍵因素

對流程標準化的抗拒: Lidl 傳統上以進貨價格評估庫存,但這與 SAP 採用零售價格的標準作法產生衝突。Lidl 堅持維持既有流程,因此必須進行大量軟體客製化,進而增加系統複雜度與成本。

資料遷移挑戰: 從舊系統移轉至 SAP,需要極為嚴謹的資料準備。Lidl 在這方面面臨相當大的困難,最終造成系統整合問題與效率不佳。


如何透過 RE:FORM 從數位轉型中獲益

數位轉型始於規模小、可管理的步驟。以下是 RE:FORM 如何協助您加速數位化進程的方式:

1. 更快速部署軟體、應用程式與基礎架構

RE:FORM 可協助您將部署速度提升至 5 倍,將部署時間縮短至數分鐘,並將產品上市時間(Time-to-Market)縮短 50%。透過自動化、簡化 CI/CD 流程,以及工具與整合方式的標準化,我們已協助企業客戶實現流暢的轉型。

2. 標準化與自動化

RE:FORM 在 CD 流程中提供完整自動化、快速回滾、版本控管、Everything as Code(一切皆程式碼)、透明的稽核軌跡,以及即時效能監控等功能,以加快回饋與更新的落實速度。

3. 資料驅動決策

透過 RE:FORM 衡量與追蹤 DevOps 效能的能力,企業得以即時取得可採取行動的關鍵洞察。藉由集中且可客製化的儀表板,您的業務、技術、維運與資安團隊都能從實證型洞察中受益,進而簡化決策流程。

4. 節省成本

透過自動化營運流程並減少人為錯誤,RE:FORM 能在提升團隊能力的同時降低成本。由於 RE:FORM 可降低技術門檻並縮短新進人員上手時間,因此能減輕遇缺不補、高流動率或其他人才斷層問題帶來的影響。RE:FORM 能提升團隊效率並釋放更多組織潛力,而無需額外增加人力。

5. 無縫整合與擴充能力

在獲獎團隊的支援下,RE:FORM 能確保與企業既有系統流暢整合,使您的企業得以改善資源配置並更快速擴充,以輕鬆因應市場需求與客戶需要。


正在尋找智慧型 DevOps 與平台工程工具嗎?

數位轉型不是維他命,而是一條生命線。隨著我們邁向 2025 年,未能意識到轉型與採取行動迫切性的企業,勢必將被拋在後頭。

RE:FORM 已透過平台工程成功協助企業以 5 倍速度部署與交付應用程式、軟體及基礎架構,同時確保程式碼完全由企業內部自主掌握。

如果您正在尋找一套智慧型 DevOps 與平台工程工具,協助企業在數位轉型時代持續發展,請聯絡 RE:FORM,以取得更符合需求的解決方案。


立即聯絡我們  

資訊悅報 Vol.59|Vicarius: 單一掃描方式看不完整?企業如何補齊資產盲區,掌握完整風險全貌?

部落格來源網址:https://www.vicarius.io/articles/why-agentless-agent-based-scanning-together-create-a-complete-risk-picture


為什麼結合不同掃描方式,才能看見完整的企業風險全貌?

您的漏洞管理計畫品質,完全取決於它能看見什麼。如果您在複雜的企業混合環境中只執行單一掃描手法,將會有整個類別的資產落入完全看不見的盲區。

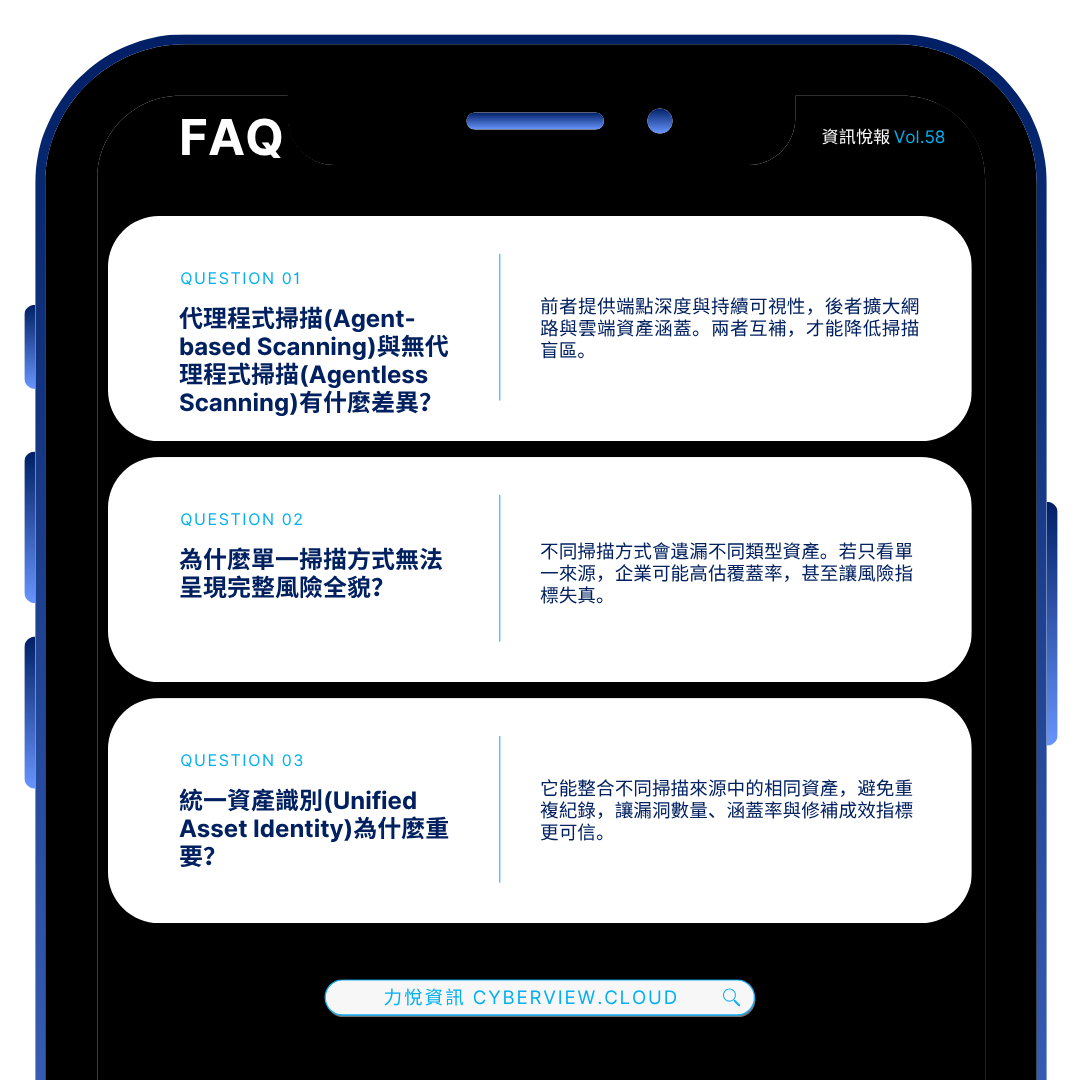
這並非廠商的業務話術。這是由每種掃描方式的運作原理所導出的結構性問題。代理程式掃描(Agent-based Scanning)能針對已部署代理程式的受控系統,提供深入且持續的可視性;另一種掃描方式則可針對透過網路或雲端 API 觸及的資產,快速擴大涵蓋範圍。兩種方法都無法完全涵蓋另一方的能力範圍,而且各自遺漏的資產類型並不相同,往往正是風險最容易被忽略的地方。

資安長(CISO)在評估漏洞管理平台時,在考慮其他條件之前必須先問一個問題:這個工具看見的是我的整個攻擊表面,還是只是我本來就已經維運得很好的那一部分?


每種方法的具體運作方式

代理程式掃描(Agent-based Scanning)的運作方式是直接在每個主機上執行軟體,賦予其存取設定檔案、執行中程序以及檔案系統資料的特權權限。相反地,無代理程式掃描(Agentless Scanning)則使用雲端供應商的 API、磁碟快照以及網路協定,從外部評估系統;它們絕不會登入機器或在機器內部執行程式碼。

實際上的差異在於:無代理程式工具更偏向回答「哪些資產可能遭受攻擊」,而代理程式掃描(Agent-based Scanning)則能在執行階段(Runtime)提供更深入的威脅偵測與行為分析,持續掌握主機實際發生的活動。


修正後的覆蓋率全貌

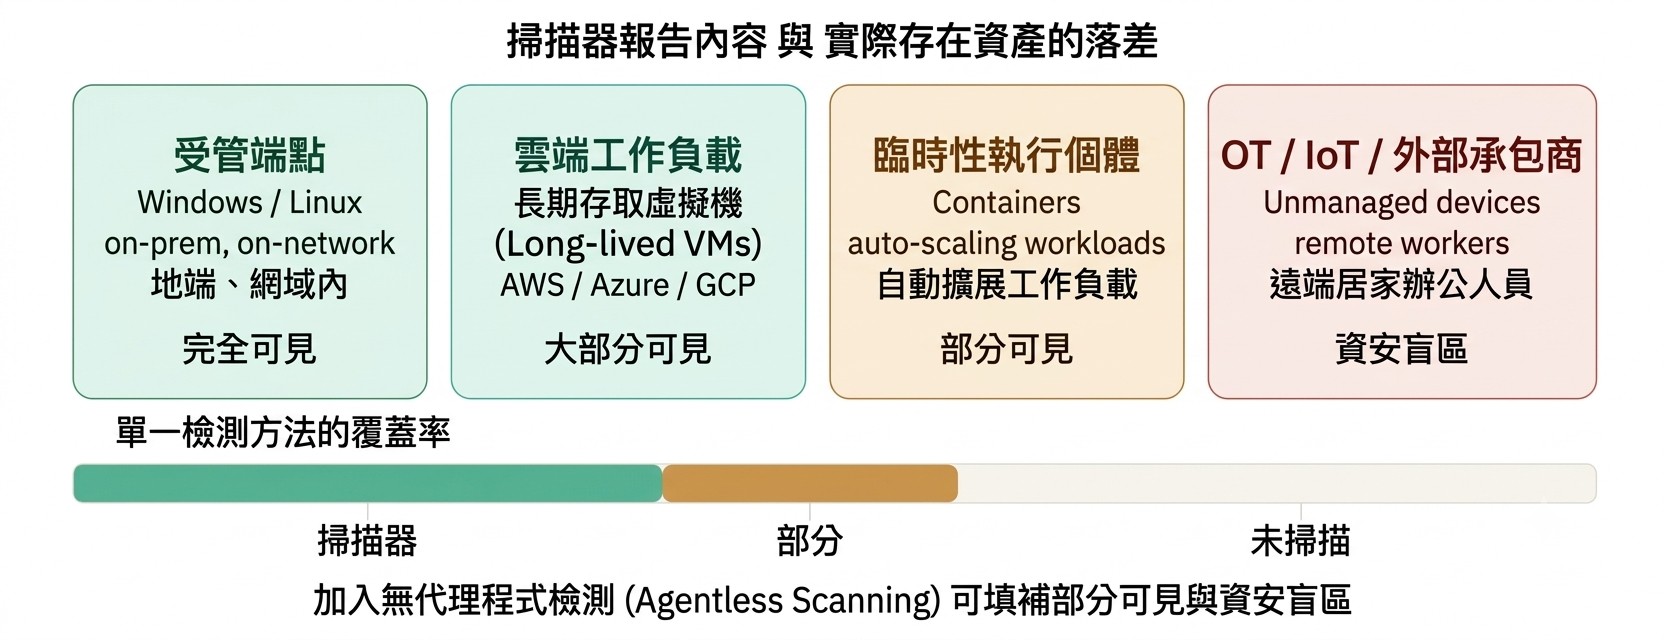
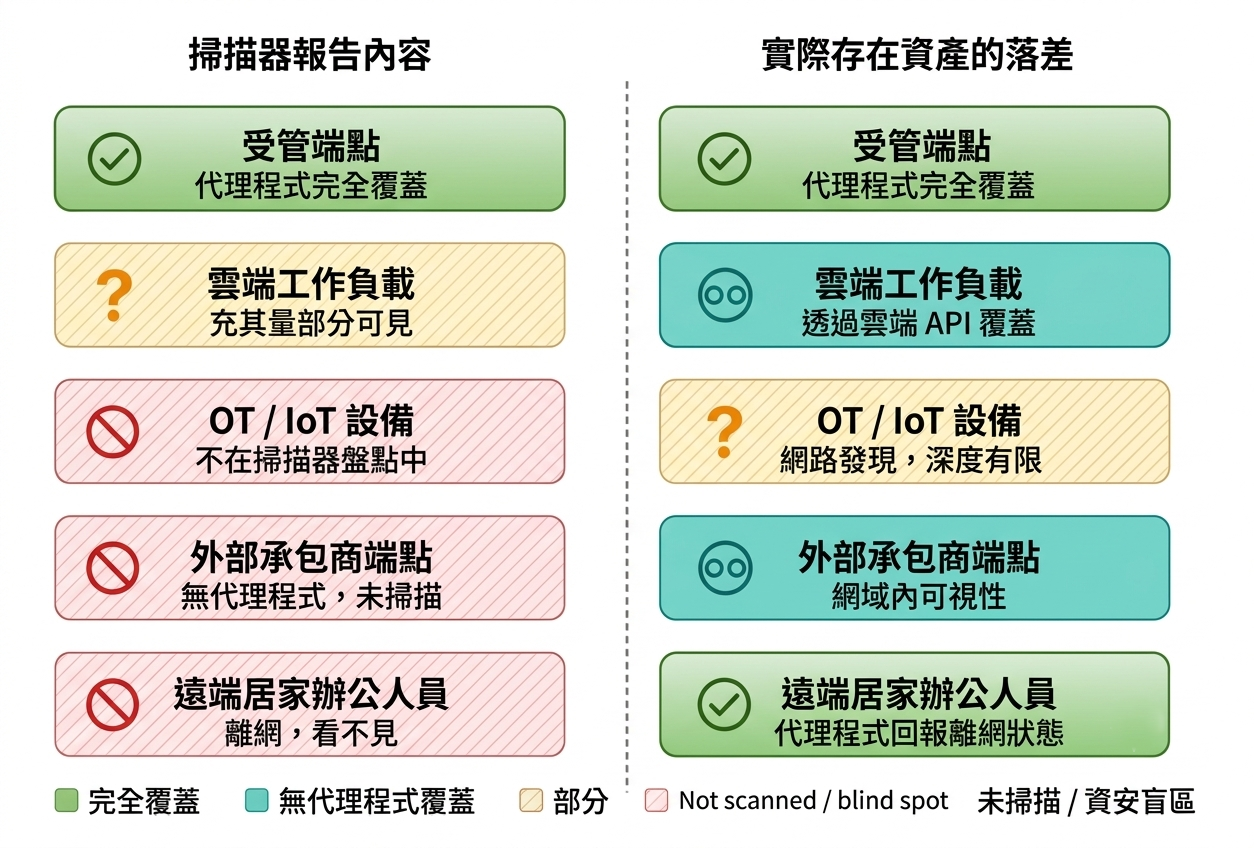
這場討論往往建立在過度理想化的假設上。以下是研究在不同資產類別中所呈現的實際涵蓋情況,以及其中不可忽略的細微差異:

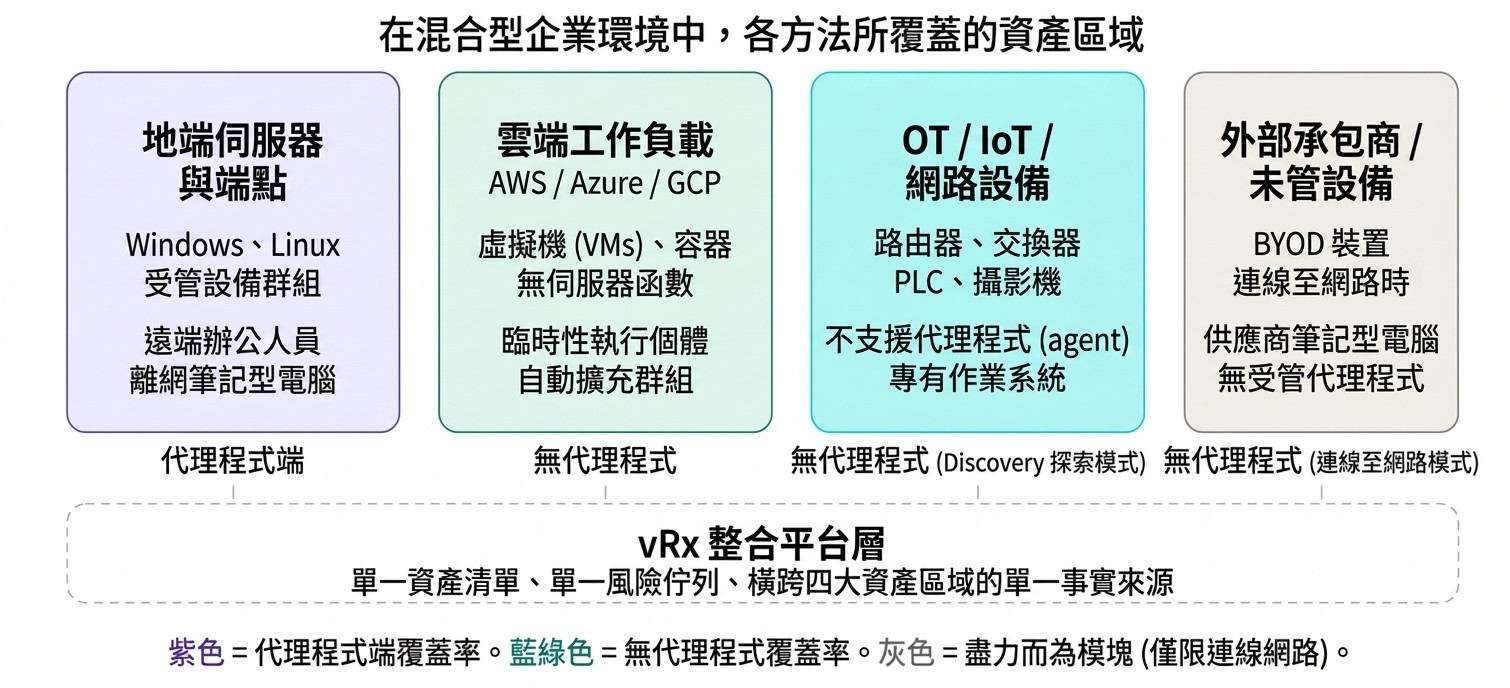
有兩項修正值得從原始表格中明確指出。第一,遠端與離網端點(例如家用網路背後的筆記型電腦):這類資產對於無代理程式掃描而言完全是隱形的。無代理程式掃描需要持續的網路連線,這使其不適用於遠端工作者,因為掃描器無法觸及他們在家用網路背後的設備。在 2020 年之後的勞動力結構中,這是一個極其重要的細微差異。第二,OT 與 IoT 設備:無代理程式掃描可以識別 IoT 設備以及路由器和交換器等網路設備(這些設備沒有支援代理程式的作業系統),這類設備並非都能被完整「發現(Discoverable)」,而是只能達到網路層級可見(Network-visible)。除非能進行經身分驗證的掃描(Authenticated Scan),否則取得的漏洞資料深度通常不如標準端點;即使如此,結果仍受到掃描週期影響。

例如在台灣常見的 IT 維運情境中,當員工將公司配發的筆記型電腦帶回家中工作,且未連回企業 VPN 時,傳統的網路掃描便會完全斷線,這時就必須仰賴代理程式掃描(Agent-based Scanning)才能確保資安防禦不中斷。


容易被利用的盲點

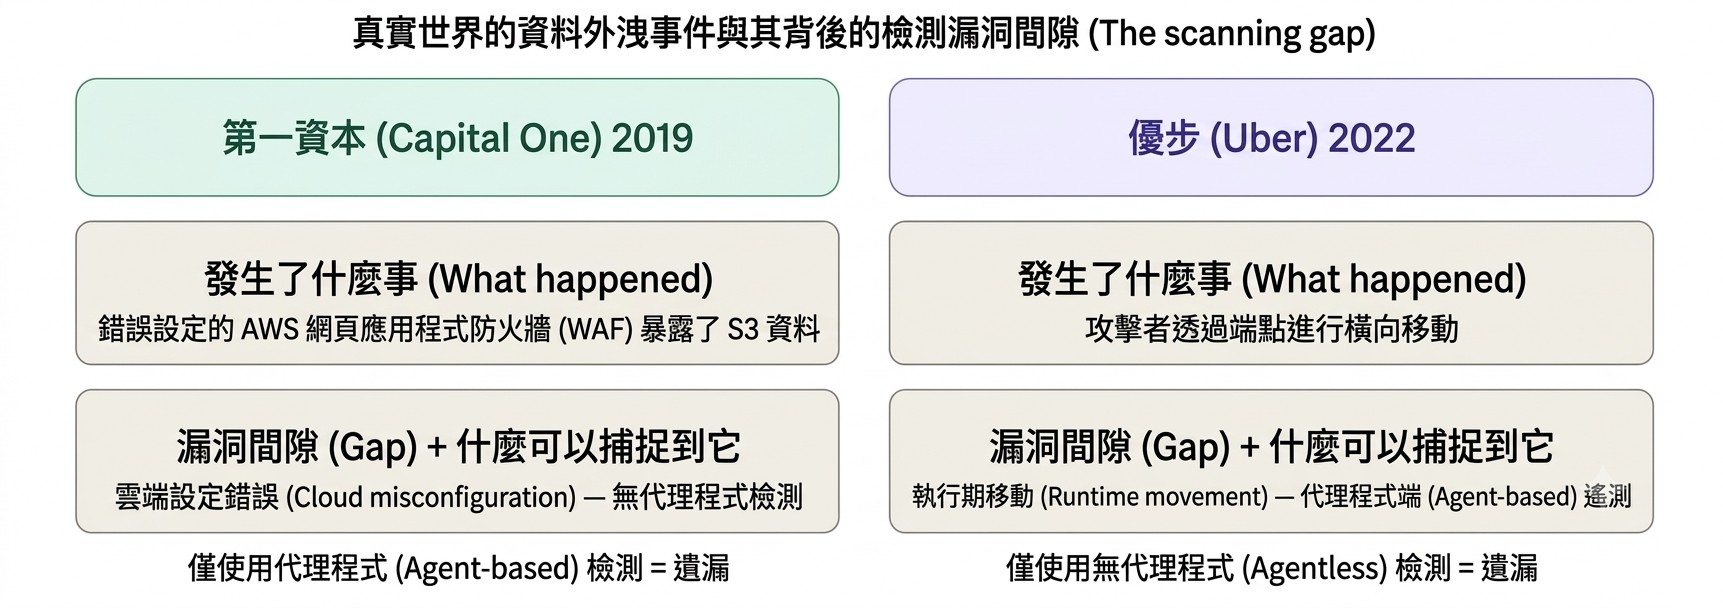
這兩類覆蓋盲區並非紙上談兵。在 Capital One 2019 年的資料外洩事件中,錯誤設定的 AWS WAF 暴露了 S3 資料,這原本是無代理程式掃描可以在事件發生前捕捉到的。而在 Uber 2022 年的資料外洩事件中,來自代理程式感測器的執行階段遙測資料,本可以捕捉到內部橫向移動。

這些事件呈現出一致的模式:不同類型的攻擊,往往會利用組織留下的不同防護缺口。

這在維運上之所以至關重要,是因為合規與稽核需求可能會驅使組織偏向其中一種方法,進而產生覆蓋率的虛假安全感。SOC 2 和 ISO 27001 的規範在紙面上可以透過雲端層級的無代理程式掃描來滿足,但這並不代表受控端點上的執行階段行為威脅得到了防護。稽核雖然過關了,但盲區依然存在。


「結合」的真正定義?

執行兩個獨立的掃描工具並合併 CSV 匯出檔案,並不能稱為結合的方法。這只是一個披著資安計畫外衣的資料對帳問題。

一個真正的多重手法架構需要具備多數單一功能產品無法提供的三項要素:

首先,統一資產識別(Unified Asset Identity)。
結合兩種掃描方式可確保廣泛的覆蓋率與豐富的資料,特別是在混合與遠端環境中,但前提是平台必須能夠將無代理程式發現的設備,與其由代理程式管理的對應設備進行媒合,而不會建立重複的紀錄。IP 位址會變更,主機名稱會漂移。如果平台將它們視為不同資產,不僅會造成漏洞數量膨脹,修補成效指標(Remediation Metrics)也會因此失真。

第二,單一風險視角。
來自這兩種方法的發現需要被一同正規化並排出優先順序。在雲端工作負載中透過無代理程式發現的 CVSS 9.8 漏洞,與在受控伺服器上由代理程式發現的 CVSS 9.8 漏洞,應該出現在同一個修補佇列中,並套用相同的優先順序邏輯。

第三,誠實地報告存在的不足之處。
僅執行單一掃描方法所帶來最危險的產物,就是虛假的自信。一個顯示「管理中包含 12,000 個漏洞」,卻未揭露其僅涵蓋 60% 資產清冊的平台,並不是真正的風險管理工具,反而可能形成治理與責任上的風險。

混合型企業環境下的實際運作情況

對於同時涵蓋地端基礎架構、雲端工作負載、OT 網路與外部承包商設備的企業環境——也就是現今多數企業的實際樣貌——採取多重掃描方式並非選配,而是建立可被驗證之風險管理的最低必要架構。

對於安全性與可靠性至關重要的關鍵任務地端系統,代理程式掃描(Agent-based Scanning)系統是審慎的選擇;而無代理程式掃描(Agentless Scanning)對於包含異質設備的網路環境而言,則更具彈性與擴充性。資安從業人員的實際建議是一致的:使用無代理程式掃描來獲取全組織的覆蓋率、資產清冊,以及跨所有雲端帳號的組態與漏洞檢查,接著在需要深入執行階段檢測的特定關鍵工作負載上部署代理程式。

這就是其架構。關鍵問題在於,您的平台是否原生支援這種架構,還是必須透過不同元件的整合才能建構?

為什麼 vRx 能夠同時具備這兩項任務?

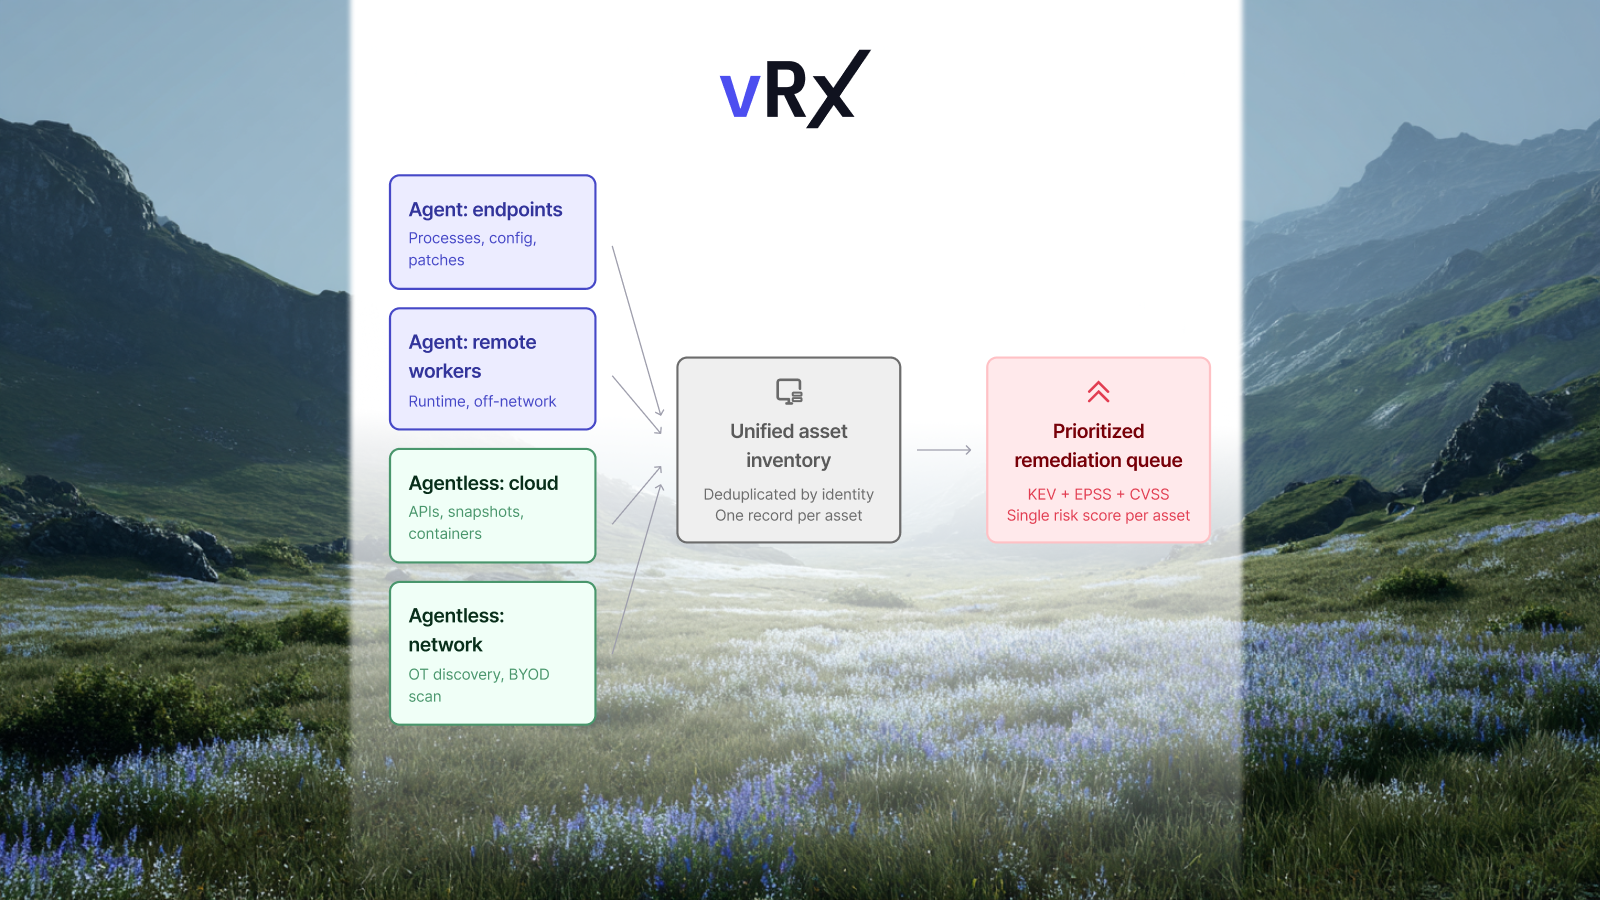
Vicarius 的 vRx 正是圍繞此一架構而設計:將代理程式掃描(Agent-based Scanning)與無代理程式掃描(Agentless Scanning)視為單一平台內的原生功能,並共同匯入統一資產識別(Unified Asset Identity)清冊中。當一台設備最初透過無代理程式掃描被發現,之後再納入代理程式管理時,不會因此建立重複紀錄。來自兩種來源的漏洞發現會在同一個佇列中進行正規化與排序,並採用一致的風險評分邏輯。

對於管理混合環境的資安長(CISO)而言,採購兩套不同領域的工具再自行對齊輸出,反而會產生前述資料完整性問題:資產清冊失真、去重複化機制在規模擴大後失效,甚至讓提交董事會的數據表面上看似完整,實際涵蓋範圍卻仍存在大量盲區。

平台的核心問題不在於選擇「代理程式或無代理程式」,而是「哪一個平台能原生提供我兩者,而不需要我的團隊去維護兩種資料模型」。

評估漏洞管理平台時,必須問的關鍵問題

在承諾採用任何漏洞管理平台之前,請要求廠商向您展示一份包含該工具「未發現」資產的覆蓋率報告,而不僅僅是它所發現的資產。任何無法區分「資產無漏洞」與「資產未掃描」的平台,都無法提供真實的風險輪廓。

它提供的,只是已知資產的局部快照,而非完整的風險全貌。

如果您希望在單一視角中掌握涵蓋受控端點、雲端工作負載以及未受控設備的真實攻擊表面狀況,歡迎預約產品展示。我們將針對您目前的環境進行覆蓋率評估,並向您展示您現有的工具遺漏了什麼。

另請參閱:

6 個任務:Vicarius 比您現有的漏洞平台更高效

當修補方案不足時:vRx 腳本引擎填補修補缺口


立即聯絡我們  

2026年08月23日【2026 iThome 數位政府高峰會】

力悅資訊代理之「Palo Alto Networks Idira」參與【2026 數位政府高峰會】

活動地點:臺北文創 (台北市信義區菸廠路 88 號 6 樓)
議程時間:15:45 – 16:15

演講題目:《公部門數位轉型下的身分安全治理與零常駐特權》 – 黃旭鍵|美商帕洛爾托網路有限公司 技術顧問

本次議程聚焦公部門數位轉型下的身分與權限管理挑戰,探討如何透過身分安全、特權存取管理與零信任原則,降低帳號濫用、橫向移動與未授權存取風險,強化整體資安治理。

感謝蒞臨現場聆聽議程與交流的政府及公部門夥伴們!

資訊悅報 Vol.58|Bitdefender: AI SOC 單靠自身就能偵測勒索病毒嗎?完整 Telemetry 與分析師判斷才是 MDR 關鍵

部落格來源網址:Your AI SOC Won’t Catch Ransomware by Itself


您的 AI SOC 無法單憑自身偵測到勒索病毒

客戶常問我,MDR 團隊究竟還需要多少位分析師。這個問題背後隱含著一個假設:AI 已經讓所需人數「變少」了。不幸的是,提出這些問題的組織,通常也是那些尚未解決其遙測資料(Telemetry)缺口、未託管端點、或是多因素驗證(MFA)涵蓋率問題的企業。他們希望 AI 去解決 AI 根本看不見的問題。

我理解為什麼大家會問這個問題:目前市場上主流的行銷話術,就是 AI 將取代 SOC 分析師。這種論述不僅錯誤,而且在維運上非常危險,因為它在告訴買方去縮減那些讓 AI 變得有用的基礎預算:遙測資料、業務情境與分析師的判斷力。

在 SOC 中從 AI 獲益最多的組織,是那些已經具備完善基礎條件的企業。而跳過基礎條件、先購買 AI 工具的組織,依然在與同樣的能見度缺口對抗,唯一的差別只是他們現在擁有了一個能更快速處理這些缺口的儀表板。

我最近與同事在線上研討會中討論了這個主題: < 實驗室、SOC 與紅隊:為什麼預防仍是贏家 >。


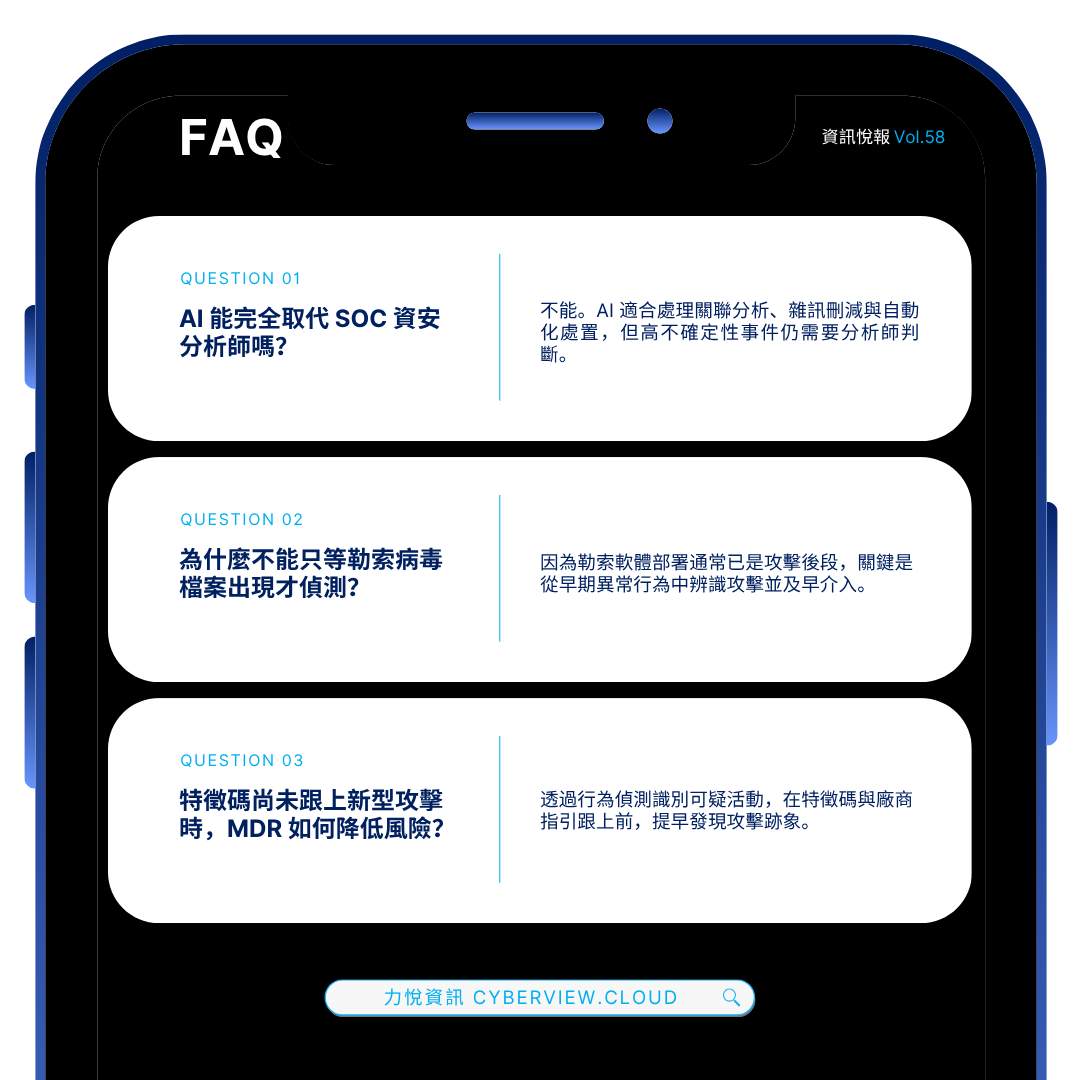
SOC 中的 AI 負責處理哪些事項?

AI 確實為 MDR 團隊的維運方式帶來了實質且可衡量的轉變。過去需要分析師手動連動數十個來源事件的遙測資料關聯分析,現在會直接呈現為具備優先順序的警示。過去需要從原始日誌中花費三十分鐘建立的調查摘要,現在只需幾秒鐘。雜訊刪減是真真切切的:需要人類投入關注的警示比例已經改變,當一個團隊需要同時涵蓋數百個環境時,這種轉變至關重要。

在定義明確的環境中,AI 可以執行預先定義的遏制行動(Containment Actions),而無需等待分析師。這是實打實的能力。例如:根據特定的行為觸發條件隔離已確認遭入侵的端點、將遭入侵帳號的密碼重設排入佇列、阻止符合已建立行為特徵的程序執行——這些都是低不確定性、低維運衝擊的行動,自動化在此發揮了其價值。

若要誠實地描述 AI 的擅長之處,那就是:它處理那些答案已經明確、不確定性低且出錯時維運衝擊在可控範圍內的工作。資料增補、關聯分析、優先順序排序、預先定義的回應。在這些界線之內的一切,都是現代 SOC 中真正的 AI 領域。


為什麼勒索病毒二進位檔是錯誤的偵測目標?

「AI SOC」行銷話術中最具破壞性的一種說法,就是將焦點放在惡意程式執行時將其捕獲。這種焦點是錯誤的,我想準確解釋為什麼,因為這會影響 MDR 專案應如何建構的每一個細節。

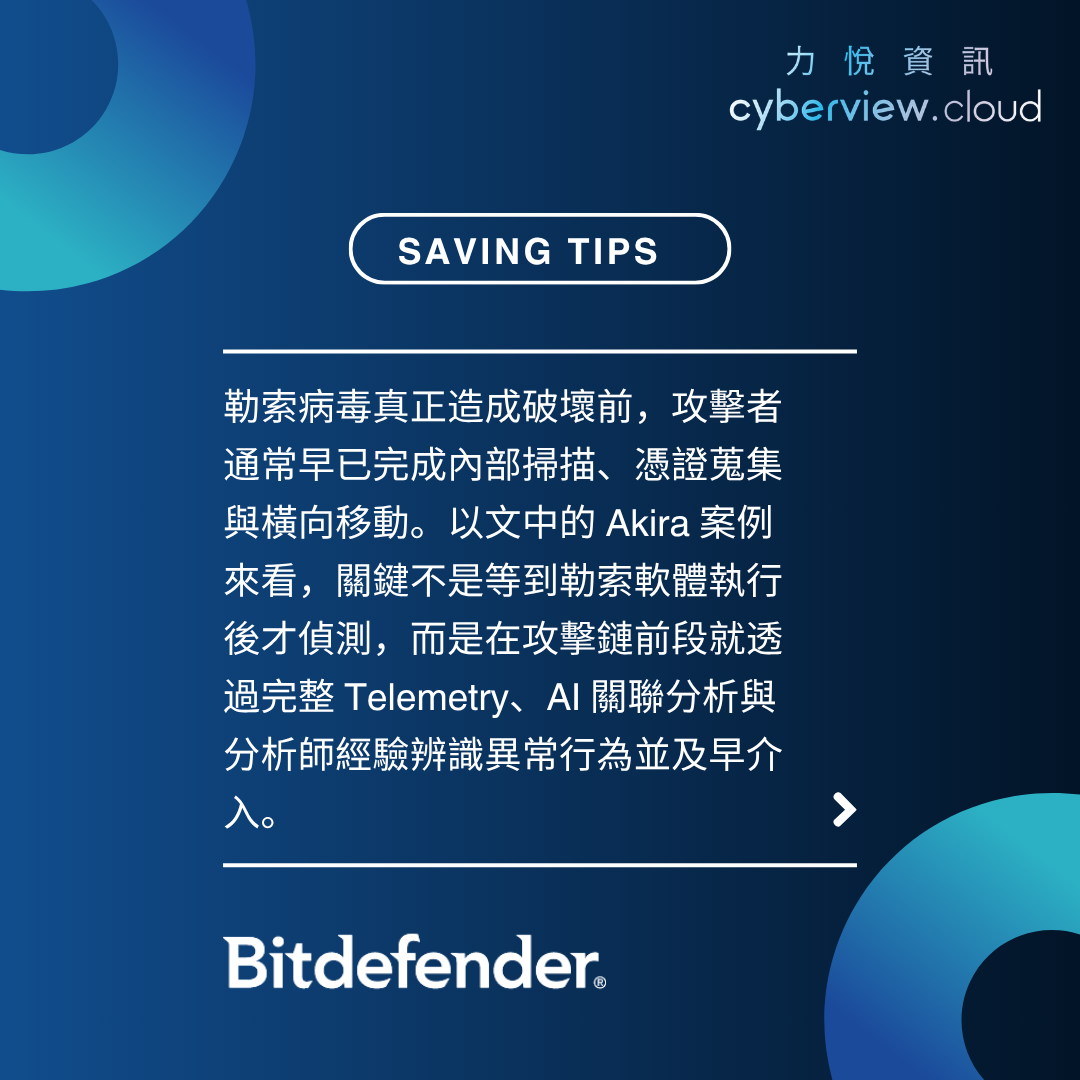
部署勒索病毒是勒索病毒事件中最後發生的事情之一。在二進位檔案執行之前,攻擊者通常已經在環境中潛伏了數小時、數天甚至更久。他們已經存取了網路、進行掃描、識別出 Credential Store(認證資訊儲存區)、執行 Credential Dumping(認證資訊傾印)、橫向移動到他們需要的系統,並確認環境已經就緒。當勒索病毒二進位檔案出現時,調查基本上已經結束了。問題只在於遏制行動是發生在加密之前還是之後。

有一個案例清楚說明了這一點。我們發現了從暫存使用者目錄執行的可疑 Advanced IP Scanner 活動。單看這項觀察,它就像是雜訊。合法的網路管理員經常使用 Advanced IP Scanner,且該程序本身並不具備惡意。但是 SOC 團隊之前調查過幾起以此完全相同組合為開端的勒索病毒事件:先存取 VPN 進入環境,然後透過異常路徑執行的工具進行內部掃描。我們已經見識過這種序列的走向。

在不同產業的多個中型企業環境中,完整的 Akira 勒索病毒演進都遵循相同的攻擊鏈:

  1. VPN 存取
  2. 內部掃描
  3. 遠端登錄活動(遠端查詢登錄檔中與認證資訊相關的區域,這可能發生在合法管理流程中,但也是勒索病毒部署前認證資訊蒐集的標準早期步驟)
  4. 認證資訊傾印
  5. RDP 橫向移動
  6. 勒索病毒的部署

共六個步驟。 而阻止衝擊發生的偵測是發生在第二步,而不是第六步。

在該案例中,初始存取涉及對 SonicWall VPN 的漏洞利用。根據我們從先前調查中獲得的發現,我們立即隔離了受影響的主機,並建議客戶停用外部 VPN 存取、驗證修補程式狀態,並重設特權帳號的認證資訊。結果沒有任何勒索病毒被部署。二進位檔案從未執行,因為分析師在第二步就辨識出了演進模式,而不是在最後一步。

讓這種早期偵測成為可能的跨環境學習,並不是產品中的某項功能。這是分析師在不同客戶、不同產業、不同架構中多次調查相同演進過程後所產生的結果。這種模式在完成之前就變得可以被辨識。我們在較新的社交工程技術中也看到了相同的維運學習,包括 ClickFix 式攻擊 (這是一類透過誘騙使用者,促使受害者手動執行惡意指令的技術)。交付方法演進得很快,但許多行為模式會重複。當新案例到來時,分析師並非從零開始。


特徵碼涵蓋率看不見的盲點

特徵碼涵蓋率與廠商指引的更新速度,趕不上現代攻擊者的步伐。這個差距正是行為偵測發揮價值的所在,也是「AI 取代分析師」論述最明顯瓦解的地方。

在 2025 年 7 月 18 日,Bitdefender MDR 在一台地端 SharePoint 伺服器上識別出可疑的編碼 PowerShell 活動,試圖將惡意程式碼部署到 SharePoint 網頁目錄中。相關的漏洞 CVE-2025-49706(SharePoint 中的身分驗證規避)和 CVE-2025-49704(允許遠端程式碼執行的不安全的反序列化漏洞)已由 Microsoft 於 7 月 8 日發布。這些 CVE 是公開的。當時尚未被廣泛確認的是,這些漏洞已遭攻擊者在實際攻擊中主動利用。

CISA 於 7 月 20 日更新了 其指引 。微軟 於 7 月 22 日發布了《阻斷針對本地端 SharePoint 漏洞的主動攻擊》一文。微軟隨後的分析將更廣泛的攻擊活動歸因於 Linen Typhoon、Violet Typhoon 和 Storm-2603。該活動後來在公開報告中被命名為「ToolShell」。

7 月 18 日的 MDR 偵測並非在該漏洞被披露之前進行的。它是在主動利用浪潮(active-exploitation wave)之前、在特徵碼涵蓋率和更廣泛的廠商指引趕上之前發生的。

這就是關鍵的時間窗口:從 CVE 發布,到資安社群廣泛確認已有真實攻擊者實際利用之間的差距。這個差距通常以天到週來衡量。攻擊者就在這個窗口內行動。行為偵測有時能捕獲特徵碼型工具看不見的威脅,因為行為偵測運作的證據不需要預先知道特定的漏洞。


AI 將哪些工作交還給分析師?

AI 將工作交還給人類處理時,存在一條明確的邊界。這條邊界由兩個變數定義:維運衝擊與不確定性。當兩者皆低時,AI 承擔該任務。當任一者升高時,任務就會回到分析師手上。這不是一個需要透過工程手段消除的限制,而是正確的設計。

我在解釋這一點時常想到一個案例,該活動最初被 AI 分類為很可能是合法的系統管理行為。涉及的程序是帶有簽章的 Windows 二進位檔案。沒有明顯的惡意程式執行。根據 AI 所權衡的證據,這種分類是合理的。

分析師發現了不同的端倪。該活動涉及對系統中與敏感認證資訊相關區域的遠端登錄檔存取。這種行為在管理工作流程中確實可能合法發生。但它也可能是勒索病毒部署前認證資訊蒐集的標準早期步驟。AI 無法回答的問題是:這符合該客戶的正常環境嗎?分析師具備維運情境知識,能辨識出這並不符合。該案件隨即被呈報,主機被隔離,並以一起正在發生的認證資訊存取事件進行處理。

這就是設計發揮作用的判斷層。AI 處理了關聯分析、雜訊刪減和初始分類。分析師則做出了需要理解該行為在該客戶及該環境之特定情境下代表何種意義的決策。未來的 SOC 是 AI 強化型的(AI-amplified),而非無分析師的。邁向自動化的每一步,只要能在維運衝擊邊界上保留分析師的判斷力,就是正確的步驟。任何移除該邊界的宣傳話術都是錯誤的。 


哪些組織從 AI SOC 中獲益最多?

從 SOC 中的 AI 工具中獲益最多的組織,是那些已經擁有強大遙測資料涵蓋率、MFA、預防層、回應能力和端點能見度的企業。AI 可以在可靠的情境上運作。當情境可靠時,AI 能加速工作,並將分析師的時間轉移到真正關鍵的決策上。


哪些組織在 AI SOC 中掙扎?

在 AI 工具中苦苦掙扎的組織,是那些將其部署在尚未解決的能見度缺口之上的企業:未回報遙測資料的未託管系統、不一致的 MFA 涵蓋率、缺少端點 Agent、未定義的回應權限。AI 不會填補缺口。它只處理現有的資料。當現有的資料不完整時,AI 會更快地處理這幅不完整的景象,而分析師則會基於被扭曲的環境視角做出決策。


AI 正在造福攻擊者還是防禦者?

資安防禦者還是威脅行為者從 AI 中獲益更多?這是一個開放性問題,目前尚無定論。《2026 年 Bitdefender 資安評估報告》 調查了六個國家的 1,200 位 IT 和資安專業人員的意見,52.6% 的人表示「AI 對攻擊者的幫助超過了防禦者」。我們現在可以肯定的一件事是:雙方的維運節奏都在加快。

MDR 模式中,防禦者的結構性優勢並非運算能力優勢或模型品質。而是 MDR 團隊能同時在許多環境中調查攻擊,且這種學習會產生複合效應。當我們在客戶 A 身上看到新的演進模式時,它會改變我們在下一週解讀客戶 B 環境中早期訊號的方式。這種維運記憶正是讓早期偵測得以在第二步而非第六步發生的關鍵。AI 加速了這種模式知識的累積與檢索。它並沒有取代知識本身。

字面上來看,AI SOC 的宣傳話術描述的是一個基礎條件已經完備的環境:完整的遙測資料、強大的預防機制、一致的身分識別控制、定義明確的回應權限。在這樣的環境中,AI 確實能加速並放大效益。錯誤在於假設這種宣傳描述了大多數組織目前的現狀,而不是他們需要首先達到的目標。

當預防層壓縮了攻擊者的早期時間窗口時,Akira 的演進就變得更難完成。良好的遙測資料意味著分析師和 AI 都在基於完整的景象進行工作。MFA 和身分識別控制意味著該攻擊鏈的早期步驟在被偵測到之前更難完成。SOC 和預防層並不是爭奪同一筆預算的分開投資。SOC 會放大預防層所建立的防護成果。

5 月 21 日的專題討論會探討了本篇內容所依賴的兩個主軸:預防優先的架構,以及啟用 AI 的 SOC 能做與不能做的事。我當時與 Bitdefender 實驗室及 Bitdefender 紅隊一同為 SOC 提出論證。同一批事件,從三個不同視角進行完整剖析,並全程錄影。
點此觀看隨選錄影: 實驗室、SOC 與紅隊:為何預防仍是最有效的策略


立即聯絡我們  

資訊悅報 Vol.57|Idira:機器身分暴增、TLS 憑證週期縮短,企業如何守住身分與數位信任?

部落格來源:Idira—達成權限控制大眾化的旅程


Idira:達成權限控制大眾化的旅程

關鍵要點

  • 建立在 PAM 特權存取管理的技術基礎上: Idira™ 是 Palo Alto Networks 的新世代身分安全平台,可將特權控管延伸至 AI 企業中的每一種身分,包括人員、機器與 AI 代理。
  • 零常駐特權成為預設機制: Idira 以動態權限取代靜態、長期存在的存取方式,並透過單一控制平面提供即時授權,降低常駐權限遭濫用的風險。
  • AI 原生能力縮短攻防落差: AI 能力內建於 Idira 平台,可揭露隱藏權限與未受管理帳號、建議最小權限並推動補救,縮短攻擊者最快 72 分鐘即可從初始入侵走到資料外洩,與防禦團隊過去可能需耗時數日才能完成回應之間的落差。
  • 憑證生命週期正成為機器身分治理的關鍵: NGTS 聚焦憑證生命週期自動化與後量子安全準備。隨著公共 TLS 憑證有效期逐步縮短,並將於 2029 年進一步降至 47 天,仍仰賴人工更新的企業將面臨更高的維運與服務中斷風險。

自從 Palo Alto Networks 與 CyberArk 於二月完成合併以來,市場持續關注同一個問題:身分安全的未來究竟會是什麼模樣?

在今年 IMPACT 大會上,Palo Alto Networks 正式揭示了這個答案——推出 Idira™,新世代身分安全平台。Idira 可在單一控制平面上保護 AI 企業中的每一種身分,包括人員、機器與 AI 代理,主動探索風險、動態套用權限,並治理從首次存取到最後一個工作階段的完整生命週期。

Idira 的理念,源自超過二十年深耕此領域所淬煉出的信念。權限是身分安全中最具挑戰性的環節。 過去一個世代以來,業界學會了如何有效管理少數高度特權使用者,也就是全球最重視安全的企業中負責系統管理的管理員。這在當時確實有其必要,但如今早已不再足夠。

現在,是時候將同樣嚴謹的控管標準擴展到每一種身分。因為時至今日,任何身分都可能推動業務運作,同時也可能成為攻擊者利用的入口。這正是 Idira 所帶領我們踏上的旅程,從僅針對管理員的特權控管,演進為涵蓋每一種身分的權限控管。

攻擊者不再只是闖入,而是直接登入

在過去二十年的大部分時間裡,身分安全一直建立在一個令人安心的假設之上:只要能清楚區分少數擁有高度權限的管理員,以及大量的一般使用者,企業就能獲得充分保護。然而,這項假設在今天已經無法成立。

Palo Alto Networks 董事長暨執行長 Nikesh Arora 將此稱為「IAM 謬論」。而《2026 年身分安全形勢報告》中的資料也清楚顯示,這樣的假設早已不再適用。

根據全球 2,930 位網路安全決策者的回覆:

  • 機器身分的數量目前已達人類身分的 109 倍,其中 79% 是 AI 代理身分。
  • 91% 的企業已在生產環境中部署自主式 AI 代理。
  • 90% 的企業在過去 12 個月曾遭遇與身分有關的攻擊,83% 的企業曾發生兩起以上的安全事件。

舊有模式之所以失效,並不是因為身分變得不再重要,而是因為身分與權限已經無所不在,遍布企業的各種環境與系統。

根據原文作者過去兩年對重大攻擊事件的觀察,這些事件多遵循著類似的模式。攻擊者竊取帳號認證資訊,利用原本應該失效的常駐存取權限進行橫向移動,接著提升權限,最後成功入侵鎖定的資料、基礎架構或業務系統,包括 Okta、MGM、Microsoft。產業不同、規模不同,但攻擊模式始終如一。

單一過度授權的身分,就足以掌控整個企業。

而當防禦者有機會因應時,往往已經落後。有 97% 的從業人員表示,四處分散的工具會讓每一次身分事件的回應時間增加 12 小時。與此同時,Unit 42® 觀察到最快的攻擊者,從初始入侵到資料外洩最快僅需 72 分鐘。

身分已經成為企業的邊界,而過去用來保護這道邊界的威脅模型,早已不再適用。

每個身分都帶有特權,這是 Idira 的第一個基本原則

Idira 的核心理念很簡單:在企業中,每一種身分都帶有特定權限。

每一次登入、每一個存取權杖、每一個服務帳號與工作負載,以及每一個 AI 代理,都可能觸發工作流程、呼叫 API 或存取敏感資料。某些身分甚至能建立或刪除基礎架構、動用企業資金,或建立新的身分。權限不再只屬於少數管理員,而是已經分散到整個企業,並在每一秒持續運作。

同樣地,用來保護權限的控制機制,也不能只適用於少數人。

機器身分增加後,憑證也成為信任治理的一環

當企業中的機器、工作負載與 AI 代理持續增加,身分安全面對的已不只是帳號與權限問題。支撐系統、服務與機器彼此建立信任的數位憑證,也成為機器身分治理中不可忽略的一環。

今年稍早,Palo Alto Networks 於 RSA 大會推出新世代信任安全防護 NGTS(Next-Generation Trust Security),聚焦自動化憑證生命週期管理,並加速後量子安全準備。

目前仍有 71% 的企業尚未實現憑證更新自動化。隨著公共 TLS 憑證有效期逐步縮短,並將於 2029 年進一步降至 47 天,企業需要處理的更新頻率、變更作業與人工維運工作量也將同步增加。

對台灣企業常見的 SSL/TLS 憑證更新、變更管理與稽核佐證流程而言,這意味著原本仰賴人工追蹤的工作必須更頻繁執行。憑證生命週期管理因此不再只是日常 IT 維運問題,而逐漸成為服務可用性、業務持續性與數位信任治理的一環。

NGTS 正是從網路層著手,協助企業推動憑證生命週期管理自動化。

除了機器身分背後的數位信任治理,Idira 也從身分本身出發,透過三項核心能力持續降低過度授權與常駐權限風險:

首先,主動探索

Idira 會持續掃描整個環境中的所有身分、權限與存取路徑,全面涵蓋人員、機器、工作負載、機密、憑證與 AI 代理,無論這些身分存在於網路、雲端、伺服器、端點或瀏覽器中。只要某個人或系統具備驗證身分的能力,Idira 就能知道它的存在、掌握其可存取的範圍,並評估這些權限中,究竟有多少是實際必要的。

其次,動態控制

Idira 透過只在需要當下存在的動態權限,取代攻擊者所依賴的靜態、長期存在的常駐權限。零常駐特權從理想目標轉變為預設機制,並同樣適用於登入生產環境的管理員、部署程式碼的開發者,以及呼叫工具的 AI 代理。這正是朝向「以身分為核心的主動安全防護」所進行的轉型。

第三,持續治理

Idira 將身分生命週期治理轉變為端到端自動化。治理不再只是每季一次、為了合規而執行的例行作業,而是持續運作的控管機制。原本因工具分散造成的 12 小時回應延遲,也能因此被大幅縮減。

這也正是「權限控制大眾化」所代表的核心概念:並不是放寬限制,而是將業界成熟的特權控管機制,擴展到每一個承載關鍵業務的身分,同時避免因安全控管而犧牲使用效率。

從身分治理延伸至整體安全平台

Idira 與 Strata®、Cortex® 並列為 Palo Alto Networks 的核心平台,並持續在整體產品組合中深化身分整合,進一步提升客戶的平台價值。Prisma® Browser™ 可直接在企業使用者實際工作的瀏覽器環境中提供特權存取能力。Prisma AIRS™ 3.0 則會以原生方式與 Idira 整合,將更完整的身分安全與權限控管延伸至 AI 代理。而 Cortex 將接收第一方身分訊號,提高偵測精準度,並在偵測到入侵指標時,自動執行以身分與權限為導向的回應動作。

客戶已經開始感受到實際成效。Northern Trust 將密碼合規性提升了 137%。Panasonic Information Systems 以身分為核心重建安全營運架構。Healthfirst 將零信任計畫建立在身分優先的控管機制之上。PDS Health 則為超過 900 間診所提供臨床存取安全保護。他們各自面臨不同的問題,卻找到了相同的答案。

挑戰各異,答案一致。透過單一平台,將一致的權限控管套用到每一個關鍵身分之上。

AI 讓這件事變得迫在眉睫,卻也讓它成為可能

AI 已經改變了身分風險的速度、規模與經濟法則。

前沿模型已跨越一個關鍵門檻。Anthropic 的 Claude Mythos Preview 已能在企業日常依賴的作業系統與瀏覽器中,識別出數以千計的零時差漏洞。每一組暴露的密碼、每一條常駐的管理員存取路徑、每一個被遺忘的服務帳號,如今都能被更快速地探索、驗證,甚至被武器化,其速度已超越多數安全團隊的回應能力。在 Palo Alto Networks 2026 年的調查中,55% 的決策者將 AI 驅動的威脅列為他們最關切的身分安全問題。

Palo Alto Networks 所提出的方向很明確:以 AI 對抗 AI。

如果前沿模型正在改變攻擊的成本效益,那麼可靠的因應方式,就是利用同樣的技術重新改寫防禦的經濟法則。

而 Idira 正是 Palo Alto Networks 在身分安全領域落實這項策略的重要平台。AI 原生能力已內建於平台中,可揭露隱藏權限、識別高風險的存取組合、自動建議最小權限,並推動精準補救。同類型的智慧能力,可能讓攻擊者在 72 分鐘內找到最脆弱的環節,也能協助防禦者在數秒內採取補救措施。

當程式碼修補速度無法趕上威脅變化時,身分就成為能以機器速度調整的重要控制平面。

共同的使命,攜手共進

在超過二十年的時間裡,特權存取管理的先驅者建立了深受信賴的控管機制,用以守護全球最關鍵的環境。這項使命創造了一個全新的產業類別,也建立起信任基礎,進而成就了今日的一切。

Idira 延續這項使命,並進一步將其擴展,以因應現今大規模的安全挑戰。

這只是第一波變革,而不是終點。這份產品藍圖將權限控管延伸至員工身分,推動機器身分與 AI 代理身分安全,並將原本碎片化的市場整合成單一平台。Palo Alto Networks 持續推進這項產品藍圖,並結合 IMPACT 大會上客戶所分享的實際需求與使用情境,共同塑造未來的身分安全方向。

身分安全的未來將不再僅由「存取」來定義,而是由「控制」能力來決定。見證 Idira 致力於實現的目標。

前瞻性陳述

此部落格包含涉及風險、不確定性和假設的前瞻性陳述,包括但不限於與 Palo Alto Networks 現有或未來產品和技術相關的效益、影響、效能及其潛在成果。本部落格、其他新聞稿或公開聲明中提及但尚未發布的任何服務、整合或功能,以及通常尚未普遍提供給客戶的服務或功能,目前可能尚未提供,亦可能無法依預期時程或形式推出。購買 Palo Alto Networks 應用程式的客戶,應以目前已普遍提供的服務與功能作為購買決策依據。


立即聯絡我們  

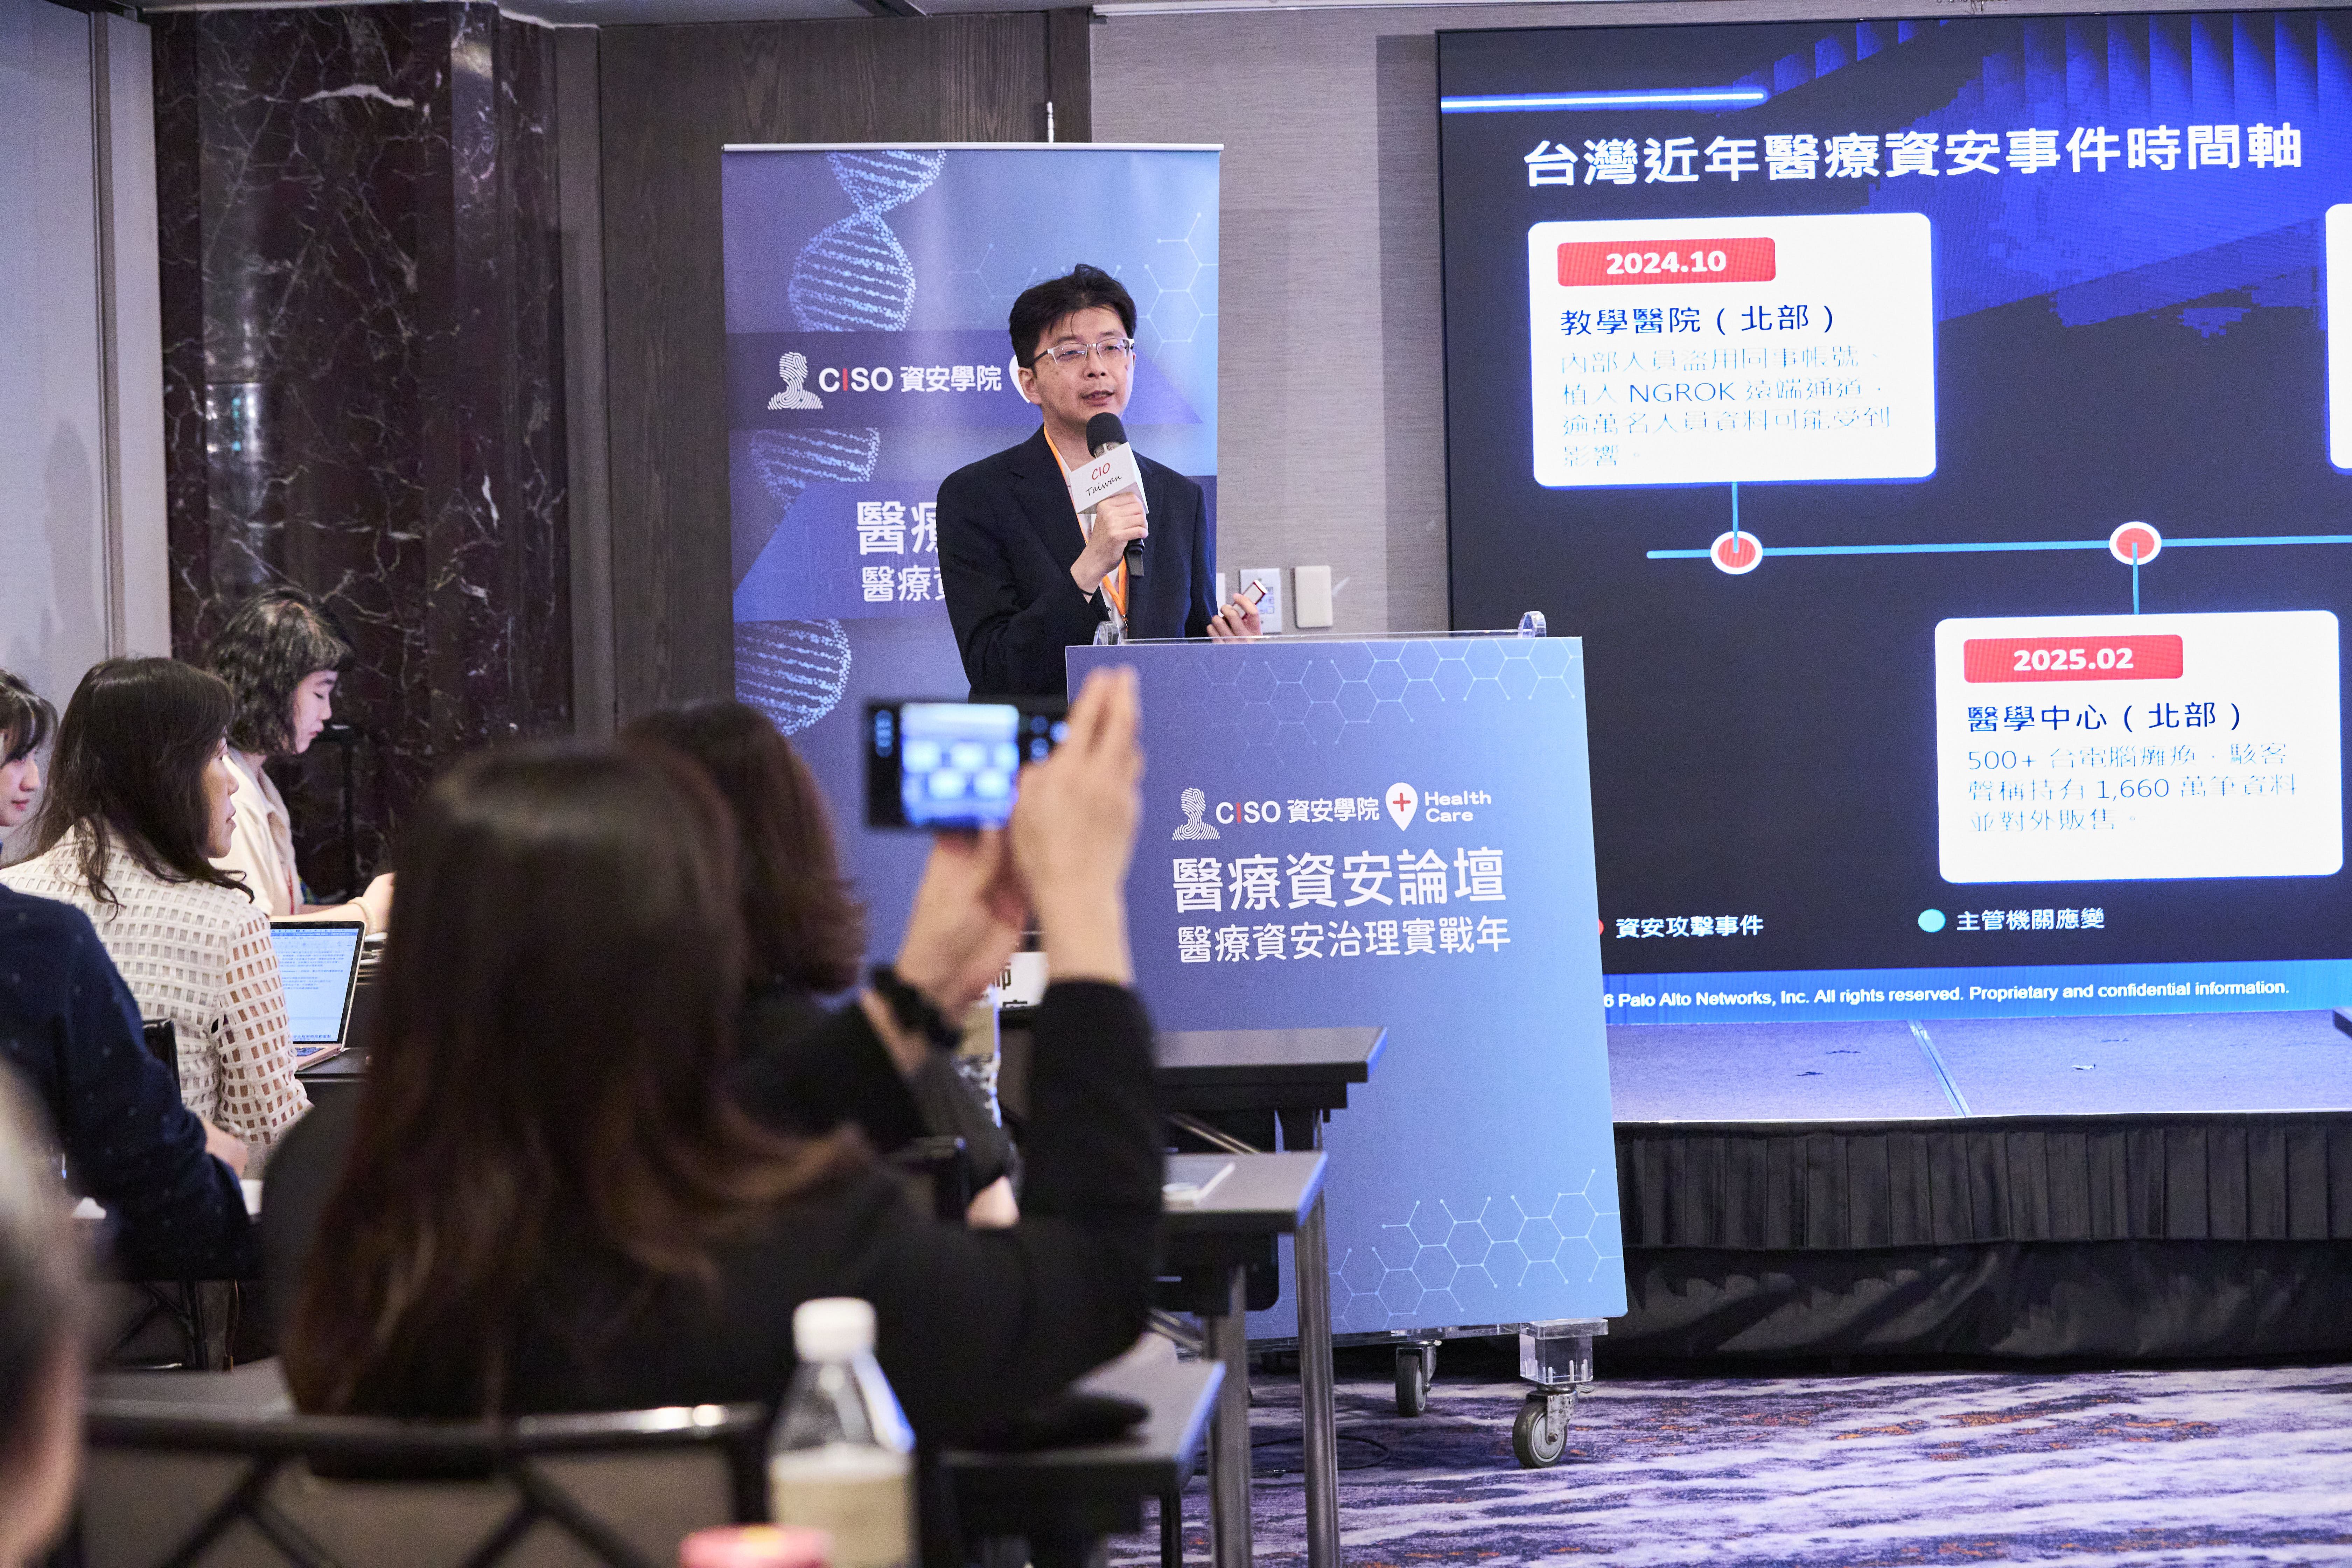
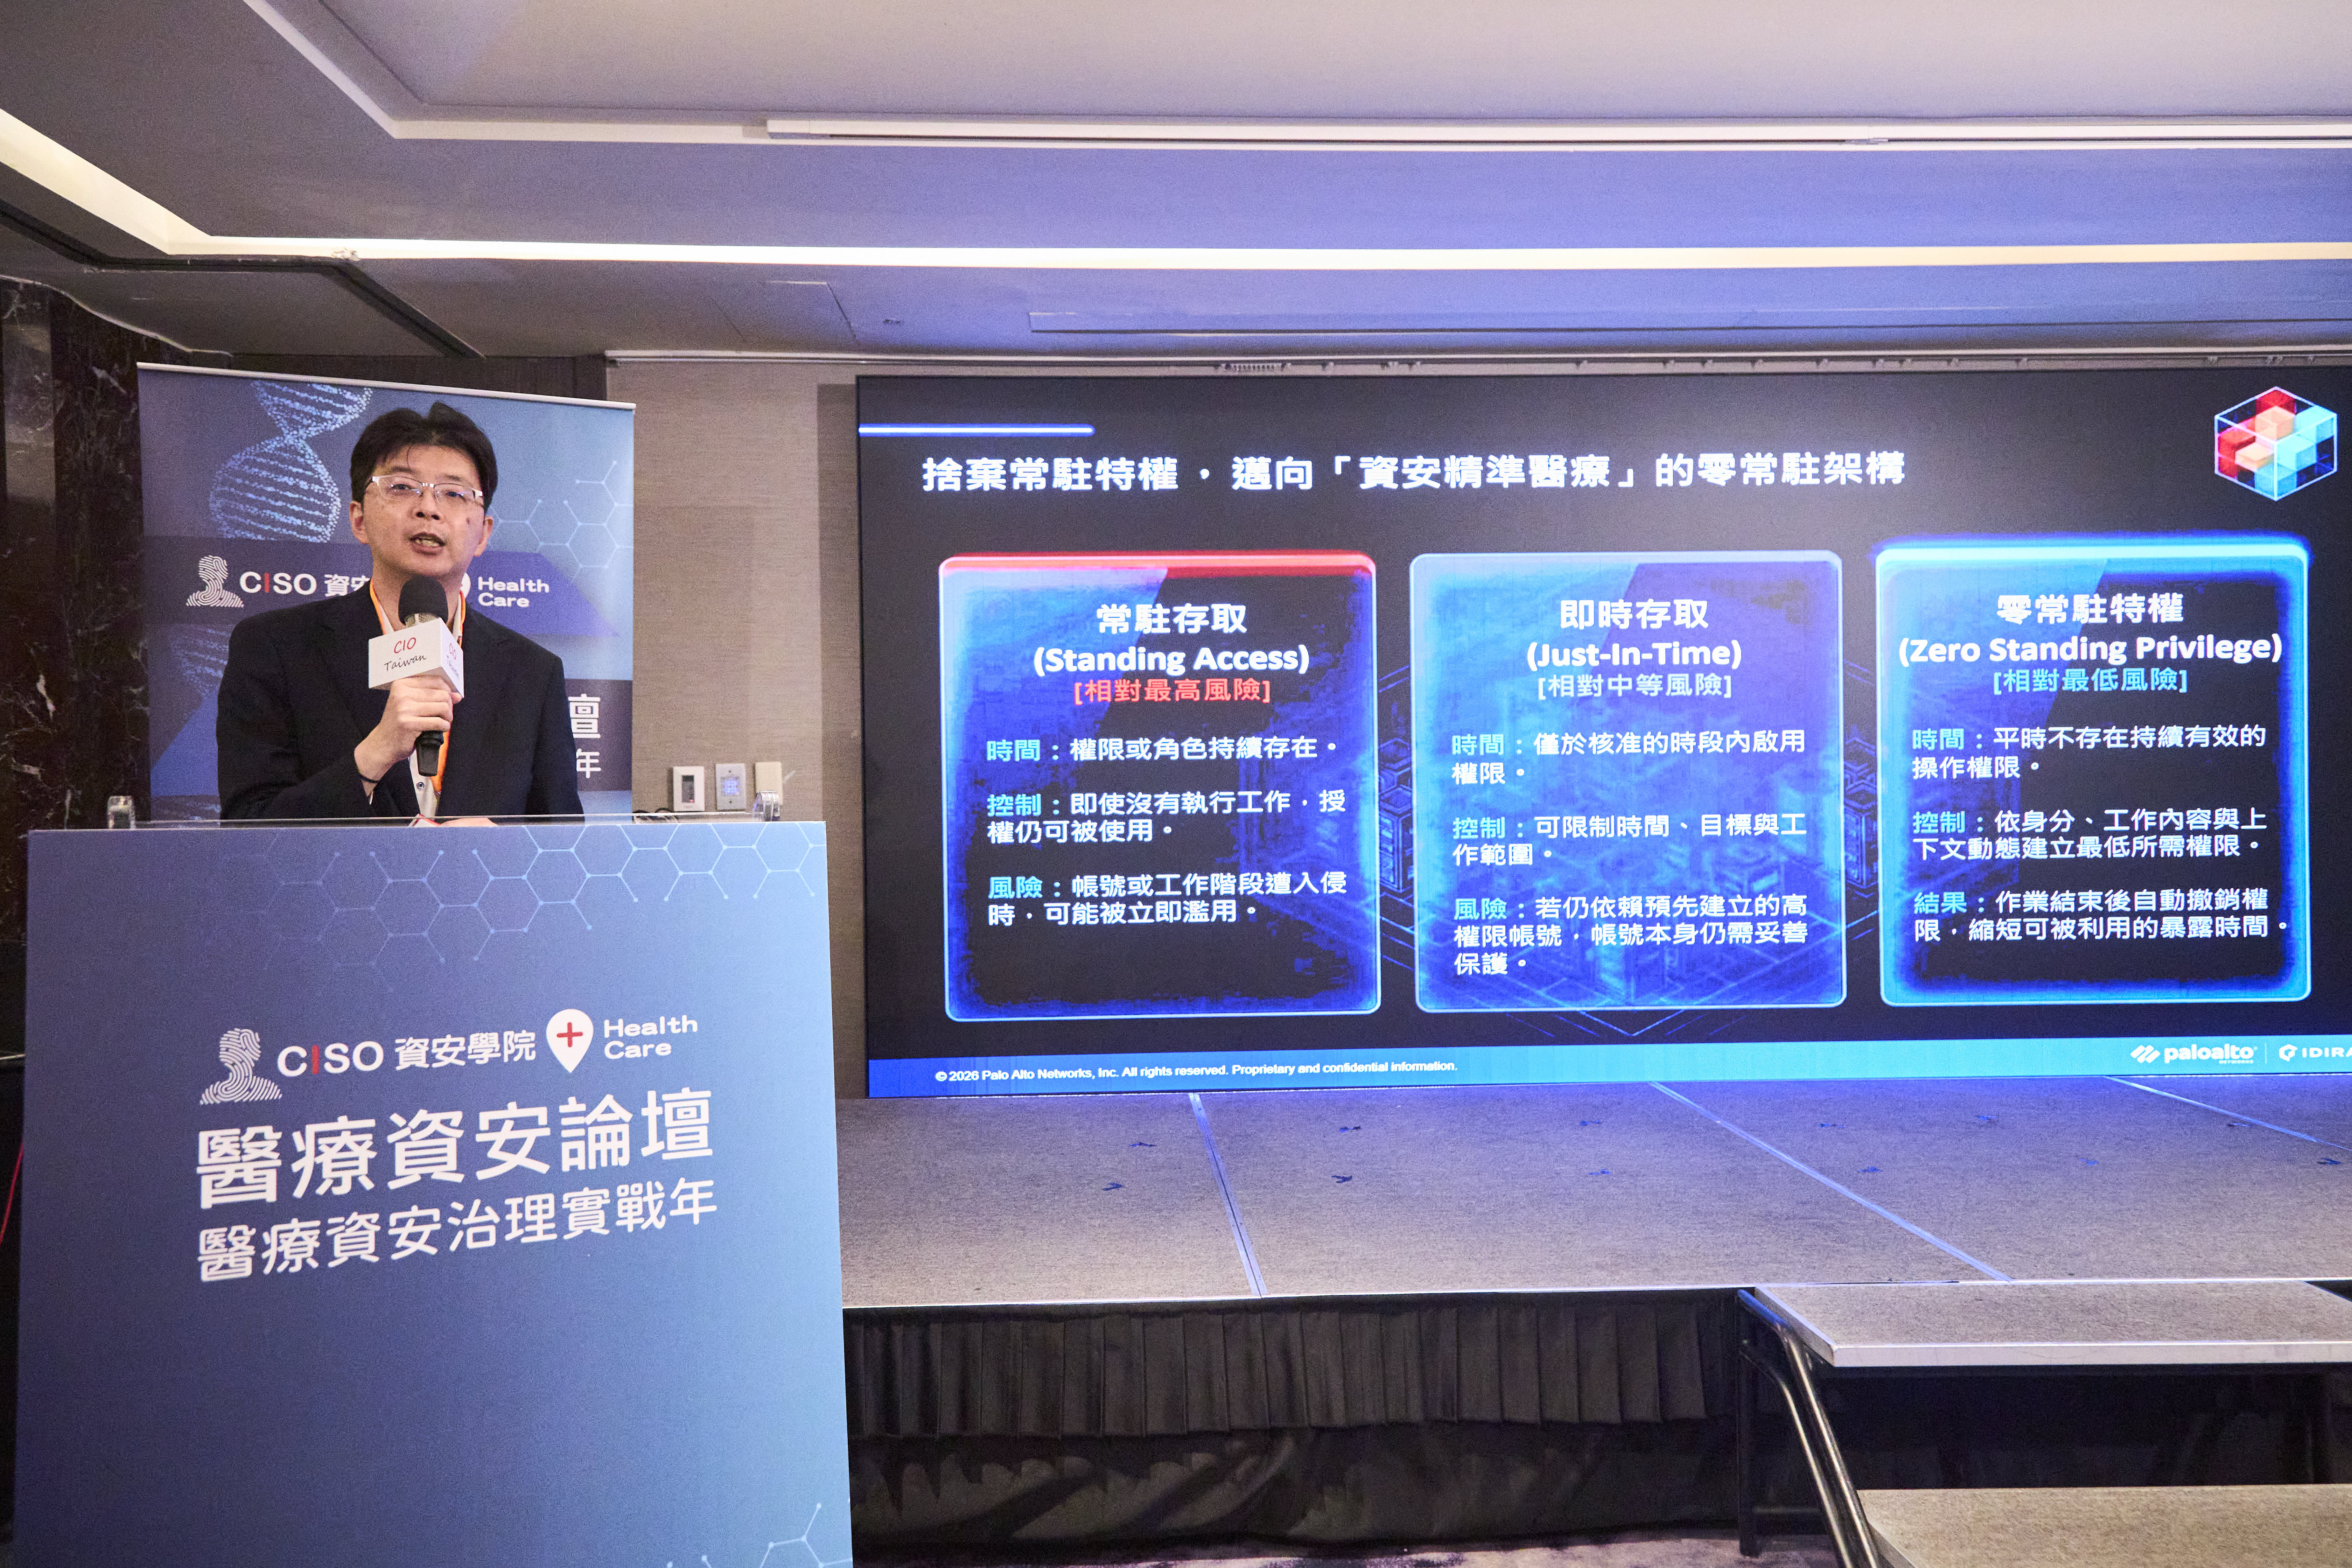
2026年08月07日【CISO 資安學院|醫療資安論壇】

力悅資訊代理之「Palo Alto Networks Idira」參與 CISO 資安學院【醫療資安論壇】

活動地點:台北喜來登大飯店 會議/喜廳+晚宴/月星廳 (台北市中正區忠孝東路一段12號b2)
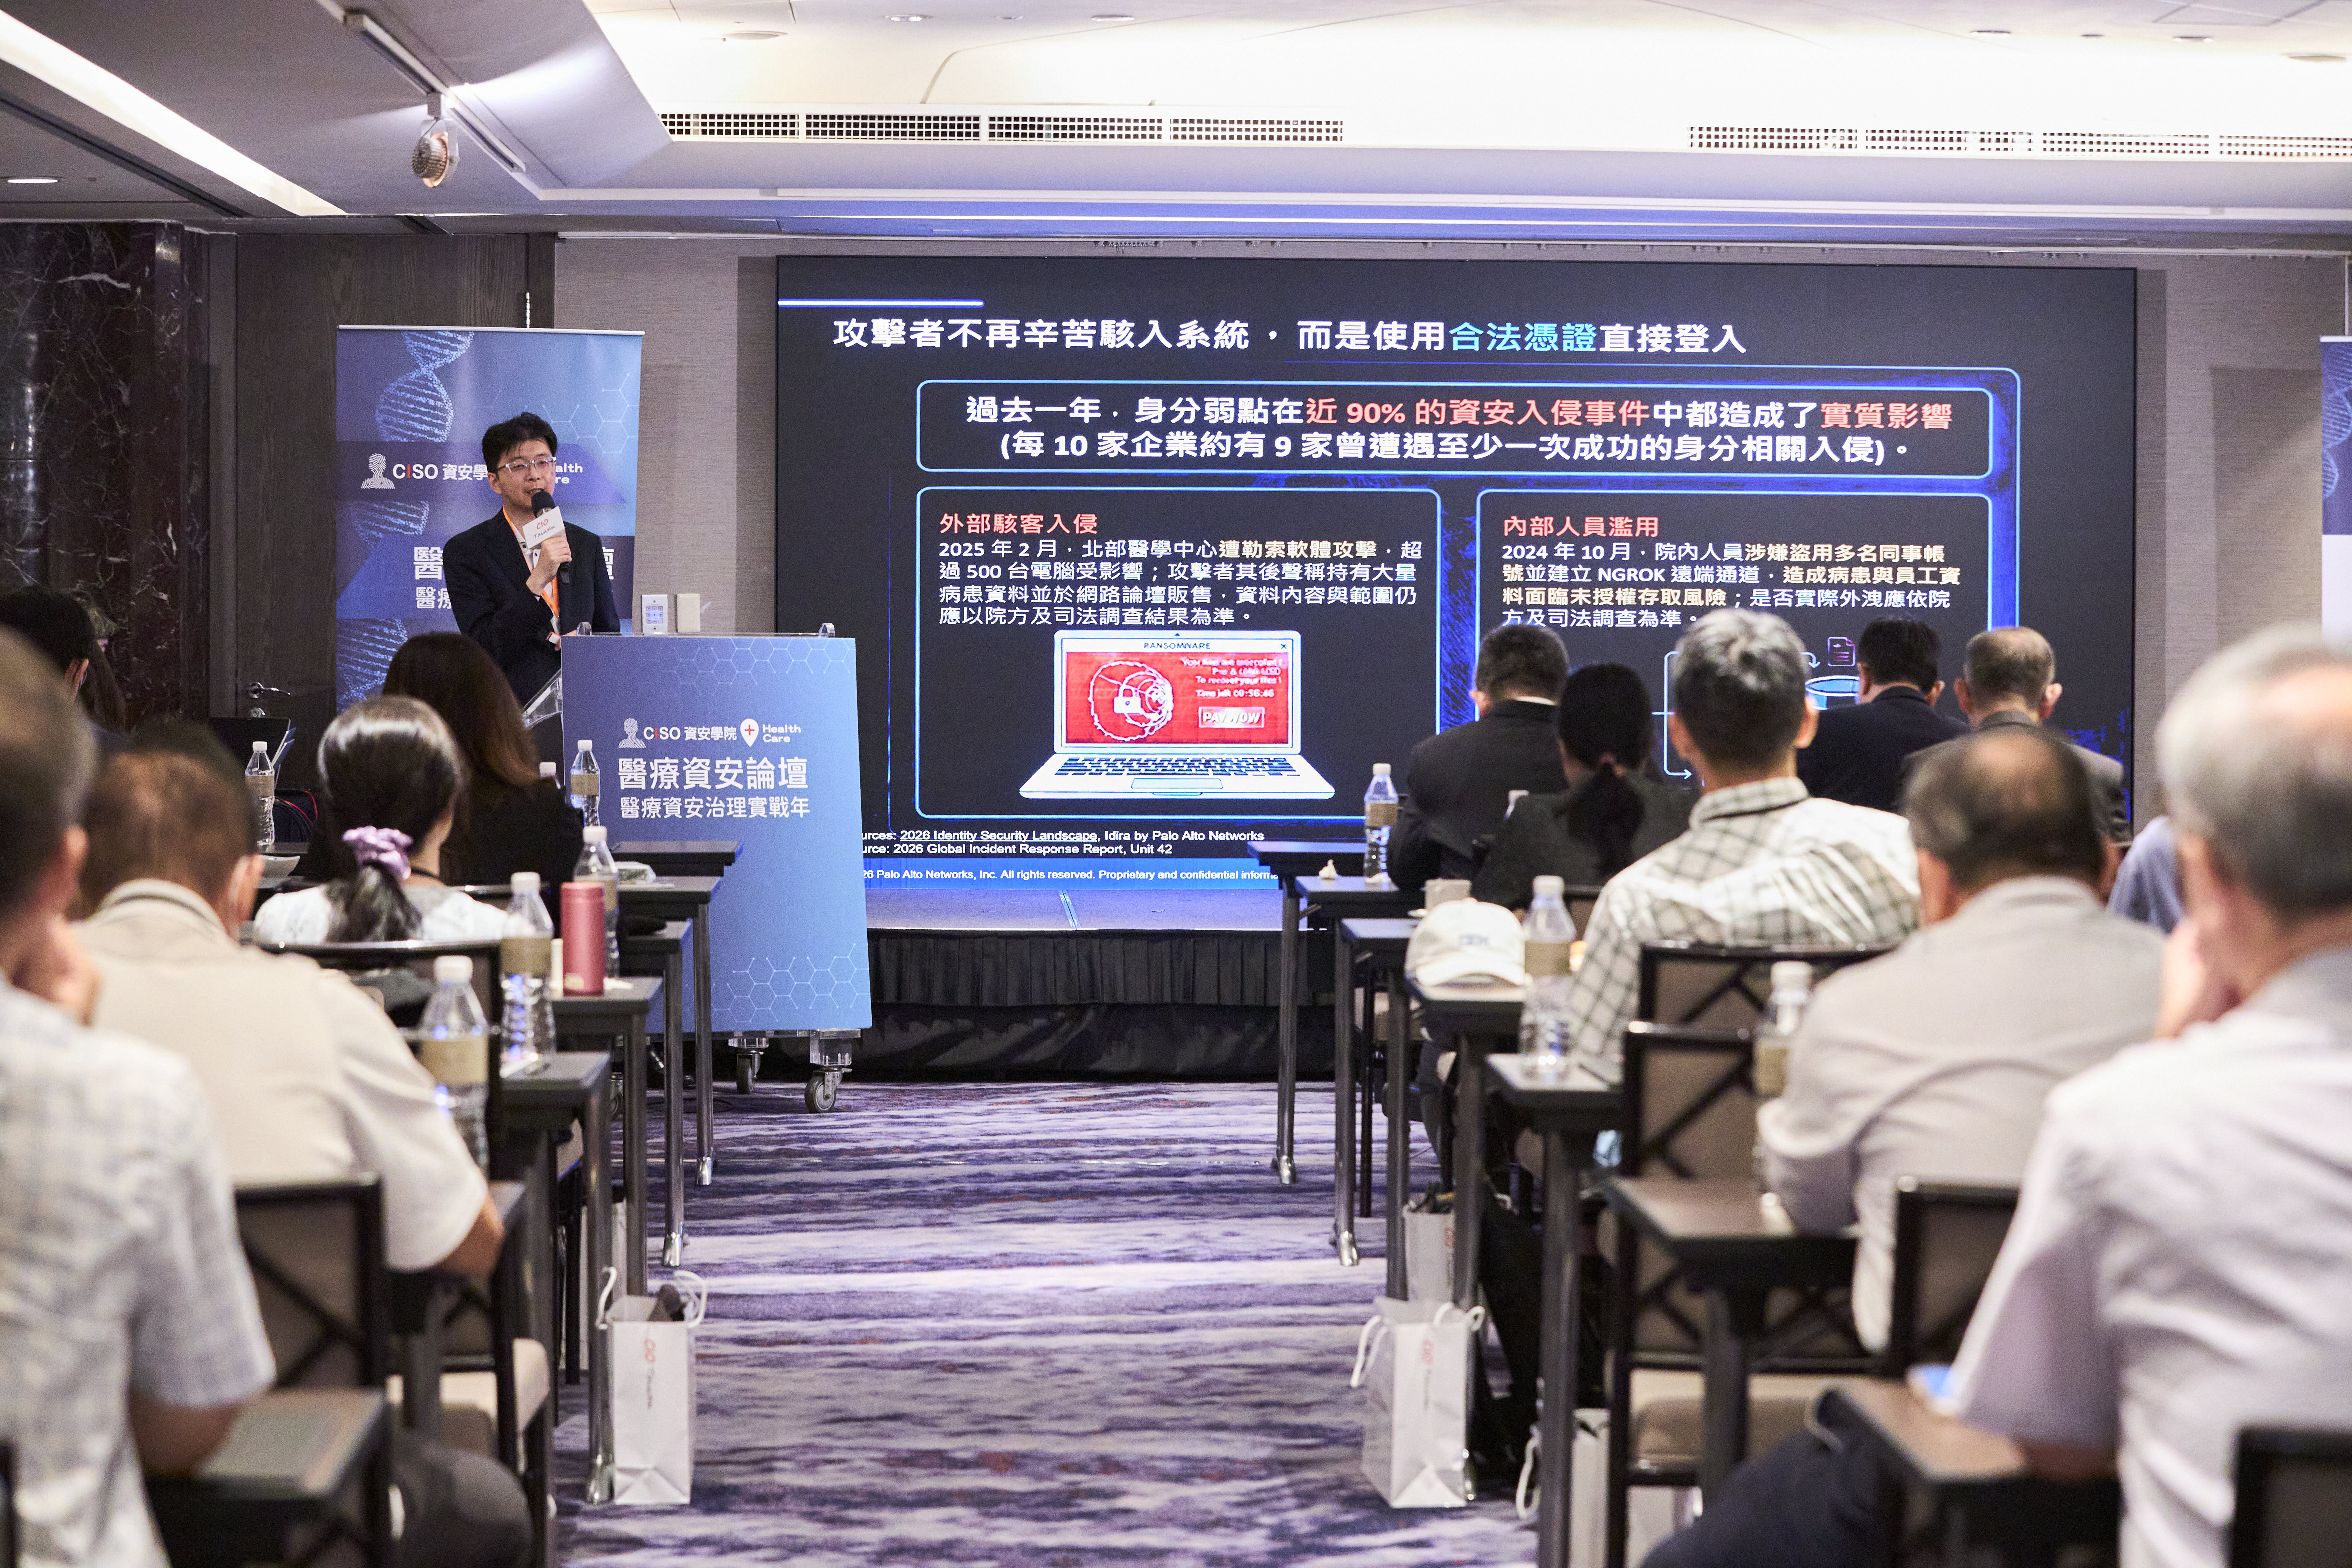
議程時間:16:10-16:30

演講題目:《醫療產業的身分安全治理與零常駐特權》 – 黃旭鍵|Palo Alto Networks Taiwan 技術顧問

本次議程聚焦醫療場域的身分與權限管理挑戰,探討如何透過零常駐特權、即時授權、最小權限與持續驗證,降低高權限帳號與特權存取風險。

感謝蒞臨現場聆聽議程與交流的醫療產業夥伴們!