資訊悅報 Vol.68|RE:FORM RATE: GPU 支出持續攀升,如何找出看不見的資源浪費?

GPU 成本成為新一波雲端浪費:RATE 推出 GPU Utilization 使用率分析功能

只要問任何一位基礎架構主管,2026 年最令他們夜不成眠的是什麼,往往才說不到第二句就會提到 GPU。受關稅、台積電成本上升,以及 AI 需求帶動的 DRAM 供應吃緊影響,Nvidia 與 AMD 今年均調高顯示卡價格 10% 至 15%。¹ ² 同時,Gartner 預測,到 2029 年,將有一半的雲端運算資源配置給 AI 工作負載。³

幾乎所有企業都被要求增加 GPU 投資,卻很少有企業能清楚說明,這些支出究竟有多少真正被有效運用。

這正是 RATE 現在要補上的缺口。GPU 使用率分析(GPU Utilization) 是 RATE 最新推出的功能,旨在將既有運算、儲存及 Kubernetes 成本管理所具備的可視性、責任歸屬與自動化成本精進能力,延伸至雲端帳單中最昂貴的支出項目。

GPU 浪費不是帳單上的零頭,而是預算問題

雲端資源浪費一直是雲端財務管理(FinOps)必須面對的問題,但 GPU 浪費的規模卻是另一個量級。

近期產業研究發現,企業 GPU 的平均使用率僅約 5%,這也是造成分析師所稱「4,010 億美元 AI 基礎設施問題」的因素之一。⁴ 即使在管理較完善的環境中,AI 推論工作負載的平均使用率也僅約 22%。依照該研究的判斷標準,任何使用率低於 40% 的 GPU 叢集,都意味著企業仍在為未被使用的運算容量付費。⁵

為什麼這樣的情況會一再發生?

  • GPU 資源配置以尖峰需求為準,而非平均使用量。 AI 模型訓練工作可能在數天內大量消耗運算資源,但訓練結束後,整個 GPU 叢集卻可能閒置數週。
  • 沒有人能清楚對應費用的負責單位。 GPU 執行個體往往不像一般運算資源一樣,依團隊、專案或模型進行標籤分類,導致財務部門無法將支出追溯至實際負責決策的人員。
  • 預留資源與隨需付費的選擇,往往只在採購時決定一次。 團隊在採購階段便選定計價模式,即使後續使用型態改變,也不會重新評估原有的費率選擇是否仍然適合。
  • 多雲環境讓問題更加複雜。 AWS、Azure、GCP 與 AliCloud 對 GPU 資源的定價與配置方式各不相同,要求團隊跨供應商手動比較,不僅耗時,也難以持續執行。

最終,企業對 AI 的投入速度超越了 AI 治理能力,而 GPU 支出也成為預算審查時,最難以完整說明的一項費用。

RATE 推出 GPU Utilization 使用率分析功能

GPU Utilization 延伸了 RATE 既有的 FinOps 管理引擎。原有平台已能在單一儀表板整合 AWS、Azure、GCP、AliCloud 與 Kubernetes 的成本資訊,如今進一步針對 AI 工作負載出現在雲端帳單後,企業最關心的兩項需求提供支援。

1. GPU 成本分攤,細至團隊與專案

RATE 現在能像管理一般運算資源一樣,透過標籤識別並歸屬 GPU 支出:

  • 依團隊、專案或模型確認成本歸屬。 不再只能看到「GPU 支出:34 萬美元」這樣的總額,而是能進一步辨識,究竟是哪個團隊的模型訓練作業,或哪個模型的推論工作負載正在產生成本。
  • 將 GPU 使用率與成本資訊對照呈現。 RATE 能同時顯示企業實際支付的費用,以及 GPU 資源的真正使用情況,讓閒置或過度配置的 GPU 資源自動浮現,不再隱藏於彙總帳單之中。
  • 提供可用於成本分攤的報表。 財務部門能依資源負責單位取得清楚且有依據的成本數據,工程團隊則無須增加額外的標籤管理負擔,也能建立對應的成本責任。

2. 多雲 GPU 定價與資源配置改善

RATE 能比較已連接雲端供應商的 GPU 定價與資源供應情況,並將分析結果轉化為可採取行動的建議:

  • 跨供應商價格比較。 比較 AWS、Azure、GCP 與 AliCloud 之間,相同等級 GPU 的價格差異,以及哪些供應商實際具備可用容量。
  • 預留、隨需與競價型執行個體的選擇建議。 RATE 會根據實際使用模式,建議適合的資源承諾與計價方式,而不是只依賴採購當下的一次性判斷。
  • 資源規格調整建議(Rightsizing)。 辨識規格過高、但實際使用率偏低的 GPU 執行個體,並提出改用較小規格或共用叢集的建議。

與 RATE 的其他功能相同,GPU Utilization 採用免安裝代理程式(Agentless) 的方式運作。企業無須在模型訓練叢集內安裝額外元件,不會增加效能負擔,也不必額外協調資安例外許可。

為什麼現在就必須重視,而不是等到明年?

GPU 價格持續上漲,企業一方面被期待增加 AI 預算,另一方面也必須證明投資報酬率(ROI)。這樣的雙重壓力,對無法回答基本成本問題的組織尤其不利:哪個團隊的 GPU 支出最高?我們是否正在為未使用的運算容量付費?目前採用的計價模式,真的符合實際工作負載的使用方式嗎?

根據 RATE 客戶的既有導入資料,企業在使用 RATE 管理雲端運算資源的前 30 天內,便已能辨識出約 25% 可立即著手改善的成本降低機會。⁶ GPU Utilization 的設計目標,就是將相同的成本管理原則,延伸至基礎架構預算中成長最快、卻也最缺乏透明度的領域。

想知道 GPU 預算究竟花在哪裡嗎?

預約產品展示(Book a Demo)


參考資料

  1. Nvidia reportedly raises GPU prices by 10-15% as manufacturing costs surge,Tom’s Hardware,2026。
  2. AMD to allegedly raise graphics card prices by at least 10% in 2026,Tom’s Hardware。
  3. Gartner: 6 trends shaping cloud computing through 2029,Channel Futures。
  4. 5% GPU utilization: The $401 billion AI infrastructure problem enterprises can’t keep ignoring,VentureBeat。
  5. AI Inference Cost Economics in 2026: GPU FinOps Playbook,Spheron Blog。
  6. 根據 RATE 客戶導入資料。另請參閱:Why is FinOps No Longer Optional?。
資訊悅報 Vol.67|Vicarius: PHP2Shell:兩項重大 PHP 漏洞與應變方式

部落格來源網址:PHP2Shell: Two critical PHP vulnerabilities and how to respond


PHP2Shell:兩項重大 PHP 漏洞與應變方式

研究發布日期:2026 年 10 月 21 至 22 日

PHP 執行環境近期揭露兩項重大漏洞,促使整個 Web 應用程式生態系緊急展開資安應變。2026 年 10 月 21 日公開的 CVE-2026-109618 與 CVE-2026-109619,統稱為 PHP2Shell,涉及 PHP 內部記憶體處理機制,可能讓未經身分驗證的攻擊者遠端執行程式碼(Remote Code Execution,RCE)。

兩項漏洞的通用漏洞評分系統(CVSS v4.0)分數均為 9.2,屬於重大風險。不同於依賴應用程式業務邏輯缺陷的漏洞,這兩項問題存在於 PHP 本身。即使網站或服務的應用程式程式碼遵循安全開發實務,仍可能面臨暴露風險。

對資安團隊而言,當務之急是找出受影響的 PHP 執行環境、在必要時降低暴露風險、部署已修補版本,並確認補救措施是否成功。

Vicarius 也提供兩項社群腳本,協助企業應變:

這些資源可協助漏洞偵測與風險降低,但不能取代安裝 PHP 官方安全更新。


什麼是 PHP2Shell?

PHP2Shell 是近期揭露的兩項 PHP 核心執行環境記憶體安全漏洞的統稱。

這兩項漏洞透過 Wiz Research 與 PHP 資安團隊共同參與的協調研究程序揭露。Google 也說明,AI 輔助漏洞探索及修補驗證在這項研究過程中所扮演的角色。

兩項問題都涉及 PHP 在處理 Web 請求期間,未能安全管理內部執行環境的記憶體與狀態。

在特定條件下,攻擊者可以操控 PHP 處理請求的方式,進而可能導致記憶體損毀、資訊洩露,或執行未經授權的程式碼。

關鍵差異在於,利用這兩項漏洞不需要應用程式本身存在不安全的 PHP 函式。攻擊面涵蓋負責處理請求的 PHP 執行環境,因此基礎架構層級的漏洞補救格外重要。

PHP 資安團隊認為,使用 mod_php 的 Apache 部署環境具有目前已證實的最高風險,但其他 PHP 執行環境也必須緊急檢視。


CVE-2026-109618:記憶體不足處理異常導致遠端程式碼執行

CVE-2026-109618 是一項重大記憶體損毀漏洞,涉及 PHP 處理記憶體不足情況時的運作方式。

當 PHP 遇到記憶體配置失敗時,程式執行可能中止,而部分內部請求資料結構仍處於尚未完全初始化的狀態。

在後續清理程序中,PHP 執行環境可能錯誤地將無效的內部資料視為合法資料,進而產生可能遭利用的記憶體損毀情況。

為什麼這個問題值得關注?

記憶體耗盡不一定只會發生在異常工作負載下。對外提供服務的 Web 應用程式,經常需要處理請求、表單資料、檔案上傳,以及其他可能影響資源消耗的輸入內容。

如果攻擊者能夠引導程式執行進入存在漏洞的失敗處理路徑,就可能觸發危險的清理行為。

若成功利用漏洞,攻擊者可能以受影響 PHP 程序的權限遠端執行程式碼。

如何緩解 CVE-2026-109618?

安裝已修補的 PHP 版本,是建議採取的正式補救措施。

如果無法立即安裝更新,PHP 官方安全公告提供了可降低特定攻擊路徑暴露風險的暫時性措施,包括:

  • 在適當的管理層級設定 memory_limit=-1,移除 PHP 可設定的記憶體限制所造成的失敗路徑,但仍須注意底層記憶體配置失敗的情況依然可能發生。
  • 在 PHP、Web 伺服器或 Proxy 層限制請求與檔案上傳大小。
  • 使用容器或 cgroup 資源限制,作為資源使用與服務可用性的控制邊界。
  • 確認應用程式層級的設定覆寫,不會使預期的防護措施失效。

這些措施可能影響應用程式行為與資源使用量,因此部署前應先完成測試。

Vicarius 社群資源: CVE-2026-109618 PHP2Shell 緩解腳本

在正式環境部署前,應先審查腳本、確認腳本的適用前提符合實際環境,並驗證執行效果。暫時性緩解措施不代表漏洞已完全消除。


CVE-2026-109619:全域狀態殘留導致遠端程式碼執行

CVE-2026-109619 涉及另一項 PHP 執行環境的記憶體管理弱點。

當屬於特定請求的內部狀態所依賴的記憶體已被釋放,但該狀態仍可被存取時,就可能產生此漏洞。

當同一個 PHP 工作程序(Worker)處理後續請求時,可能在正常初始化程序重新建立狀態之前,先遇到這些殘留的內部狀態。

這會形成記憶體釋放後使用(Use-After-Free)漏洞,可能導致記憶體損毀與遠端程式碼執行。

為什麼持續運作的 PHP 工作程序,使漏洞偵測更加重要?

PHP 部署環境通常使用工作程序處理多個請求。

重複使用工作程序有助於提升效能,但也讓不同請求之間是否能正確隔離變得格外重要。

如果內部狀態在原本應結束的生命週期之後仍然存在,後續請求就可能接觸到理應已不存在的資料。

這也是漏洞偵測不能只依賴應用程式原始碼檢查的原因之一。團隊還需要掌握正式環境實際使用的 PHP 執行版本與部署組態。

如何應對 CVE-2026-109619?

PHP 官方建議升級至已修補版本。

針對無法立即更新的環境,官方安全公告指出,下列設定措施可阻斷部分已確認的攻擊路徑:

  • 在請求解析開始前即生效的組態層級,設定 session.upload_progress.enabled=0。
  • 變更上述設定後,重新啟動受影響的 PHP 工作程序。
  • 如果使用 PHP 8.5,設定 fatal_error_backtraces=0,並重新啟動工作程序,以阻斷已確認的致命錯誤回溯攻擊路徑。
  • 將這些措施視為暫時性的風險降低方式,而非全面防護。

由於仍可能存在其他漏洞利用變化形式,因此即使成功調整組態,也不能據此認定仍有漏洞的 PHP 執行環境已經安全。

Vicarius 社群資源: CVE-2026-109619 PHP2Shell 偵測腳本

利用偵測結果辨識可能受影響的系統、安排調查優先順序,並支援後續補救規劃。即使腳本回傳陰性結果,也不能將其視為漏洞絕對無法遭利用,或系統從未遭入侵的確切證明。


哪些 PHP 版本受到影響?

這次揭露的漏洞涉及可追溯至 PHP 5.4 的版本,包括已停止支援的舊版本,以及先前仍屬現行版本的分支。

PHP 專案於 2026 年 10 月 21 日發布以下已修補版本:

PHP 版本分支 首個已修補版本
PHP 8.5 8.5.12
PHP 8.4 8.4.27
PHP 8.3 8.3.36
PHP 8.2 8.2.35
PHP 8.1 及更早版本 無標準官方上游安全更新版本;應升級或取得經確認且受供應商支援的安全更新

使用 Linux 發行版套件的組織,應確認該發行版供應商的安全公告,而不是只依賴顯示的 PHP 上游版本號判斷。部分長期支援版本的供應商,會將安全性修補程式回溯移植(Backport)至既有套件版本。

對於已停止支援的 PHP 版本,應優先規劃遷移至仍受維護的版本。


哪些系統暴露於 PHP2Shell 風險?

PHP 官方安全公告指出,下列多種執行環境都需要檢視:

  • 使用 mod_php 的 Apache HTTP Server 部署環境
  • 在 Nginx 或 Apache 後端運作的 PHP-FPM 環境
  • 使用 php-cgi 的部署環境
  • 以 FrankenPHP 建置的應用程式
  • LiteSpeed PHP 部署環境
  • 容器化及雲端託管的 PHP 服務

系統使用 PHP,並不代表每一種部署方式都會以相同方式遭到利用。實際暴露風險取決於執行環境版本、執行模式、組態設定、請求處理方式,以及其他技術條件。

然而,這兩項漏洞存在於應用程式層以下的執行環境。

即使應用程式維護良好,只要底層 PHP 執行環境存在漏洞,仍可能面臨暴露風險。

因此,組織應檢視基礎架構與執行環境清冊,而不能只依賴應用程式層級的漏洞評估。


PHP2Shell 的實務補救流程

應對重大漏洞,不能只停留在掃描器識別出 CVE 的階段。

資安與基礎架構團隊必須將漏洞情資轉化為適用於各環境的安全變更,並在執行後確認變更確實生效。

步驟一:盤點所有 PHP 執行環境

盤點實體伺服器、虛擬機器、容器、應用程式映像檔與託管服務中的 PHP 安裝情況。

檢查正式環境、測試環境、可從不受信任網路存取的開發環境,以及可能使用不同 PHP 執行檔或執行環境的系統。這些系統所使用的 PHP 版本,可能與命令列介面顯示的版本不同。

例如,可以先使用下列指令:

php -v

這項指令會顯示目前呼叫的 PHP 命令列介面(CLI)執行檔版本,但不一定代表 Web 伺服器或 PHP-FPM 工作程序實際使用的版本。

完整的資產探索必須涵蓋真正負責處理請求的 PHP 執行環境。

步驟二:優先處理對外提供服務的應用程式

先從處理不受信任 Web 請求的系統著手,尤其是 PHP 官方安全公告指出具有最高風險的部署組態。

優先順序評估應考慮:

  • 服務是否可透過公開網路存取
  • 已安裝的 PHP 版本與供應商修補狀態
  • 部署模式及已確認的攻擊路徑
  • 應用程式是否能存取敏感資料或其他相連系統
  • 現有安全控制措施,以及可採取的暴露風險降低方式

避免只使用 CVSS 分數決定漏洞補救順序。即使兩個系統受到相同漏洞影響,其實際營運風險與業務風險仍可能不同。

步驟三:執行適當的偵測檢查

資安團隊可以利用漏洞清冊、組態檢查、供應商安全公告比對,以及專門設計的偵測腳本,判斷哪些系統需要進一步處理。

Vicarius 針對 CVE-2026-109619 提供一項社群資源:

執行或檢視 PHP 全域狀態殘留漏洞偵測腳本

在依據腳本結果進行判斷前,應先確認腳本支援的作業系統、所需權限、運作邏輯及輸出內容。

記錄可能存在的暴露風險、受影響資產,以及偵測方法的限制。

步驟四:套用安全更新或暫時性緩解措施

最優先的行動,是安裝適當的已修補 PHP 版本,或經確認已回溯移植安全修補程式的供應商更新。

若安裝更新需要額外測試或等待維護時段,團隊可評估影響範圍明確的暫時性控制措施。

針對 CVE-2026-109618,應搭配 PHP 官方安全公告,一併檢視 Vicarius PHP2Shell 緩解腳本。

涉及 PHP 資源處理的變更,應以貼近實際應用程式工作負載與資源限制的條件進行測試。

暫時性防護措施能在正式修補期間協助降低風險,但不應無限期取代正式補救作業。

步驟五:驗證補救結果

軟體更新工作顯示已完成,不代表正在執行的應用程式就一定受到保護。

部署更新後,應確認:

  1. 已安裝的 PHP 執行環境包含適當的修補程式,或供應商回溯移植的安全更新。
  2. 對外服務的 PHP 工作程序已使用更新後的執行環境。
  3. 必要時,容器或應用程式服務已完成重新部署。
  4. 應用程式功能與服務可用性仍維持正常。
  5. 暴露風險或漏洞檢查結果,不再識別出相關的未修補 PHP 執行環境。

保存已安裝修補程式及實際執行組態的佐證資料。

這能更清楚區分「已嘗試執行補救措施」與「已驗證的資安成果」。


為什麼 PHP2Shell 修補也是一項曝險管理挑戰?

PHP2Shell 漏洞揭露反映了資安團隊熟悉的難題:發現重大漏洞的速度,可能遠快於在所有受影響系統中安全降低風險的速度。

單一組織可能透過不同的 Linux 發行版、雲端服務、容器、應用程式團隊及舊有平台執行 PHP。

每種環境可能需要不同的更新機制或維護程序。

部分系統可以直接更新,其他系統則需要相容性測試、應用程式負責人核准,或先行採取暫時性的暴露風險降低措施。

因此,漏洞補救不只是漏洞情資問題,也是跨團隊協作問題。

最有效的應變方式,應串接以下四項活動:

探索(Discovery): 確認受影響軟體實際運作於哪些系統。

優先排序(Prioritization): 判斷哪些存在漏洞的系統造成最大的暴露風險。

補救(Remediation): 部署受支援的更新,以及適當的暫時性控制措施。

驗證(Validation): 確認預期的變更已生效,並掌握剩餘風險。

對需要管理大量端點與伺服器的組織而言,這種方法有助於縮短從發現重大漏洞,到取得暴露風險已獲處理之佐證的時間。


Vicarius 如何支援漏洞補救?

Vicarius 將漏洞補救視為一項實際維運流程,結合軟體與漏洞可視性,以及不同的補救方式。

依據受影響系統及可用的補救選項,資安團隊可能需要部署修補程式、執行已核准腳本,或在正式修補準備完成前,先採取暫時性的補償性控制措施。

PHP2Shell 漏洞事件說明了,為什麼這些方法需要相互串接。

偵測有助於確認哪些系統需要處理。暫時性緩解措施可以降低部分攻擊路徑的風險。官方修補程式則用於處理底層漏洞。最後,透過驗證確認預期的補救措施是否成功部署。

Vicarius 的 vSociety 社群提供腳本與技術補救資源,供團隊評估並納入相關流程。

針對 PHP2Shell,可以先參考以下兩項資源:

CVE-2026-109618:緩解措施

查看 PHP2Shell 重大遠端程式碼執行漏洞緩解腳本

CVE-2026-109619:漏洞偵測

查看 PHP 全域狀態殘留記憶體釋放後使用漏洞偵測腳本

部署前應先審查並測試這些腳本,並搭配官方供應商指引解讀執行結果。


常見問題

什麼是 PHP2Shell?

PHP2Shell 是 CVE-2026-109618 與 CVE-2026-109619 的統稱。這是兩項於 2026 年 10 月 21 日揭露的 PHP 重大記憶體安全漏洞,皆可能導致未經身分驗證的遠端程式碼執行。

PHP2Shell 漏洞的嚴重程度為何?

兩項 CVE 的 CVSS v4.0 分數均為 9.2,屬於重大風險。實際可被利用的風險會因 PHP 執行環境版本、組態及部署方式而有所差異。

PHP2Shell 可以在未經身分驗證的情況下遭利用嗎?

可以。PHP 資安團隊已確認這兩項漏洞存在未經身分驗證即可遠端執行程式碼的風險,並已證實在 mod_php 部署環境中,攻擊可於應用程式程式碼執行前觸發。但這不代表所有 PHP 組態都具有相同的攻擊路徑。

哪些 PHP 版本已修補 CVE-2026-109618 與 CVE-2026-109619?

已修補的上游版本為 PHP 8.5.12、8.4.27、8.3.36 及 8.2.35。使用由供應商維護之發行版的組織,應確認安全修補程式是否已回溯移植。

不安裝修補程式,能否完整緩解 PHP2Shell?

不能。PHP 官方明確提醒,暫時性緩解措施只能處理特定攻擊路徑。安裝已修補版本,或經確認的供應商安全更新,才是安全的正式補救方式。

資安團隊如何偵測可能存在的暴露風險?

團隊應盤點 PHP 執行環境、比對已安裝版本與供應商安全公告、評估相關組態,並使用適當的偵測資源。Vicarius 在 vSociety 上提供針對 CVE-2026-109619 的偵測腳本。

使用 WordPress 或其他 PHP 應用程式的網站會受到影響嗎?

如果 PHP 應用程式使用存在漏洞的 PHP 執行環境,就需要進行風險檢查。特定部署是否可遭利用,取決於執行環境及組態設定。只更新內容管理系統(CMS)或應用程式本身,不一定會同步更新 PHP。


最後提醒

CVE-2026-109618 與 CVE-2026-109619 再次提醒我們,重大應用程式暴露風險不一定源自應用程式程式碼,也可能存在於程式語言本身的執行環境。

對資安團隊而言,當務之急非常明確:找出存在漏洞的 PHP 部署環境、安裝官方安全更新、只在必要時使用暫時性防護措施,並確認正式環境實際執行的 PHP 已完成更新。

前往 vSociety 探索 Vicarius 的 PHP2Shell 腳本資源,協助漏洞調查與補救規劃;或洽詢 Vicarius 產品展示,進一步了解如何在企業環境中落實漏洞補救作業。

資訊悅報 Vol.66|Bitdefender: 攻擊面擴大得比防護還快,如何提前關閉入侵破口?

部落格來源網址:https://www.bitdefender.com/en-us/blog/businessinsights/attack-surface-exposure-management?utm_source=chatgpt.com 


資安團隊不可能永遠靠加快回應速度來應付威脅。隨著 AI 協助攻擊者加速偵察與漏洞利用,企業必須從一開始就減少可能促成攻擊的機會。
這需要企業將防護重心轉向預防,並以更全面的角度檢視曝險風險。未修補的應用程式固然值得關注,但不必要的管理員權限、被遺忘的對外服務,或是開放給根本不需要這些工具的人員使用的合法工具,同樣可能帶來風險。這些弱點單獨存在時,可能不會引起太多注意,但一旦彼此串連,就可能形成攻擊者通往企業關鍵系統與資料的入侵路徑。

曝險管理策略能協助企業了解這些風險之間的關聯,並在攻擊者採取行動之前先行處理。對人力精簡的 IT 與資安團隊而言,這也是降低工作負擔的實際方法:攻擊者可利用的機會越少,需要調查與回應的告警也可能隨之減少。


為什麼現在更需要曝險管理?

AI 正從多個方向對資安防護帶來壓力。攻擊者可以利用 AI 加快攻擊行動,而員工採用 AI 應用程式、助理與 Agent,也增加了企業必須保護的存取管道及互動行為。

偵測與回應仍然不可或缺。然而,如果將大部分防禦責任都交給這兩項機制,資安團隊就必須仰賴快速辨識並阻斷每一次入侵行動。

與此同時,許多攻擊機會其實來自企業環境中原本就存在的功能與工具。Bitdefender Labs 分析了 700,000 起資安事件,發現有 84% 的重大攻擊涉及 Living off the Land(LotL,濫用系統既有合法工具)技術。單靠修補程式,並無法解決這類攻擊手法得以利用的不必要存取權限問題。

這項挑戰也反映在日常維運上。根據《2026 Bitdefender Cybersecurity Assessment》調查,38% 的資安專業人員指出,維護系統強化規則與例外設定所帶來的管理負擔,是縮減攻擊面的一項障礙。

企業需要的預防措施,必須能夠隨著環境變化持續調整,同時符合實際負責資安防護人員的工作負荷與資源條件。


什麼是曝險管理策略?

曝險管理是一項持續性的工作,目的在於辨識、排定優先順序並降低企業攻擊面中可能遭攻擊者利用的弱點。

曝險管理的範圍超越傳統弱點管理。軟體漏洞只是其中一部分,其他還包括錯誤組態、對外暴露的服務、身分識別風險,以及對高權限工具不必要的存取能力。

有效的曝險管理策略,必須串連三項活動:

  • 首先,建立對相關曝險風險的可視性。
  • 其次,結合環境脈絡資訊排定風險優先順序,包括攻擊者可能接觸到哪些資產。
  • 最後,降低這些曝險風險,並重新評估環境狀態。

這是一項必須持續進行的工作,因為每當帳號取得更多權限、服務開放對外存取,或企業業務需求發生變化時,曝險情況也會跟著改變。威脅曝險管理(Threat Exposure Management)提供了一套架構,協助企業將這些活動組織成可重複執行的流程。技術可以支援這項計畫,但明確的責任歸屬與後續執行,才是讓策略真正發揮效益的關鍵。


GravityZone 如何將風險可視性轉化為主動預防?

Bitdefender GravityZone Exposure Management 整合風險可視性、優先順序判定與適應式系統強化能力,協助資安團隊減少攻擊者可利用的機會。
Endpoint Risk Management(端點風險管理)可辨識軟體漏洞與高風險組態;External Attack Surface Management(EASM,外部攻擊面管理)則從攻擊者的外部視角,掌握企業對外暴露的資產與服務。使用者風險洞察與 Unified Identities(統一身分識別)則協助團隊了解可能導致曝險的帳號、行為及存取權限。

此外,Attack Path Analysis(攻擊路徑分析)能將不同的風險發現相互關聯,呈現攻擊者可能通往關鍵資產的路徑。這些脈絡資訊可能改變修正工作的優先順序。例如,具有高權限使用者的工作站即使只有一項中度嚴重性的漏洞,也可能比隔離系統上的高嚴重性風險更值得優先處理。

這項能力還能協助團隊辨識多條攻擊路徑之間的共同節點,使單一修正措施有機會同時阻斷多條潛在攻擊路徑。分析功能會根據現有風險發現資料建立關聯模型,但團隊仍須自行評估並執行適當的修正措施。

不過,資安團隊也能透過 GravityZone PHASR(Proactive Hardening and Attack Surface Reduction,主動強化與攻擊面縮減)加入自動化防護措施。PHASR 能學習每一組設備與使用者的實際操作方式,限制不必要的工具存取及攻擊者經常濫用的高風險行為。當正常工作需求改變時,系統強化政策也能隨之調整。


企業可以期待哪些成效?

持續性曝險管理最主要的成果,是減少系統遭入侵的機會。關閉對外暴露的服務、修正危險組態,或限制不必要的工具存取,都能消除部分攻擊入口,或限制攻擊者下一步可以採取的行動。

更精準的優先順序判定,也能協助團隊將有限資源投入影響最重大的工作。例如,假設某個管理員帳號與多條潛在攻擊路徑相連,移除不必要的存取權限,就可能同時降低多個系統的曝險風險,讓團隊更清楚了解為什麼應優先執行這項調整。

動態系統強化也能減少人工維護安全政策的工作量。PHASR 允許團隊檢視強化建議,或透過 Autopilot 模式自動套用。所有變更皆會留下稽核紀錄,也可以還原;當合法工作需要使用特定工具時,團隊仍可授予存取權限。這些保護機制能協助企業在降低風險的同時,管理安全措施對日常作業造成的影響。

另一項成果是讓改善進度更容易被具體呈現。管理階層可以追蹤風險態勢的變化,以及新增或已解決的攻擊路徑,將資安團隊的工作成果與已阻斷的關鍵資產攻擊路徑建立關聯。

減少攻擊機會,有助於降低各種規模資安團隊的工作壓力,對人力精簡的團隊尤其重要。


人力精簡的團隊,如何落實曝險管理策略?

從企業的業務優先事項著手,先確認哪些系統、身分識別帳號與服務一旦遭到入侵,將造成最大的損害。接著建立風險可視性、辨識高風險曝險項目,並明確分派降低風險的責任。完成調整後,再重新評估環境,確認改善成果並找出下一步需要處理的問題。

GravityZone Exposure Management 可在 GravityZone 平台內,或與第三方端點防護及 EDR 產品搭配使用,以支援並簡化上述流程。企業可以延續既有資安投資,並透過額外授權的功能擴充曝險管理計畫,包括自動化修補程式管理、雲端安全態勢管理,以及 GravityZone AI Visibility and Control。

最終的策略目標,是透過持續降低風險,讓主動預防成為日常資安維運的一部分,協助企業在攻擊機會演變成實際資安事件之前,先行關閉這些破口。

深入了解 Bitdefender GravityZone Exposure Management


資訊悅報 Vol.65|Idira:保護機器與 AI Agent 身分:現代特權存取管理的下一道課題

部落格來源: Securing Machine and Agentic Identities: The Next Frontier of Modern PAM


如今,機器身分的數量已是人員身分的 109 倍,而且差距仍在擴大。

DevOps 流水線、雲端工作負載,以及 AI Agent 的快速普及,正使非人類身分成為資安領域成長最快的攻擊面。依原文引述,目前已有 99% 的組織使用 AI Agent。

我們在上一篇文章談到,企業中的每個身分都可能擁有特權。現代特權存取管理(PAM)必須將權限控管延伸至員工、端點、雲端基礎架構與 AI Agent。保護人員存取仍然重要,但企業的運作重心已經轉移。

在 Unit 42 近期處理的事件應變調查中,近 90% 的案件與身分安全弱點有實質關聯。攻擊者不再只是突破防線進入系統,也會利用竊得的機器憑證登入、濫用常駐權限,再沿著隱蔽的存取路徑橫向移動。

Unit 42 近期的一項調查顯示,這類風險擴散得有多快:攻擊者利用先進 AI Agent,在不到 10 小時內穿行企業網路。我們的應對速度也必須跟上。

要阻止以機器速度發動的攻擊,身分安全就不能只圍繞人員作業流程設計,而必須透過單一平台發現、控制並治理機器與 AI Agent 身分。


非人類身分需要新的管理模式

過去,組織並未充分關注機器與 Agent,也就是所謂的非人類身分。它們在幕後運作,規模與速度都和員工身分截然不同。

早期的主要風險,是寫死在程式中的機密資訊外洩,以及人工流程造成的設定錯誤。隨著雲端與 SaaS 加速普及,短暫存在的容器和工作負載可能在數秒內啟動、終止,各平台採用的驗證方式又不相同。結果是保管庫越建越多、工具各自為政:密碼、API 金鑰、權杖及各類機密資訊,散落在雲端保管庫、CI/CD 流水線、設定檔與應用程式碼中。多年來,組織持續以人工方式和分散工具勉強因應,卻沒有建立穩固的機器身分基礎,風險因此不斷累積。

如今,企業又將 AI Agent 加入這個已經混亂的環境。Agent 擁有較高權限,行為路徑也未必能事先預測,不僅放大既有風險,也帶來新的風險。

機器與 AI Agent 身分大量增加,讓權限控管缺口持續擴大。企業需要以穩固的機器及 Agent 身分基礎,建立新的管理模式。

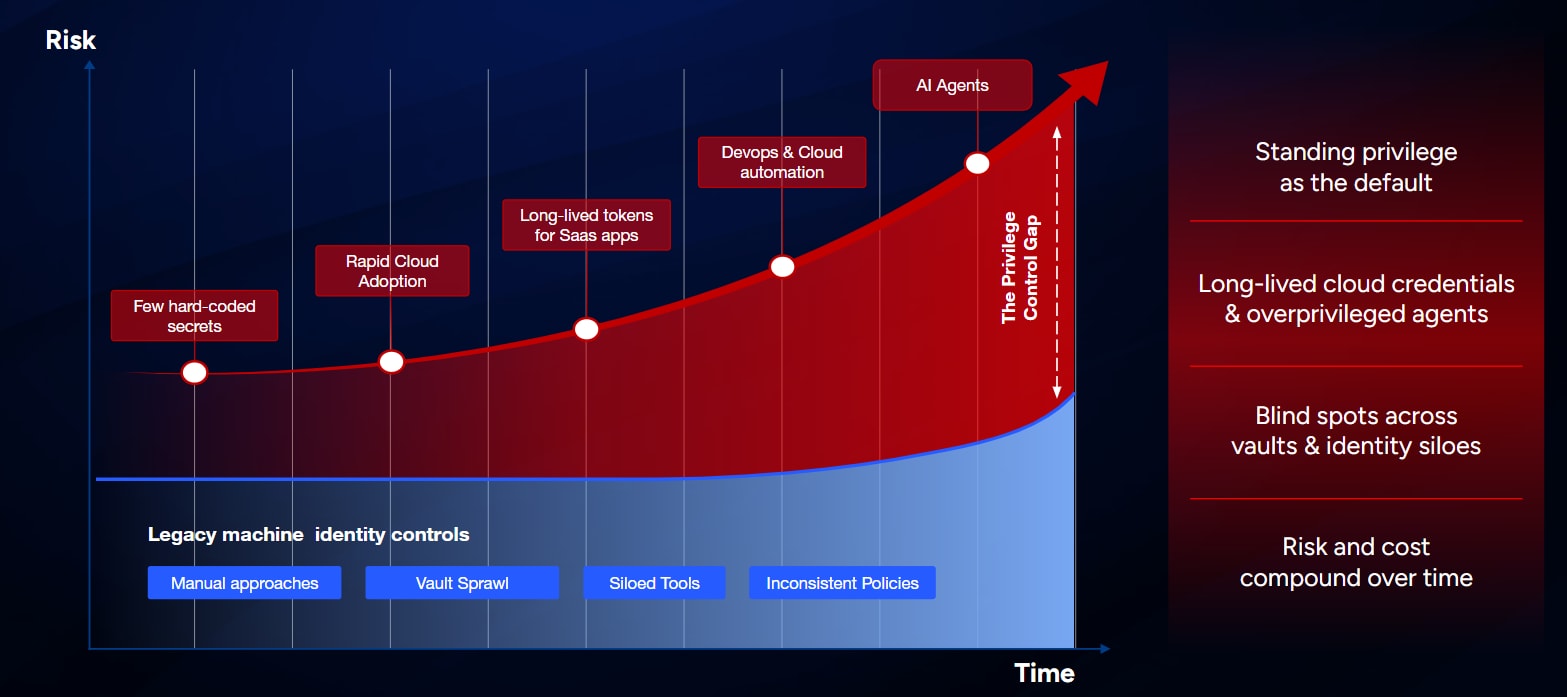
圖說:既有的機器身分控管方式逐漸失效,風險也隨時間持續累積。

根本挑戰可歸納為三個 V:數量、種類與速度。

  • 數量(Volume):機器身分的數量遠超過人員身分。動態工作負載與自主 AI Agent 的新增成本相對低,使兩者的數量差距每天都可能擴大。
  • 種類(Variety):在混合雲、多雲及跨世代的企業環境中,非人類實體使用的存取憑證種類繁多,包括 API 金鑰、OAuth 權杖、JSON 權杖、SSH 金鑰、資料庫憑證與 SSL 憑證。
  • 速度(Velocity):工作負載與 AI Agent 以機器速度運作,可能在數秒內擴增或縮減。安全控管必須動態調整,同時避免拖慢開發與業務運作。

把人員 SSO 直接延伸到 Agent 的盲點

組織急著導入 AI Agent 時,身分安全團隊往往立刻接到「讓 Agent 能夠存取」的要求,即使組織尚未釐清整體機器身分策略也是如此。

AI Agent 的行為可能像人,但必須以機器工作負載的方式保護。

由於 AI Agent 的行為看似接近人員,組織容易將 Agent 歸入員工身分管理範圍,把單一登入(SSO)等能力直接延伸給 Agent。

這種做法有問題。SSO 原本是為了解決人員身分的存取需求,讓員工不必記住多組密碼,也能順暢使用各項應用程式。但 Agent 以機器速度運作,也可能產生幻覺。將為人員設計的身分與存取管理(IAM)思維直接套用到 Agent,本身就帶有風險。

AI Agent 的行為可能像人,但必須以機器工作負載的方式保護。

更合適的出發點,是將 AI Agent 視為機器身分的下一個發展階段。它們更接近雲原生工作負載,能依需求啟動與終止,其運作規模及速度,也超出以人員為中心的 IAM 系統原本要處理的範圍。


呼應 Gartner 指引:將 AI Agent 視為工作負載

Gartner 在 2026 年 6 月的研究《IAM for AI Agents: A One-Size-Fits-All Strategy Is Guaranteed to Fail》中指出,若將 AI Agent 視為全新且類似人員的使用者族群,組織容易陷入分析癱瘓。Gartner 建議採用工作負載的觀點,把 AI Agent 視為工作負載,藉此運用既有的 IAM 工具、標準及安全控管。第一步是透過 SPIFFE,為每個 AI Agent 指派專屬的工作負載身分。

為 AI Agent 指派工作負載身分後,組織便有機會運用既有的機密資訊管理、端點防護及即時特權存取管理(JIT PAM)投資,治理 Agent 暫時使用人員身分的情況。

此外,Gartner 建議組織採用已經成熟的 OAuth 2.0 架構,讓人員能將存取權委派給 Agent 與工作負載,而不必從頭建立另一套機制。


Idira 如何處理機器與 AI Agent 身分

呼應 Gartner 的指引,Idira 身分安全平台將 AI Agent 當作自主運作的工作負載來管理。這種整合方式,把組織已在使用的機器身分與機密資訊管理能力,延伸到 AI Agent 安全。

這與以人員為中心的 IAM 供應商做法有根本差異。其設計考量的是未來可能有數百萬個 Agent 與其他機器工作負載並存,並在多個信任網域之間建立聯邦關係。Idira 在單一整合平台中支援標準協定,包括用於驗證的 SPIFFE,以及用於授權的 OAuth 2.0,讓 Agent 與工作負載能運用企業環境中的機密資訊、API 金鑰及其他機器憑證。

從機器身分基礎做起

Idira 的方法,是提供穩固的機器身分基礎,讓組織在擴大 Agent 與機器工作負載使用規模時,仍能維持安全,而不是只將員工 SSO 延伸給 Agent。

這個基礎不僅為每個工作負載與 Agent 提供符合標準、可透過密碼學驗證的身分,也建立必要的底層機制,讓任何工作負載都能跨環境存取所需的目標資源。

無論是混合環境、多雲,或橫跨新舊系統的企業架構,都不應成為阻礙。企業應能持續開發與調整,不必為每個目標資源反覆煩惱該使用哪種存取方式,也不必擔心意料之外的 Agent 取得關鍵業務資產的權限。

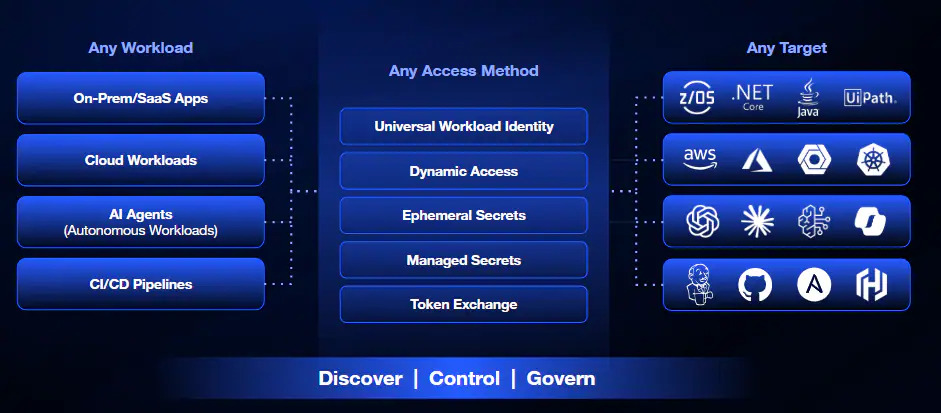
圖說:可隨規模擴充的機器與 Agent 身分基礎。

這種以共同基礎管理 Agent 的做法,也能避免企業為 AI Agent 再建立一個與其他機器工作負載分離的新孤島。


為行為路徑難以預測的工作負載建立新的 Agent 控管能力

AI Agent 能推理、做決策,並透過未必能事先預測的路徑完成目標;這是它們與其他機器工作負載的差異。

機器身分是基礎,Agent 控管則是下一層。兩者結合,才能將安全與權限控管延伸至這些行為路徑不固定的執行者,同時避免形成新的管理孤島。

這個領域的主要創新包括:

  • 統一的 Agent 與 MCP 登錄機制
  • Agent 身分代理
  • 嚴謹的存取政策
  • 短效權杖
  • 明確區分 Agent 與人員的稽核紀錄
  • Agent 活動關聯圖

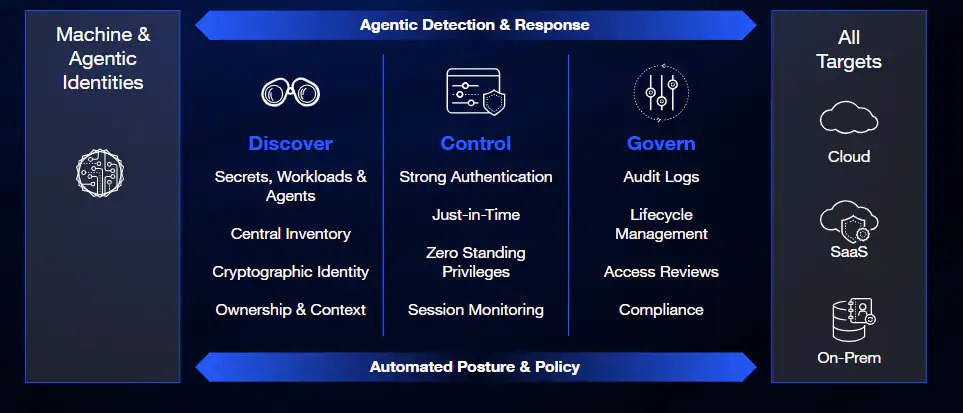
圖說:Idira 針對機器與 AI Agent 身分所建立的發現、控制與治理框架。

我們仍在這個快速演進的領域開發更多新能力,未來幾個月將陸續公布。


發現、控制並治理每個身分

Idira 將非人類身分安全整合為單一管理框架,涵蓋三大支柱:

  • 發現:在混合雲及多雲環境中,自動找出機密資訊、雲端保管庫、機器工作負載與 AI Agent,並將這些實體納入中央登錄機制,補齊負責人、存取權限及風險狀態等資訊。
  • 控制:透過 Idira Agent Identity Broker,落實強式驗證、零常駐特權(ZSP),以及依任務即時授予的存取權限;同時管理代理他人執行任務時的權限委派流程,將 Agent 行為與人員使用者的工作階段區分開來。
  • 治理:透過詳細的稽核紀錄、區分人員與 Agent 行為、自動化權限審查,以及從啟用到停用的完整生命週期治理,持續符合合規要求。

Idira Activity Insights 呈現 AI Agent 如何代表人員與工具互動。

為在整個 AI 生命週期提供完整防護,Idira 的 Agent 身分能力以 AI Identity Security 模組的形式,原生整合至 Prisma AIRS 3.0。搭配 AI Gateway 的執行階段控管,組織便能在維持企業安全的同時擴大 AI 創新應用。相關資訊將於後續公布。


以機器速度保護非人類身分

保護由 AI 驅動的企業,需要一套以身分為核心、能以機器速度運作的控制架構。Idira 整合人員、機器與 Agent 身分防護,協助組織消除常駐權限風險、保護關鍵機密資訊,並更有信心地部署自主運作的 Agent 流程。

想了解實際運作方式嗎?歡迎預約 Idira Machine and Agentic Identity Security 的客製化展示。


常見問題

SPIFFE 如何支援 AI Agent 身分安全?

SPIFFE 為工作負載核發可透過密碼學驗證的短效身分。將 AI Agent 視為 SPIFFE 架構下的工作負載,有助於在多雲環境中實現機密資訊自動化管理與細緻的存取治理。

機器身分與 AI Agent 身分有什麼差別?

機器身分是指靜態應用程式與容器使用的非人類憑證,例如 API 金鑰、憑證及服務帳號。AI Agent 身分則代表能自主做出決策、連續呼叫工具完成多步驟任務的 AI Agent,因此需要依即時任務控管存取權限。

Idira 如何與 Prisma AIRS 3.0 整合?

Idira 擔任其 AI Identity Security 控制層,管理身分治理、代理他人執行任務時的權限委派流程,以及機密資訊。Prisma AIRS 則涵蓋 AI 生命週期的端到端安全,保護從開發到部署階段的 AI Agent、應用程式、模型與資料。

資訊悅報 Vol.64|RE:FORM REASON: 多數服務中斷都始於一次變更:REASON Change Adviser 正式登場


多數服務中斷都始於一次變更:REASON Change Adviser 正式登場

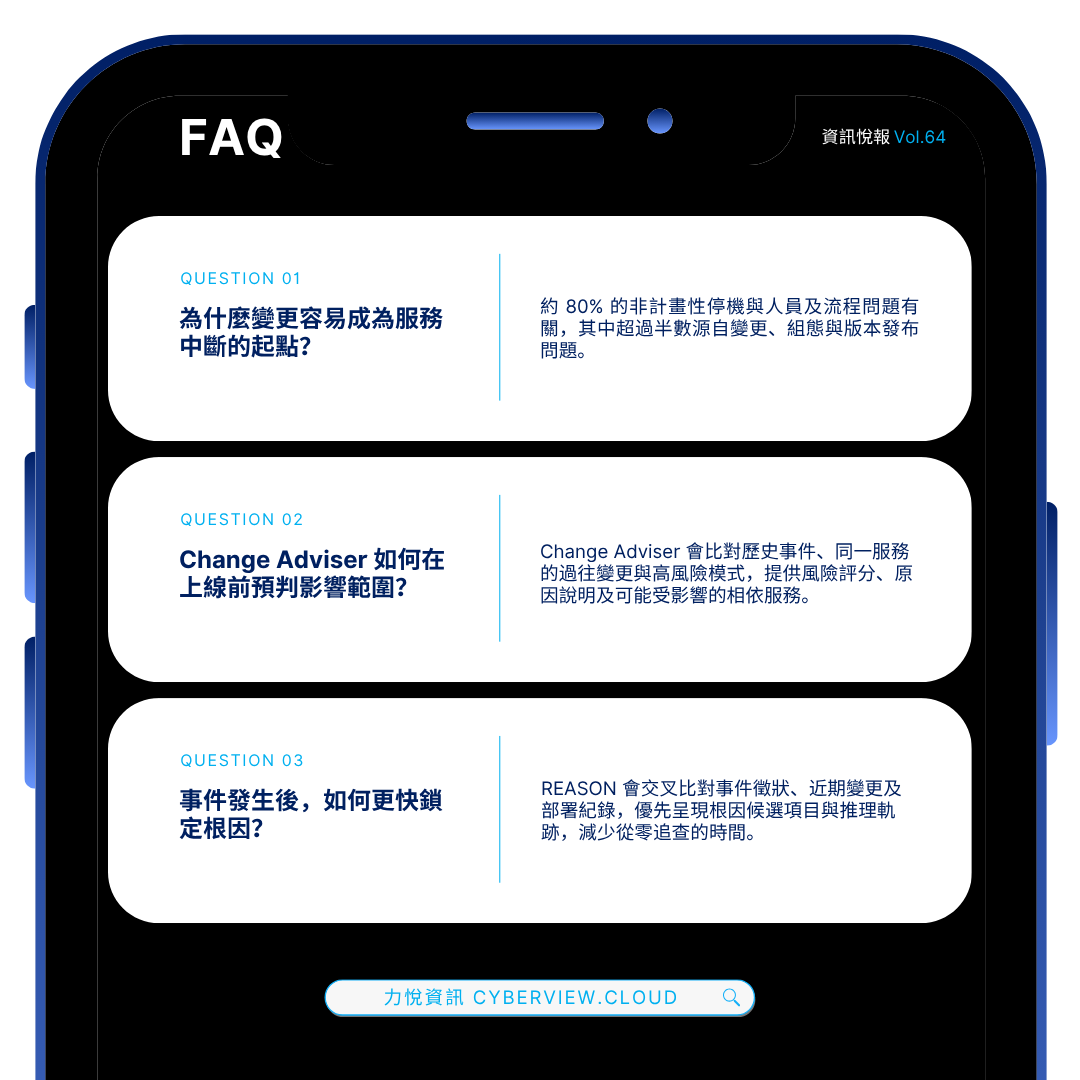
Gartner 研究團隊用數據量化了每位值班工程師早已憑直覺知道的事:影響關鍵任務服務的非計畫性停機,約有 80% 可追溯至人員與流程問題,而非硬體或災害;其中超過半數更明確源自變更、組態與版本發布問題。¹

換句話說,多數事件並非始於難解的謎團,而是始於一次部署、一項組態修改,或某人在週五下午核准的「小」變更。

REASON 已能在事件發生後進行推理,如同團隊中最優秀的工程師,將告警轉化為可執行的修復措施。Change Adviser 將同一套推理引擎往前推進一步,讓更多事件根本不會演變成告警。


沒有人有時間追查的變更與事件關聯

變更管理失效,不是因為團隊不在乎,而是因為真正重要的兩套系統——變更紀錄與事件歷史——通常彼此不相通。

結果隨處可見:

  • 風險評估只是勾選欄位,而非實質分析。 變更諮詢委員會根據描述欄位與直覺判斷核准變更,而非檢視相似變更過去曾對系統造成哪些實際影響。
  • 根因調查每次都從零開始。 事件發生時,工程師必須手動翻查近期部署、組態修改與基礎架構變更,才能找出可能的觸發原因,往往將事件處理最寶貴的時間耗費在搜尋上。
  • 相同錯誤在不同團隊間重複發生。 某項變更六個月前曾造成一項服務中斷,卻又在另一項服務中獲得核准,只因為沒有人將兩者關聯起來。
  • 70% 的變更計畫難以按照原定規畫落實。 缺少回饋循環時,組織便無法辨識自身哪些變更持續帶來較高風險。²

這與其說是推理失效,不如說是可視性不足。預防或診斷多數事件所需的資訊其實早已存在,只是分散在工單系統、部署紀錄,以及團隊口耳相傳的經驗之中。


REASON Change Adviser 正式登場

Change Adviser 將 REASON 的 Tree of Thought 推理與您的變更及部署歷程連結,並運用在事件生命週期中的兩個階段:

1. 變更前風險評分

部署或組態變更上線前,REASON 會分析您的歷史事件資料、同一服務過去的變更,以及已知的高風險模式,產出風險評分,並以易於理解的文字說明評分原因。

  • 預測影響範圍。 REASON 會根據過往事件,標示變更一旦出錯,最可能受到影響的下游服務與相依項目。
  • 依歷史案例推理,而非採用靜態檢核表。 REASON 不使用固定規則引擎,而是將預定變更拆解為可驗證的假設,再逐一對照您的實際歷史紀錄,方式與分析即時事件時相似。
  • 為核准環節而設計。 風險評分與推理軌跡會直接寫入既有的變更申請或 CAB 工作流程,讓審查人員不必離開原本使用的工具,就能取得第二意見。

2. 變更與事件關聯分析

事件發生時,REASON 會自動檢查近期變更與部署紀錄,將其列為可能的根因候選項目;這項分析在工程師開啟終端機前就已開始。

  • 縮短建立假設的時間。 REASON 會交叉比對事件徵狀,以及受影響服務與其相依項目的近期變更,優先呈現最可能的原因。
  • 依據證據,而非猜測。 每個候選項目都附有相應的推理軌跡,讓工程師能快速驗證或排除,不必毫無線索地從頭展開調查。
  • 回饋至循環。 每項經確認或排除的關聯都會成為訓練訊號;同一套人員回饋循環,也會讓 REASON 的事件分流隨時間逐步提高準確度。

Change Adviser 採用與 REASON 其他功能相同的架構:預設採地端部署,不綁定特定 LLM 或 GPU,並可透過 MCP、API 或 A2A 整合至您既有的 ITSM 與部署工具。不需要遷移資料,也不必重建工作流程。


以同一套推理引擎實現預防與應變

多數工具將變更風險與事件應變視為兩個不同領域,並分別使用兩套工具處理。Change Adviser 則將兩者視為同一個問題:讓 REASON 能在正式環境中進行事件分流的推理能力,正是在高風險變更演變成事件前將其找出的必要能力。

對於同時使用 REASON 與 RE:FORM DEPLOY 的團隊而言,這能進一步完成整個循環——從變更如何發布、核准時能有多大把握,到問題仍然發生時能多快完成診斷。


準備好在高風險變更演變成事件之前,先一步將它找出來了嗎?

預約產品展示


1 Gartner RAS 核心研究:非計畫性停機,以及變更、組態與版本發布管理;經 2026 年產業變更管理研究引述。

2 變更管理統計,2026 年產業報導。


資訊悅報 Vol.63|Vicarius: 漏洞工單六週仍未清空?2026 年持續威脅暴露管理(CTEM)導入指南

部落格來源網址:How to implement CTEM in 2026


如何在 2026 年導入持續威脅暴露管理(CTEM)

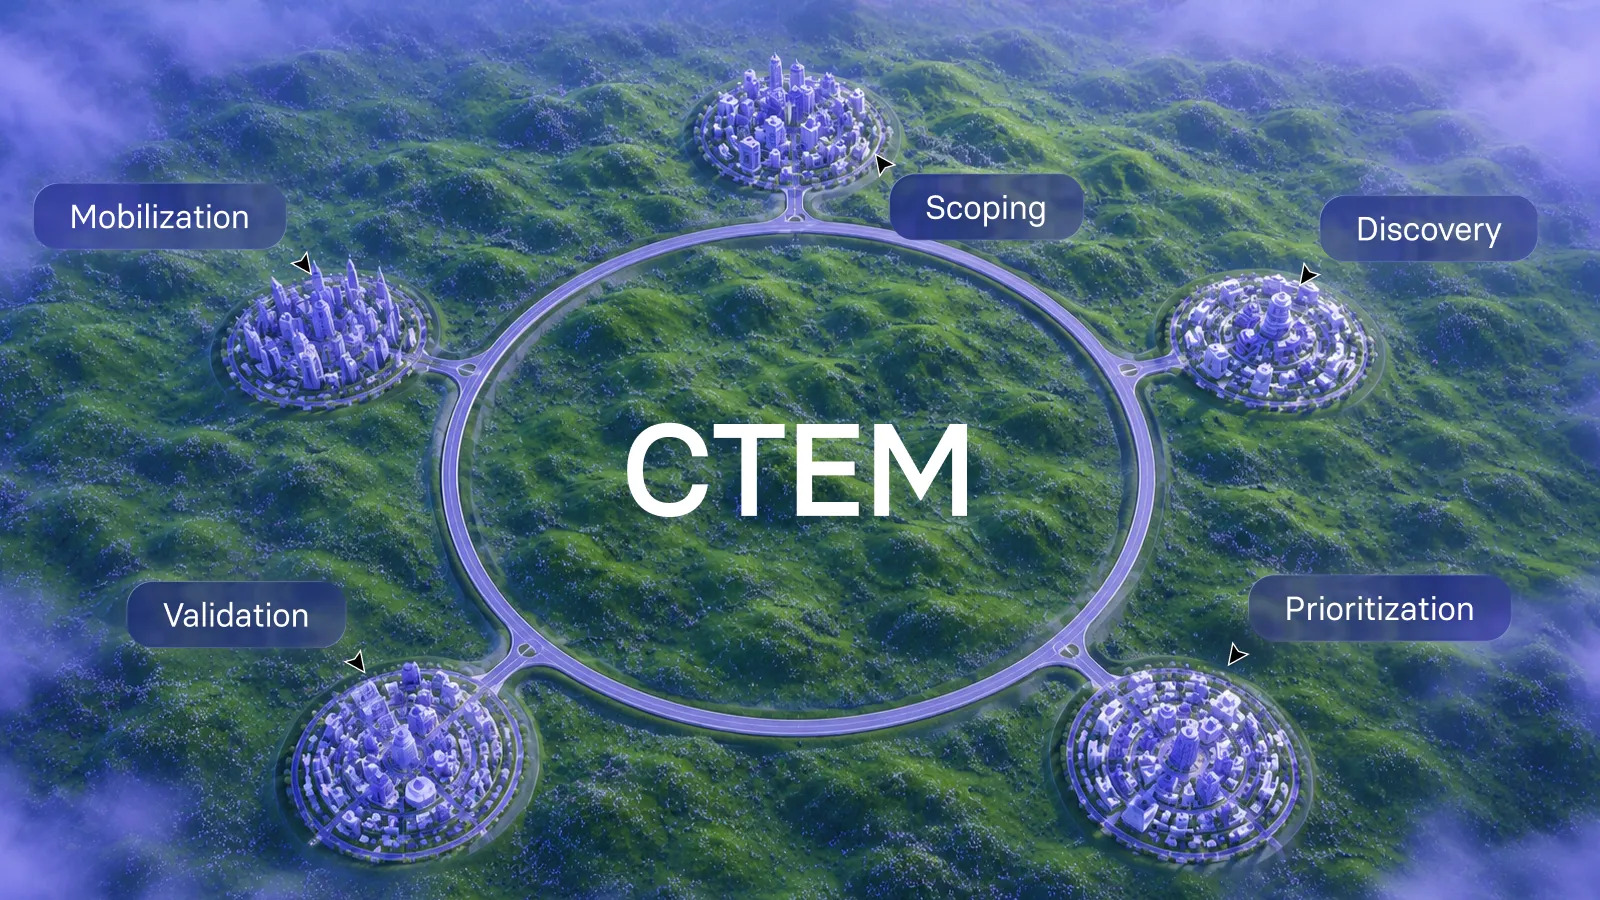
你的資安團隊執行掃描、標記漏洞並建立工單。六週後,同一批常見漏洞與暴露(Common Vulnerabilities and Exposures, CVE)仍躺在處理佇列中。是否似曾相識?持續威脅暴露管理(Continuous Threat Exposure Management, CTEM)導入提供了一條跳脫這種循環的路徑,透過範圍界定、探索、優先排序、驗證與推動處置五階段循環,將漏洞資料轉化為經確認的風險降低成果。

本指南將帶領企業資安與 IT 團隊建立可實際執行的持續威脅暴露管理(CTEM)計畫。你將學會如何界定攻擊面、將曝險對應至業務影響、驗證攻擊者能夠利用哪些弱點,以及推動補救工作,徹底關閉漏洞。


重點摘要:導入持續威脅暴露管理(CTEM)

  • 持續威脅暴露管理(CTEM)是一套五階段循環,透過範圍界定、探索、優先排序、驗證與推動處置,將漏洞發現轉化為可衡量的曝險降低成果。
  • 範圍界定會在探索開始前,先定義關鍵資產、攻擊面邊界,以及與業務風險連結的成功指標,避免範圍無限制擴張。
  • 優先排序結合通用漏洞評分系統(Common Vulnerability Scoring System, CVSS)嚴重程度、漏洞利用預測評分系統(Exploit Prediction Scoring System, EPSS)利用機率,以及美國網路安全暨基礎設施安全局已知遭利用漏洞清單(CISA Known Exploited Vulnerabilities, CISA KEV),依真實世界風險而非理論嚴重程度排列漏洞。
  • 驗證會確認漏洞是否能在你的環境中遭到利用,減少誤判,並提高工程團隊對補救需求的信心。
  • Vicarius vRx 透過自動化補丁、虛擬補丁(Patchless Protection)與腳本式補救,處理整個漏洞佇列,縮小補救缺口。

什麼是持續威脅暴露管理(CTEM),為何它在 2026 年如此重要?

CTEM 代表持續威脅暴露管理(Continuous Threat Exposure Management)。Gartner 提出這套架構,協助組織從週期性的漏洞掃描,轉向以降低資安曝險為目標的結構化營運模式。

傳統漏洞管理(Vulnerability Management)著重於找出弱點,持續威脅暴露管理(CTEM)則著重於將弱點補救完成。這套架構採用持續循環,而非單一時間點的評估,讓資安態勢能隨著環境變化持續維持最新狀態。

攻擊面的成長速度超過資安團隊的人力擴充速度。雲端工作負載每天持續建立,第三方整合不斷增加,舊版系統也經常在生命週期終止後持續於正式環境運作。以週期性評估為核心的計畫,無法跟上這樣的變化速度。


持續威脅暴露管理(CTEM)五階段解析

持續威脅暴露管理(CTEM)將暴露管理(Exposure Management)拆分為五個階段,形成反覆執行的循環。每個階段都會產生具體成果,並成為下一階段的輸入。若能妥善執行,這套循環會隨時間持續精進。

階段一:範圍界定(Scoping)

範圍界定會定義持續威脅暴露管理(CTEM)計畫要保護的對象,以及衡量成功的方式。若缺乏明確範圍,持續威脅暴露管理(CTEM)就會變成試圖管理所有事物的漏洞管理計畫,最後反而什麼都管不好。

首先找出關鍵業務服務,再將這些服務對應至支援它們的資產。定義攻擊面邊界並建立成功指標。良好的範圍應是一項業務風險假設,而不是一份組態管理資料庫(Configuration Management Database, CMDB)匯出清單。

第一次執行循環時,應選擇補救量能足以負荷的小範圍領域。先在中度風險領域完成一次試行,有助於建立可信度與實務經驗,讓後續循環能進一步處理風險更高的領域。

階段二:探索(Discovery)

探索要回答兩個問題:環境中有哪些資產,以及這些資產出了什麼問題?這個階段不只進行常見漏洞與暴露(CVE)掃描,也涵蓋錯誤組態、身分安全弱點、軟體即服務(Software as a Service, SaaS)安全態勢缺口,以及第三方整合風險。

針對已界定的範圍建立資產清冊(Asset Inventory),記錄資產識別資訊、負責人、業務關鍵性與曝險態勢。探索工具不可或缺,但分類發現項目、連結業務情境並指派負責人,仍需要投入大量人力。

涵蓋範圍缺口本身也是一項發現。若掃描工具未涵蓋範圍內十二項服務中的三項,這個缺口就代表尚未受到監控的曝險。

階段三:優先排序(Prioritization)

面對多數組織所發現的大量曝險,優先排序將決定團隊能否持續推進,或被工單淹沒。這個階段會依據可利用性、業務影響與既有資安控制措施排列風險。

通用漏洞評分系統(CVSS)本身只是嚴重程度分數,不等同於風險評估。只存在於內部非正式環境、CVSS 為 9.8 的漏洞,實際急迫性確實可能低於位於網際網路對外身分驗證服務、CVSS 為 7.0 的漏洞。應將 CVSS 與漏洞利用預測評分系統(EPSS)利用機率及 CISA 已知遭利用漏洞(KEV)資料結合,建立能反映真實世界風險的排序模型。

風險導向優先排序(Risk-Based Prioritization)除了威脅情資(Threat Intelligence),也會納入資產關鍵性與業務情境。最終成果是一份具備充分依據的優先順序清單,並搭配工程團隊能夠履行的服務等級協議(Service-Level Agreement, SLA)。

階段四:驗證(Validation)

驗證會將「理論上存在風險」轉化為「實際可遭利用」。這個階段會測試攻擊能否在你的環境中成功執行、控制措施是否如預期阻擋或偵測攻擊,以及補救措施是否已降低或移除曝險。

驗證並不是滲透測試(Penetration Test)。你已經掌握特定曝險,也對其可利用性提出明確假設,接著再對該假設進行測試。目標是速度與精準度,而不是沒有明確邊界的開放式評估。

依原文敘述,可預期有 30% 至 40% 的第一優先級與第二優先級(P1/P2)曝險會在驗證後調降,原因可能是補償性控制措施(Compensating Controls)確實有效,或該利用方式不適用於現有組態。另有 10% 至 15% 的曝險可能在測試發現實際風險高於掃描工具判定時調升。

階段五:推動處置(Mobilization)

推動處置會將已驗證的發現項目轉化為實際執行的補救行動。發現項目會成為具備證據、負責人與服務等級協議(SLA)的工程層級工作項目。例外情況會納入治理,相關指標則呈現實際降低的曝險程度。

補救工單的品質會直接影響工程團隊是否採取行動。應以業務影響與驗證證據為主,而不是只提供發現項目數量。工單也應包含明確的補救方式,例如要升級的程式庫版本、需要套用的組態變更,或必須新增的規則。

每次完成補救後,都應重新執行先前用來證明漏洞可遭利用的相同測試。若補救有效,該利用測試就應失敗;若測試沒有失敗,就表示補救並未成功,必須退回重新處理。


如何啟動持續威脅暴露管理(CTEM)計畫:90 天路線圖

許多組織在導入持續威脅暴露管理(CTEM)時陷入停滯,原因是尚未透過專案證明方法有效,就急著將其全面轉化為正式計畫。第一次循環應視為具有時間限制的試行專案:範圍明確、交付成果具體,並在第 90 天設定清楚的決策點。

第 1 至 30 天:定義試行範圍

依據三項條件選擇試行領域。第一,哪些領域具備足夠的補救量能?應選擇負責補救的團隊具備時間與執行意願的領域。第二,哪些領域能取得曝險資料?應選擇不需要歷經數月整合專案,就能盤點資產的領域。第三,哪些領域能展現與業務相關的風險降低成果?

撰寫範圍章程,納入威脅情境、有明確理由的排除項目,以及具體且可驗證的成功標準。只寫著「降低重大曝險」的章程缺乏可驗證的明確目標;若寫成「移除所有可從網際網路連線至管理介面的路徑」,就能為所有人提供清楚的執行目標。

第 31 至 60 天:探索並排列優先順序

針對已界定的範圍建立資產清冊,納入資產識別資訊、負責人、業務關鍵性與曝險態勢。設定明確界線:到了第六週結束時,就以目前掌握的資料繼續推進;缺少的部分則列為發現項目。

在資產清冊上疊加曝險資料。只針對範圍內資產,查詢漏洞掃描工具、雲端安全態勢管理(Cloud Security Posture Management, CSPM)工具、身分平台、網域名稱系統(Domain Name System, DNS)紀錄與程式碼儲存庫。接著套用優先排序模型,建立已排序的處理佇列。

第 61 至 90 天:驗證並推動處置

測試利用方式能否在環境中成功執行,以驗證第一優先級與第二優先級(P1/P2)曝險。記錄驗證結果,並提供工程團隊可據以採取行動的證據。

建立補救工單,明確說明需要執行的變更、未完成補救可能造成的業務影響,以及驗證補救是否有效的方法。追蹤進度、升級處理阻礙,並在關閉每一項完成的補救工作前重新驗證。


持續威脅暴露管理(CTEM)與傳統漏洞管理有何不同?

漏洞管理(Vulnerability Management)聚焦於以常見漏洞與暴露(CVE)編號識別的軟體弱點。持續威脅暴露管理(CTEM)則涵蓋任何可能讓資料、身分或基礎架構面臨風險的曝險,包括憑證外洩、仿冒網域、錯誤組態與受感染裝置等。

掃描工具產生發現項目,持續威脅暴露管理(CTEM)則透過結構化工作流程,產出已完成補救的曝險。兩者的差異在於探索之後發生了什麼:優先排序納入業務情境、驗證證明實際可利用性,並透過推動處置完成補救。

如果掃描工具產生的報告只是停留在處理佇列中,再增加一套掃描工具也無法解決問題。你需要的是一套能將發現問題推進至完成補救的系統。


克服常見的持續威脅暴露管理(CTEM)導入挑戰

組織在導入持續威脅暴露管理(CTEM)時,通常會遇到可預期的障礙。事先理解這些問題,有助於提前規劃應對方式。

挑戰:補救工作卡在跨團隊協作

資安團隊識別風險,IT 團隊負責補救。雙方的優先順序與急迫性定義不同,導致關鍵漏洞持續卡在處理佇列中。這也是台灣企業既有 WSUS/SCCM 維運與變更窗口中常見的情境,資安與 IT 團隊往往都在等待適當的維護時段。

解決方式是在曝險獲得確認的當下立即進行控制。虛擬補丁(Patchless Protection)能在記憶體層阻擋漏洞利用路徑,不需要立即安裝正式補丁或重新啟動,讓 IT 團隊有時間安排正式補救,同時避免組織持續處於曝險狀態。

挑戰:發現項目數量過於龐大

探索階段會產生數千項發現。若缺乏以實際風險為基礎的優先排序,團隊將不斷進行分類,補救速度卻持續緩慢。

在發現項目進入處理佇列前先降低雜訊。將通用漏洞評分系統(CVSS)、漏洞利用預測評分系統(EPSS)與已知遭利用漏洞(KEV)資料結合資產情境,排除僅存在理論風險的項目。驗證則能再增加一層確認,判斷剩餘漏洞中有哪些確實能在特定環境內遭到利用。

挑戰:無法確認曝險是否已經消失

補丁已完成部署,工單也已關閉,但沒有人確認漏洞是否真的消失。錯誤組態、遺漏的資產或部署失敗,都可能使曝險持續存在。

將重新驗證納入工作流程。每一項已完成補救的漏洞都應重新測試,以確認補救確實有效。Vicarius vRx 會在資產層級確認補救成果,驗證每項漏洞已無法再遭利用。


證明持續威脅暴露管理(CTEM)計畫價值的指標

追蹤能夠證明成果的指標,而不是只衡量活動數量。已完成多少次掃描或建立多少張工單,無法告訴管理層風險是否正在下降。

重要指標

第一優先級(P1)曝險完成補救的比例,可顯示工作流程是否真正關閉關鍵缺口。從發現 P1 曝險到完成補救的天數中位數,可顯示作業流程是否具備足夠速度。驗證後遭到調降的曝險數量,則可證明驗證工作確實節省了補救資源。

範圍內資產已指派負責人的比例,可顯示組織是否具備推動處置的能力。每次循環中的曝險數量趨勢,則能顯示整體風險是否正在下降,而不只是發現更多問題。

應避免的指標

發現項目總數衡量的是數量,而不是價值。數量龐大可能代表範圍界定不佳,或工具產生過多雜訊。掃描次數衡量的是活動,而不是成果。建立的工單數量代表產生了多少工作,並不代表完成了多少工作。


Vicarius 如何支援持續威脅暴露管理(CTEM)導入

Vicarius vRx 透過單一平台涵蓋從探索到補救的流程,與持續威脅暴露管理(CTEM)架構相互對應。資產探索能找出應用程式、作業系統與第三方軟體中的漏洞。

風險導向優先排序(Risk-Based Prioritization)會將通用漏洞評分系統(CVSS)、漏洞利用預測評分系統(EPSS)與已知遭利用漏洞(KEV)訊號,結合資產關鍵性及業務情境排列漏洞。漏洞管理(Vulnerability Management)能力不只涵蓋掃描,也包含自動化補丁管理(Patch Management)、用於自訂補救的腳本引擎(Scripting Engine),以及保護零時差漏洞(Zero-Day)與舊版系統的虛擬補丁(Patchless Protection)。

閉環驗證(Closed-Loop Verification)會確認每一項補救成果,驗證漏洞確實已經消失,而不是假設問題已解決。依原文敘述,這種方法能將平均補救時間(Mean Time to Remediate, MTTR)縮短 60% 至 70%,並減少維持攻擊面持續縮減所需的人工投入。

了解 vRx 如何融入你的持續威脅暴露管理(CTEM)技術架構——申請產品展示。


建立支援持續威脅暴露管理(CTEM)的技術架構

持續威脅暴露管理(CTEM)是一套營運模式,而不是單一產品。然而,合適的工具能加速循環中的每個階段。

探索工具

需安裝代理程式的掃描工具(Agent-Based Scanner),以及透過網路進行遠端檢測的掃描工具(Agentless Scanner),可分別涵蓋不同類型的資產。以軟體物料清單(Software Bill of Materials, SBOM)為基礎的偵測,能找出特徵碼掃描工具遺漏的相依元件漏洞。外部攻擊面管理(External Attack Surface Management, EASM)工具則能識別對外曝露的資產。

優先排序工具

威脅情資(Threat Intelligence)來源會以漏洞利用機率與武器化狀態豐富常見漏洞與暴露(CVE)資料。資產關鍵性評分則為每項資產指派業務價值。風險評分引擎會整合這些輸入資料,產生可採取行動的優先順序。

補救工具

自動化補丁部署(Patch Deployment)負責處理例行更新。腳本引擎(Scripting Engine)將組態變更與自訂補救工作自動化。記憶體層級防護則涵蓋尚無補丁,或無法立即部署補丁時產生的缺口。


下一步:從小範圍開始,證明模式有效,再逐步擴大

導入持續威脅暴露管理(CTEM)不需要歷經多年的轉型。先針對明確領域啟動 90 天試行計畫。定義需要保護的對象、探索現有曝險、依實際風險排列優先順序、驗證可利用性,並推動補救工作直到完成。

完成一次能降低第一優先級(P1)曝險的循環,就能建立擴大導入所需的可信度。後續每次循環都會讓流程更加緊密:範圍界定更精準、探索更準確、優先排序更具依據、驗證更有效率,推動處置也更加可預測。

目標不是只完成一次五階段流程,而是隨時間加快每次循環並提高精準度,以可衡量的方式降低真正影響組織的曝險。


持續威脅暴露管理(CTEM)導入常見問題

CTEM 代表什麼?這套架構由誰提出?

CTEM 代表持續威脅暴露管理(Continuous Threat Exposure Management)。Gartner 提出這套五階段架構,協助組織透過範圍界定、探索、優先排序、驗證與推動處置,有系統地降低資安曝險。與週期性評估不同,持續威脅暴露管理(CTEM)採用持續循環,並隨著環境變化進行調整。

導入持續威脅暴露管理(CTEM)計畫需要多長時間?

一次聚焦特定範圍的試行循環約需 90 天。第 1 至 30 天進行範圍界定;第 31 至 60 天進行探索與優先排序;第 61 至 90 天進行驗證與推動處置。隨著團隊建立流程成熟度並精進工具,後續循環的執行速度會逐步加快。

持續威脅暴露管理(CTEM)與漏洞管理有什麼不同?

漏洞管理(Vulnerability Management)著重於找出軟體弱點。持續威脅暴露管理(CTEM)則著重於補救各種類型的曝險,包括錯誤組態、身分安全弱點與憑證外洩。Vicarius vRx 將漏洞探索、自動化補救、虛擬補丁(Patchless Protection)與閉環驗證(Closed-Loop Verification)整合,協助持續威脅暴露管理(CTEM)確認每一項補救成果。

持續威脅暴露管理(CTEM)的優先排序與通用漏洞評分系統(CVSS)有何不同?

通用漏洞評分系統(CVSS)衡量理論上的嚴重程度。持續威脅暴露管理(CTEM)的優先排序則會將 CVSS 與漏洞利用預測評分系統(EPSS)利用機率、CISA 已知遭利用漏洞(KEV)的實際利用資料、資產關鍵性及業務情境結合。這種方法會找出攻擊者正在鎖定、且存在於最關鍵資產上的漏洞,而不是只依一般嚴重程度排序。

什麼是驗證階段?為什麼它如此重要?

驗證會測試漏洞是否能在特定環境中遭到利用。它能確認補償性控制措施(Compensating Controls)是否如預期運作,以及補救是否已移除曝險。依原文敘述,Vicarius vRx 的驗證能力可減少 95% 的誤判,並讓工程團隊確信補救需求反映的是真實風險。

持續威脅暴露管理(CTEM)能與既有資安工具搭配使用嗎?

可以。持續威脅暴露管理(CTEM)是一套可與現有掃描工具、安全資訊與事件管理(Security Information and Event Management, SIEM)及端點偵測與回應(Endpoint Detection and Response, EDR)工具搭配使用的營運模式。Vicarius vRx 等平台能接收既有工具的訊號,將發現項目標準化並整合至單一處理佇列,再加入補救層,關閉從發現漏洞到完成補救之間的缺口。


立即聯絡我們  

資訊悅報 Vol.62|Bitdefender: AI 攻擊速度愈來愈快,IT 團隊如何在告警出現前減少可被利用的攻擊機會?

部落格來源網址:The New AI Arms Race Starts Before the Attack


新一波 AI 軍備競賽,在攻擊發生前就已開始

人工智慧正在形成一個企業必須保護的新 Attack Surface(攻擊面)。而多股力量彼此碰撞,也讓這個攻擊面變得更加複雜:

外部 AI 威脅(External AI Threats): 攻擊者正在利用 AI 提高攻擊速度、攻擊量,以及攻擊內容的個人化程度。

內部 AI 風險(Internal AI Risk): AI 的採用正在帶來新的曝險、連線關係與資料外洩風險,而這些變化的速度,已快到許多資安團隊難以及時治理相關風險。

如果企業面對這兩項發展,只是在可疑活動開始後產生更多 Alert,防禦方將陷入一場無法長期勝出的競賽。因此,新一波 AI 軍備競賽其實早在攻擊發生之前就已開始,企業需要具備 AI Visibility、Control,以及運用 AI 縮減 Attack Surface 的能力。


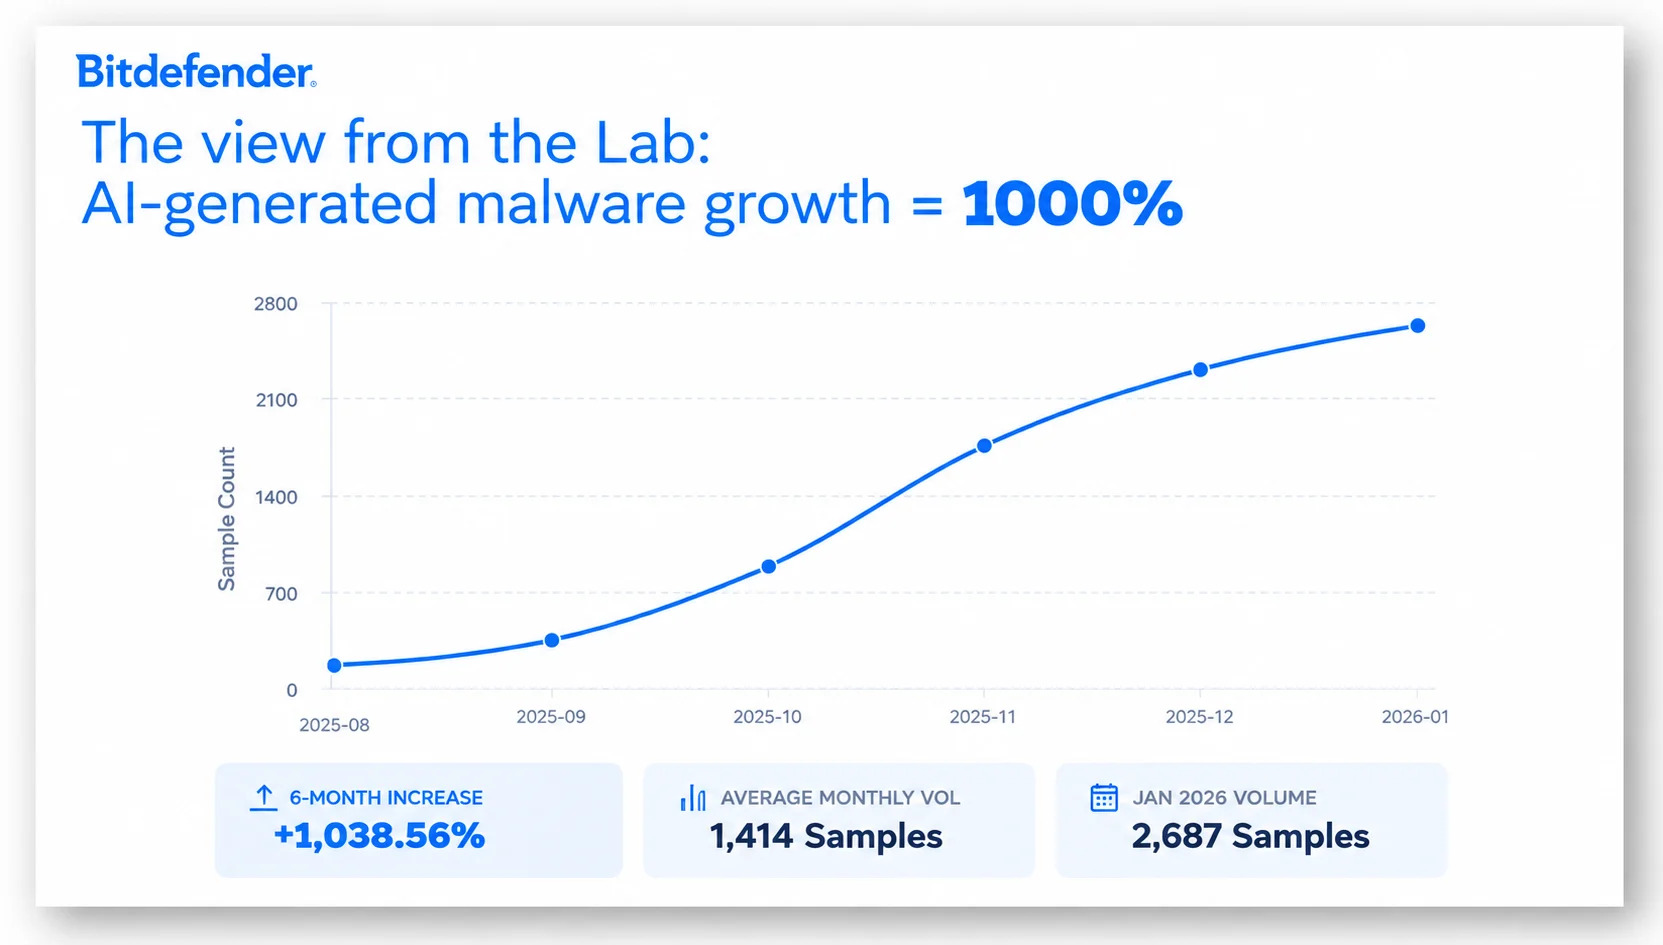
AI 生成惡意程式成長得有多快?

談到 AI 生成惡意程式,其成長趨勢正持續快速上升。

從 2025 年 8 月到 2026 年 1 月,Bitdefender Labs 追蹤到 AI 生成惡意程式樣本增加超過 1,000%。這是一個早期警訊,顯示攻擊者正在快速測試如何利用 AI 建立、修改並大規模擴展惡意程式碼。

資安團隊目前正在遇到哪些 AI 輔助網路攻擊?

根據 Bitdefender《2026 Cybersecurity Assessment》針對 1,200 名 IT 與資安專業人員進行的調查,59% 表示其組織曾遭遇他們認為涉及 AI 的 Social Engineering 攻擊,另有 56% 表示曾遭遇 AI 生成惡意程式所發動的攻擊。

更值得注意的是,70% 的受訪者表示,他們正看到由 AI 工具協助、且複雜程度持續提高的 Phishing 攻擊。

因此,53% 的受訪者認為,AI 對攻擊者帶來的幫助比對防禦方更多。


AI 輔助攻擊帶來的一項重大挑戰是什麼?

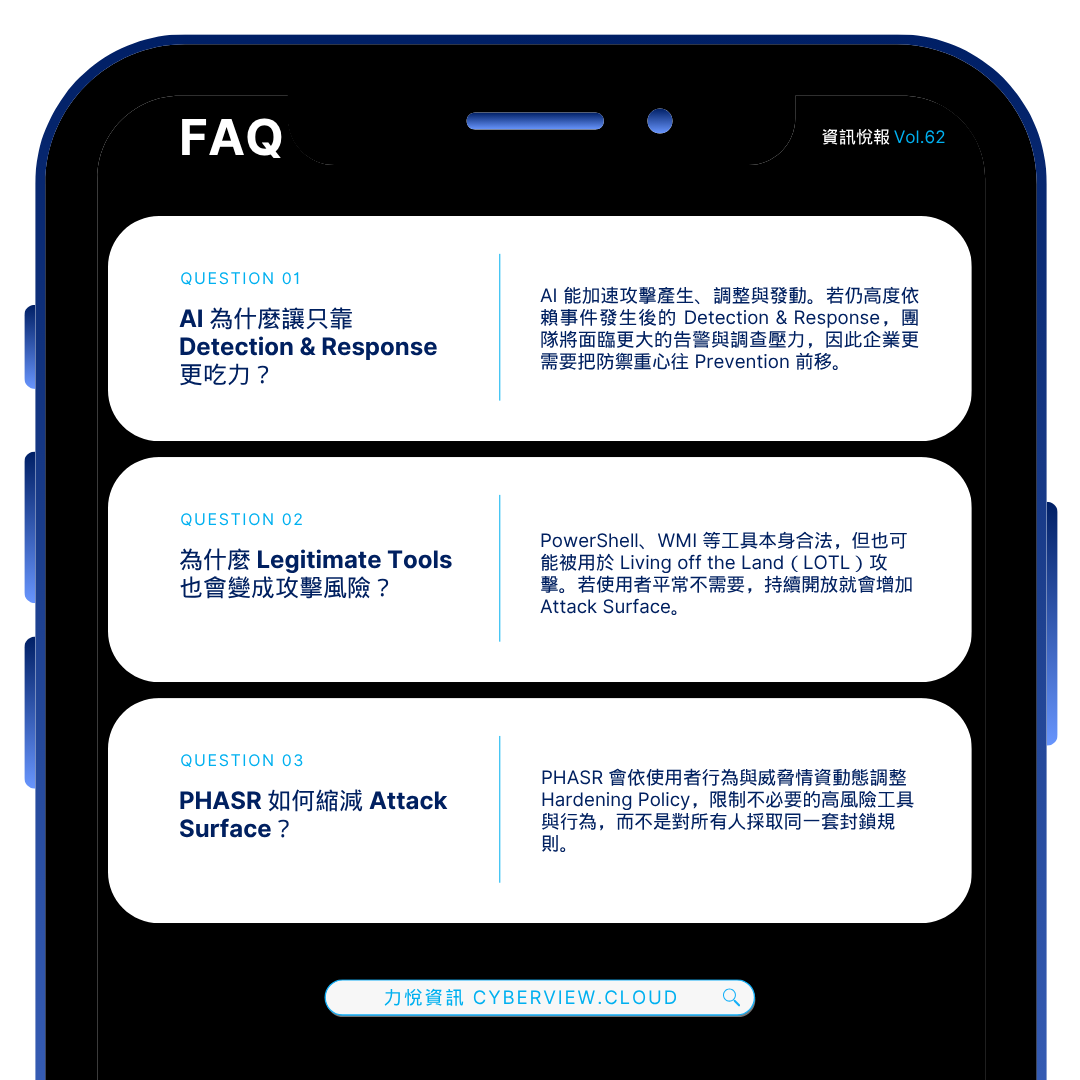
核心問題不只是防禦方能否偵測這些攻擊,更在於當攻擊能以機器速度產生、調整並發動時,企業是否還能繼續如此高度依賴 Detection & Response。


AI 如何從企業內部擴大 Attack Surface?

AI 工具的採用速度已經超前治理速度。資安團隊如今必須對一個可能連看都看不清楚、更難以持續一致控管的 Attack Surface 負責。

員工正在使用各式各樣的公開 AI 服務。許多原本已獲核准的工具,如今也開始加入 AI 功能。開發人員則透過 API,將模型與企業系統及資料連接起來。此外,也不能忽略一般使用者可能正在與 AI 分享的各種敏感資訊。

數據顯示,IT 與資安團隊正在面臨這項挑戰:Cybersecurity Assessment 發現,44.8% 的 IT 與資安專業人員對組織內部的 AI 使用情況只有部分可視性。而談到 2026 年的優先事項,根據這項研究,排名第一的是「建立全面性的內部 AI Governance」。


為什麼企業正在轉向 Prevention?

新一波 AI 軍備競賽需要重新平衡資安工作的優先順序,並將重心轉向 Prevention。Prevention-first 策略不再只問:「我們可以多快偵測到這次攻擊?」而是進一步問:「在 Threat Actor 採取行動之前,我們可以先移除多少攻擊機會?」

Detection & Response 仍然提供至關重要的安全網。Prevention 則能降低這張安全網真正必須接住威脅的頻率,同時降低攻擊造成實質損害的可能性。


內部 AI Visibility 是起點

從內部 AI 風險來看,Prevention 必須從 Visibility 開始。企業無法縮減一個自己根本看不見的 Attack Surface。

資安與 IT 團隊需要了解目前正在使用哪些 AI 服務、這些服務可以接觸哪些資料與系統,以及哪些使用行為帶來最高風險。如此一來,團隊就能依風險排定 Governance 優先順序,而不是採取員工可能設法繞過的全面性限制。

這也能讓企業運用目前可能已經具備的 Control。

Web Access Policy 可以處理高風險服務。Hardening Policy 可以減少容易遭利用的組態與不必要功能。Web Filtering 則可以限制對公開雲端模型及 Shadow AI 的存取。

目標不應該是阻止 AI 的採用,而是讓 AI 的採用變得可視、有明確規劃,而且更加安全,同時避免再建立另一套彼此孤立的資安計畫,增加更多工具、Console 與維運複雜度。


防禦方如何運用 AI 強化 Cyber Defense?

企業必須將 AI 納入現代化 Security Operations Center(SOC),或選擇在 SOC 中運用 AI 的 MDR 服務供應商。AI 能協助團隊分析 Signal、加速 Investigation、自動化重複性工作並更快速回應事件。隨著威脅速度持續加快、數量持續增加,這些能力也會變得愈來愈重要。

然而,AI 軍備競賽不會只靠建立更快速的 Detection 就能勝出。企業也必須運用 AI 驅動的工具來縮減 Attack Surface,並為每位使用者建立專屬的安全設定。

防禦方必須在 Incident 發生之前就運用 Intelligence:找出 Exposure、降低 Privilege、強化環境、治理 AI 使用方式,並持續移除潛在的 Attack Path。如此一來,企業才能改變攻防局勢,不再只是競相圍堵每一次 AI 輔助攻擊,而是從一開始就剝奪更多攻擊成功的機會。

延伸解法|PHASR 如何因應 AI 加速攻擊?

當 AI 讓攻擊產生、調整與發動得更快,企業不能只依賴事後的 Detection & Response。Bitdefender GravityZone PHASR 會依使用者行為動態調整 Hardening,限制不必要的高風險工具與 Attack Path,在攻擊發生前縮減 Attack Surface。

最新 GravityZone 6.77 更支援 PHASR for AI Agents,可將 AI Agent 與端點使用者分開控管;即使 Agent 需要 PowerShell,也不必同步放大人員權限。Autopilot 也新增人工覆寫機制,讓管理員可在必要時暫時調整限制,同時保留 PHASR 的自動化強化能力。

PHASR 關鍵亮點

  • 事前縮減 Attack Surface
  • AI Agent 與人員權限分流
  • 動態 Hardening,降低 LOTL 攻擊機會


立即聯絡我們  

資訊悅報 Vol.61|Idira:保護 AI Agent:強化 MCP 資料存取的控制與可視性

部落格來源:https://www.paloaltonetworks.com/blog/identity-security/secure-ai-agents-controls-visibility-mcp-data-access/


創新能發揮多少價值,取決於你擁有多少可視性。當組織快速導入 AI Agent,以自動化工作流程並提升生產力時,資安團隊卻往往被迫以機器般的速度前進,手上卻沒有完整的飛行計畫。AI Agent 具有非確定性的特性,代表 Agent 可能以難以預期的方式與組織系統及資料互動,也因此帶來新的安全風險。

AI Agent 是一種新的特權身分類型,它同時具有人類身分與機器身分的特性,可以自主採取行動,也能代表使用者存取企業敏感系統。保護這類身分,不能只依靠基本的伺服器端設定,而需要 Agentic AI 治理、身分代理,以及能跟上發展速度的 AI 最小權限存取控制。

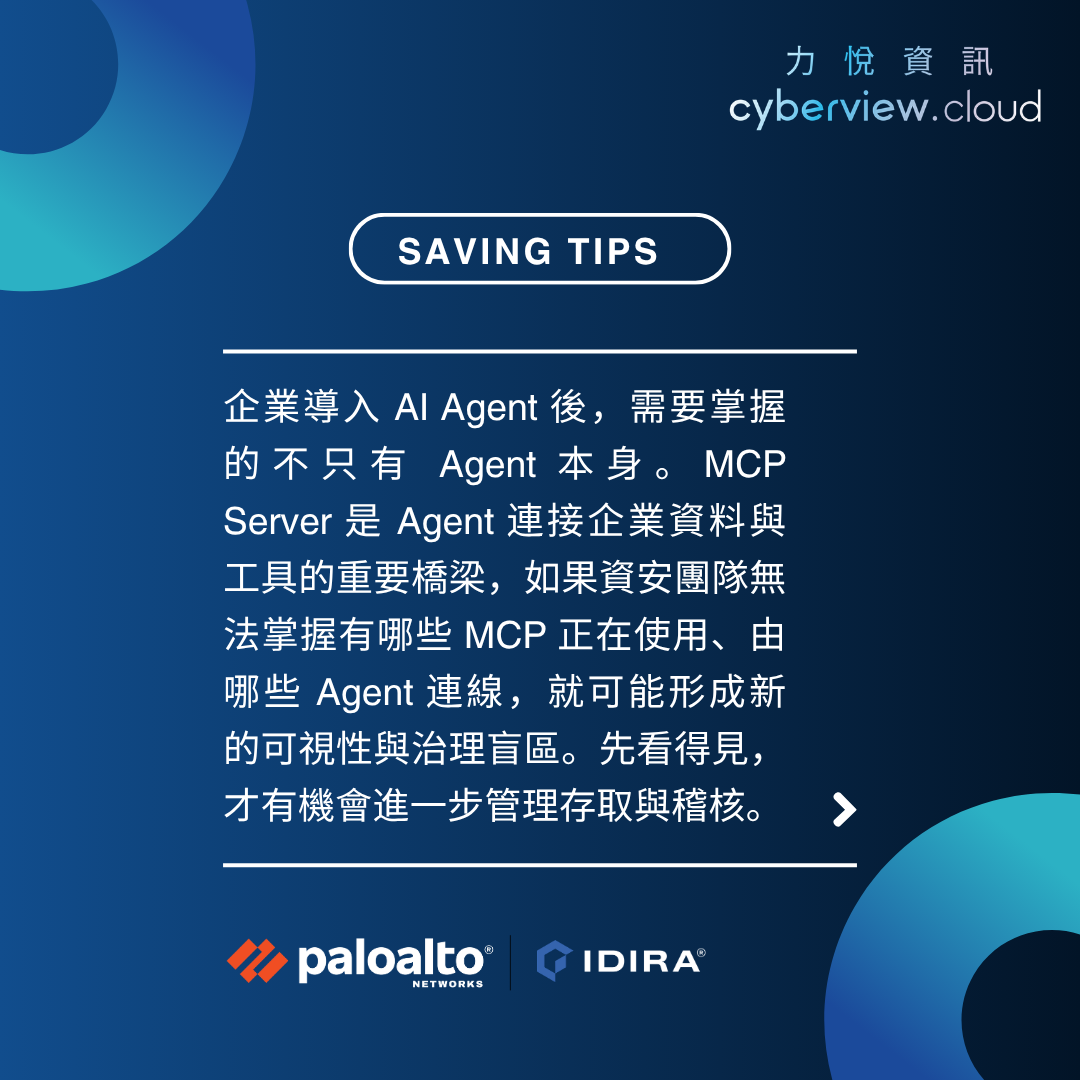
當 AI Agent 執行任務時,往往會仰賴 Model Context Protocol,以下簡稱 MCP,Server 作為連接企業資料來源與系統的重要橋梁。然而,MCP 缺乏一致的身分驗證與安全控制,而且資安團隊甚至可能根本看不到它們。開發人員可以,也確實會從公開 Registry 下載開源或其他 MCP Server,讓自己的 Agent 存取資料來源。這些未受保護的 MCP,可能因此成為攻擊者鎖定的重要目標。

如果缺乏集中式可視性與受治理的存取控制,CISO 與資安團隊就無法清楚掌握 AI Agent 實際正在存取哪些目標資源,例如資料庫、雲端環境與 SaaS 應用程式。

以下將介紹 Idira™ Secure AI Agents 解決方案擴充後的功能,如何讓這些重要的橋梁不再隱藏於視線之外,協助資安團隊因應內部與外部資料存取控制的挑戰,並強化 MCP Server 的安全。


為什麼 MCP 的基本安全控制還不夠?

許多組織目前仍只依賴 MCP Server 原生內建的安全設定。這些原生控制可以探索 MCP Server 或監控 Agent 活動,但未必能提供企業所需要的可視性、身分脈絡或存取治理能力。原因如下:

  • 缺乏原生身分驗證: 實際環境中有大量 MCP Server,例如內部開發工具或社群原型,本身完全沒有內建身分驗證。例如,Bloomberry 的研究發現,38% 的 MCP Server 沒有任何身分驗證機制。
  • 身分盲區: 即使 MCP Server 使用原生 OAuth 2.1,也就是許多應用程式用來授予有限資料與系統存取權的標準授權框架,它仍可能只驗證人類使用者所委派的同意。AI Agent 本身對身分與存取管理系統,也就是 IAM,仍然不可見,因此資安團隊更難治理 Agent,也更難將實際操作快速追溯到特定 Agent。
  • 長效 Token: 原生 OAuth 2.1 的設定可能讓長效 Access Token 與 Refresh Token 持續保存在 AI Agent 端。如果 Agent 發生記憶體遭入侵或 Prompt Injection,這些常駐 Token 就可能被竊取並遭到濫用。
  • 政策碎片化: 採用原生身分驗證時,每一台 MCP Server 都可能自行決定安全 Scope、Token 存續時間與 Audit Log。如果一家企業使用 10 台不同的 MCP Server,資安團隊就被迫管理 10 套彼此完全分離的政策與合規介面。

未受管理的 MCP Server 也可能形成新的風險路徑。它們可能讓 Agent 更容易受到 Prompt Injection 影響,也就是惡意程式碼被注入 Prompt,進而劫持 Agent。此外,也可能涉及 供應鏈攻擊 與憑證竊取,例如下載的 MCP 含有惡意程式碼,用來竊取憑證,或之後透過「rug-pull」式更新重新引入風險。另一項需要關注的風險是 權限提升,權限範圍過大的 Token 可能讓攻擊者直接轉向資料庫與程式碼儲存庫。

在更嚴重的情況下,未受管理的 MCP Server 也可能暴露於 遠端程式碼執行,RCE 的風險,被滲透的 MCP Server 可能成為對本機發動 RCE 攻擊的入口,也可能讓遭入侵的 Agent 擷取敏感資料。

簡單來說,差異就在於控制。例如,原生 MCP 安全機制往往會讓可視性、身分驗證與存取決策分散在個別 Server 上;Secure AI Agents 則透過以身分為核心的平台方法,協助集中這些控制。

如果無法清楚掌握哪個 AI Agent 代表哪位使用者、具有哪些權限,以及對哪些資源採取了哪些行動,資安團隊可能很難安全限制 Agent 的存取,也難以控制 Agent 能透過 MCP Server 執行哪些特定工具。


如何透過身分導向方法保護 MCP Server

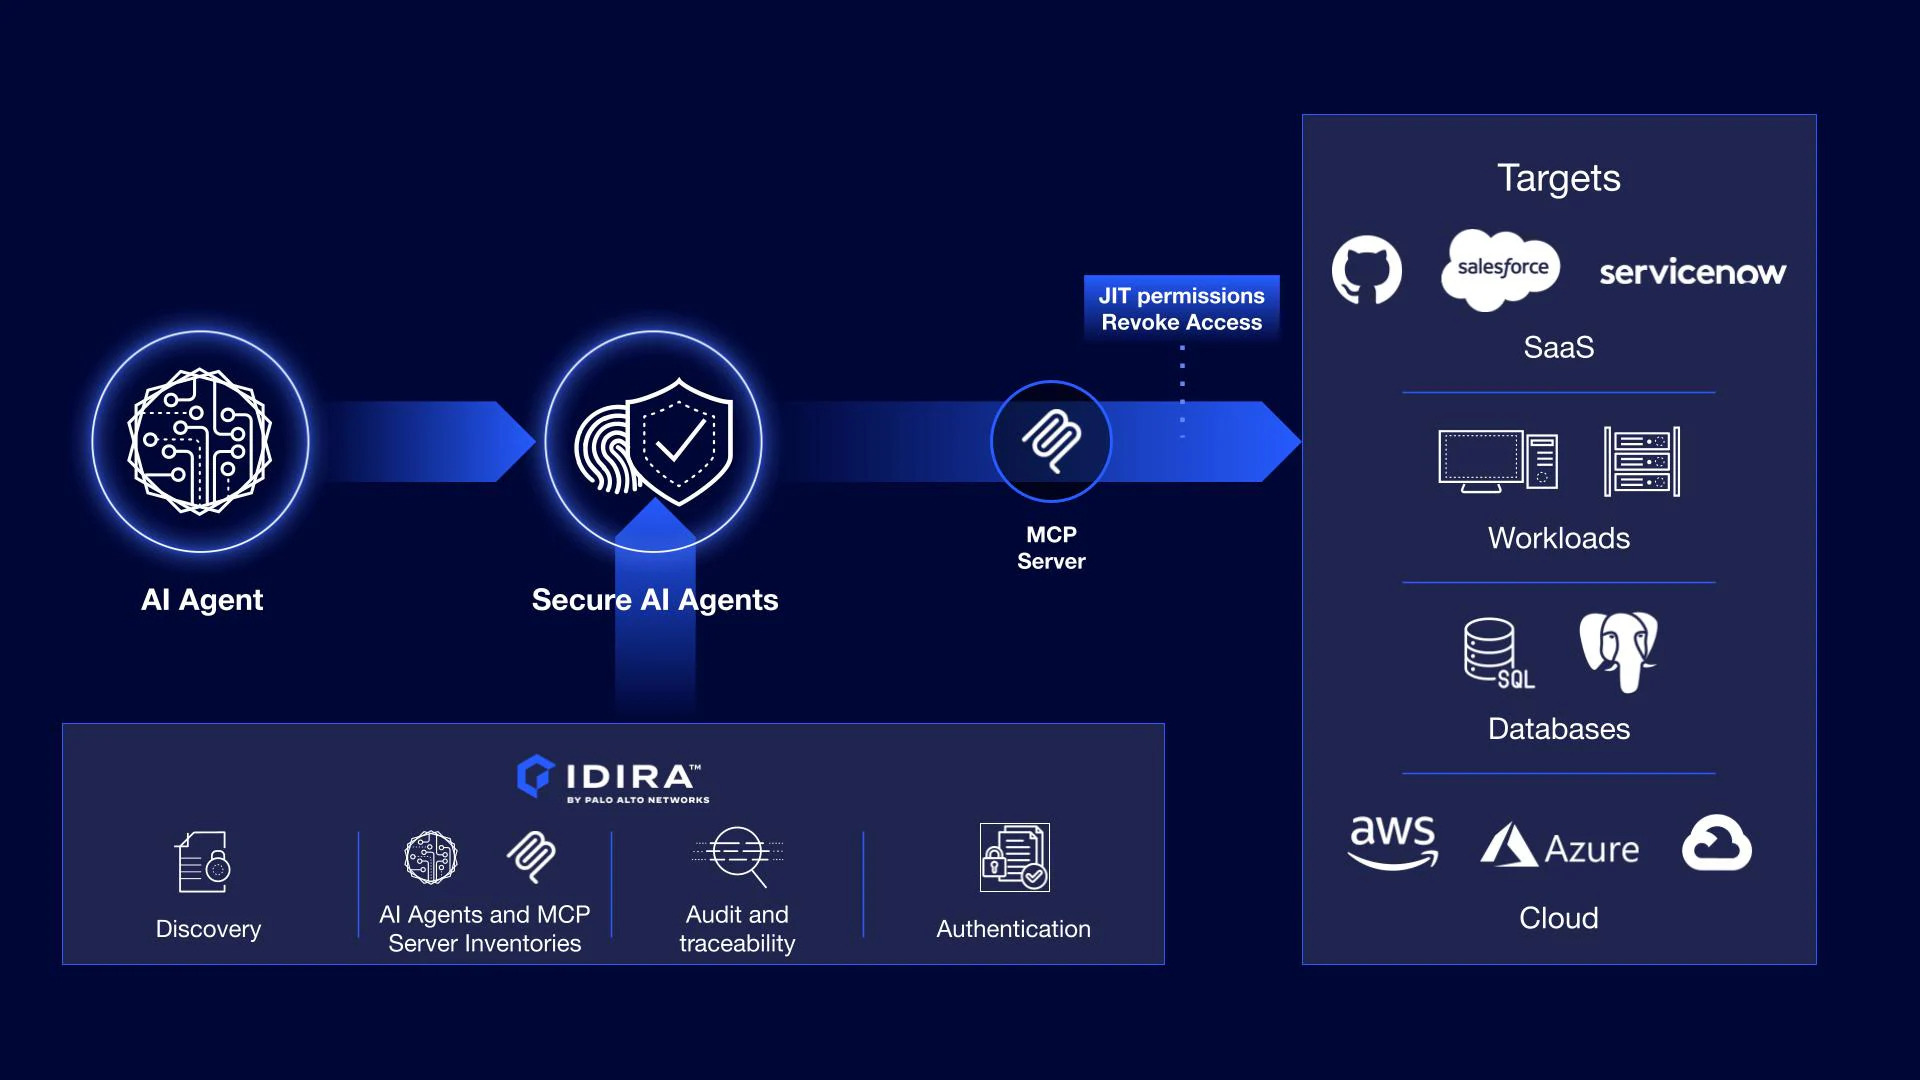
MCP Server 是 AI 模型與 Agent 存取外部資料來源及工具時的重要橋梁。在這類情境中,Secure AI Agents 位於 AI Agent 與遠端 MCP Server 之間。

現在,Secure AI Agents 解決方案可以擔任 MCP 的授權伺服器。Agent 不需要直接持有存取 MCP 所需的憑證,Agent 的通訊會先經過 Secure AI Agents,由平台扮演 Agent Identity Broker,再安全地將請求代理至目標 MCP Server。

這改變了控制點。資安團隊可以從逐台 Server 管理分散的 MCP 存取,轉變為將集中式身分安全控制套用到 Agent 活動上。

例如,當 Agent 完成註冊,並代表使用者透過 OAuth 2.1 向 Identity Broker 驗證身分後,Secure AI Agents 可以協助集中授權,而不是讓存取決策持續分散在個別 MCP Server 上。

將 MCP 活動導向 Identity Broker,可以協助組織在非確定性的 AI 環境中套用確定性的控制,讓敏感資料的存取維持在受治理且可稽核的狀態。


全新擴充功能進一步強化 MCP 安全

Secure AI Agents 可協助資安團隊為 Agentic AI 建立秩序,從單一解決方案探索 Agent、治理 MCP 存取、監控活動,並執行身分安全控制。以下說明它如何提供團隊安全創新所需要的防護機制。

1. 透過集中式清冊與探索,看見更多資訊

要管理 AI 快速擴張,包括 Shadow AI Agent,以及隱藏與未受管理的 MCP Server,第一步就是先知道環境中存在什麼。Secure AI Agents 提供企業內 AI Agent 的統一視圖,不論這些 Agent 是建置在 AWS、Azure、Copilot 或 Claude 上。

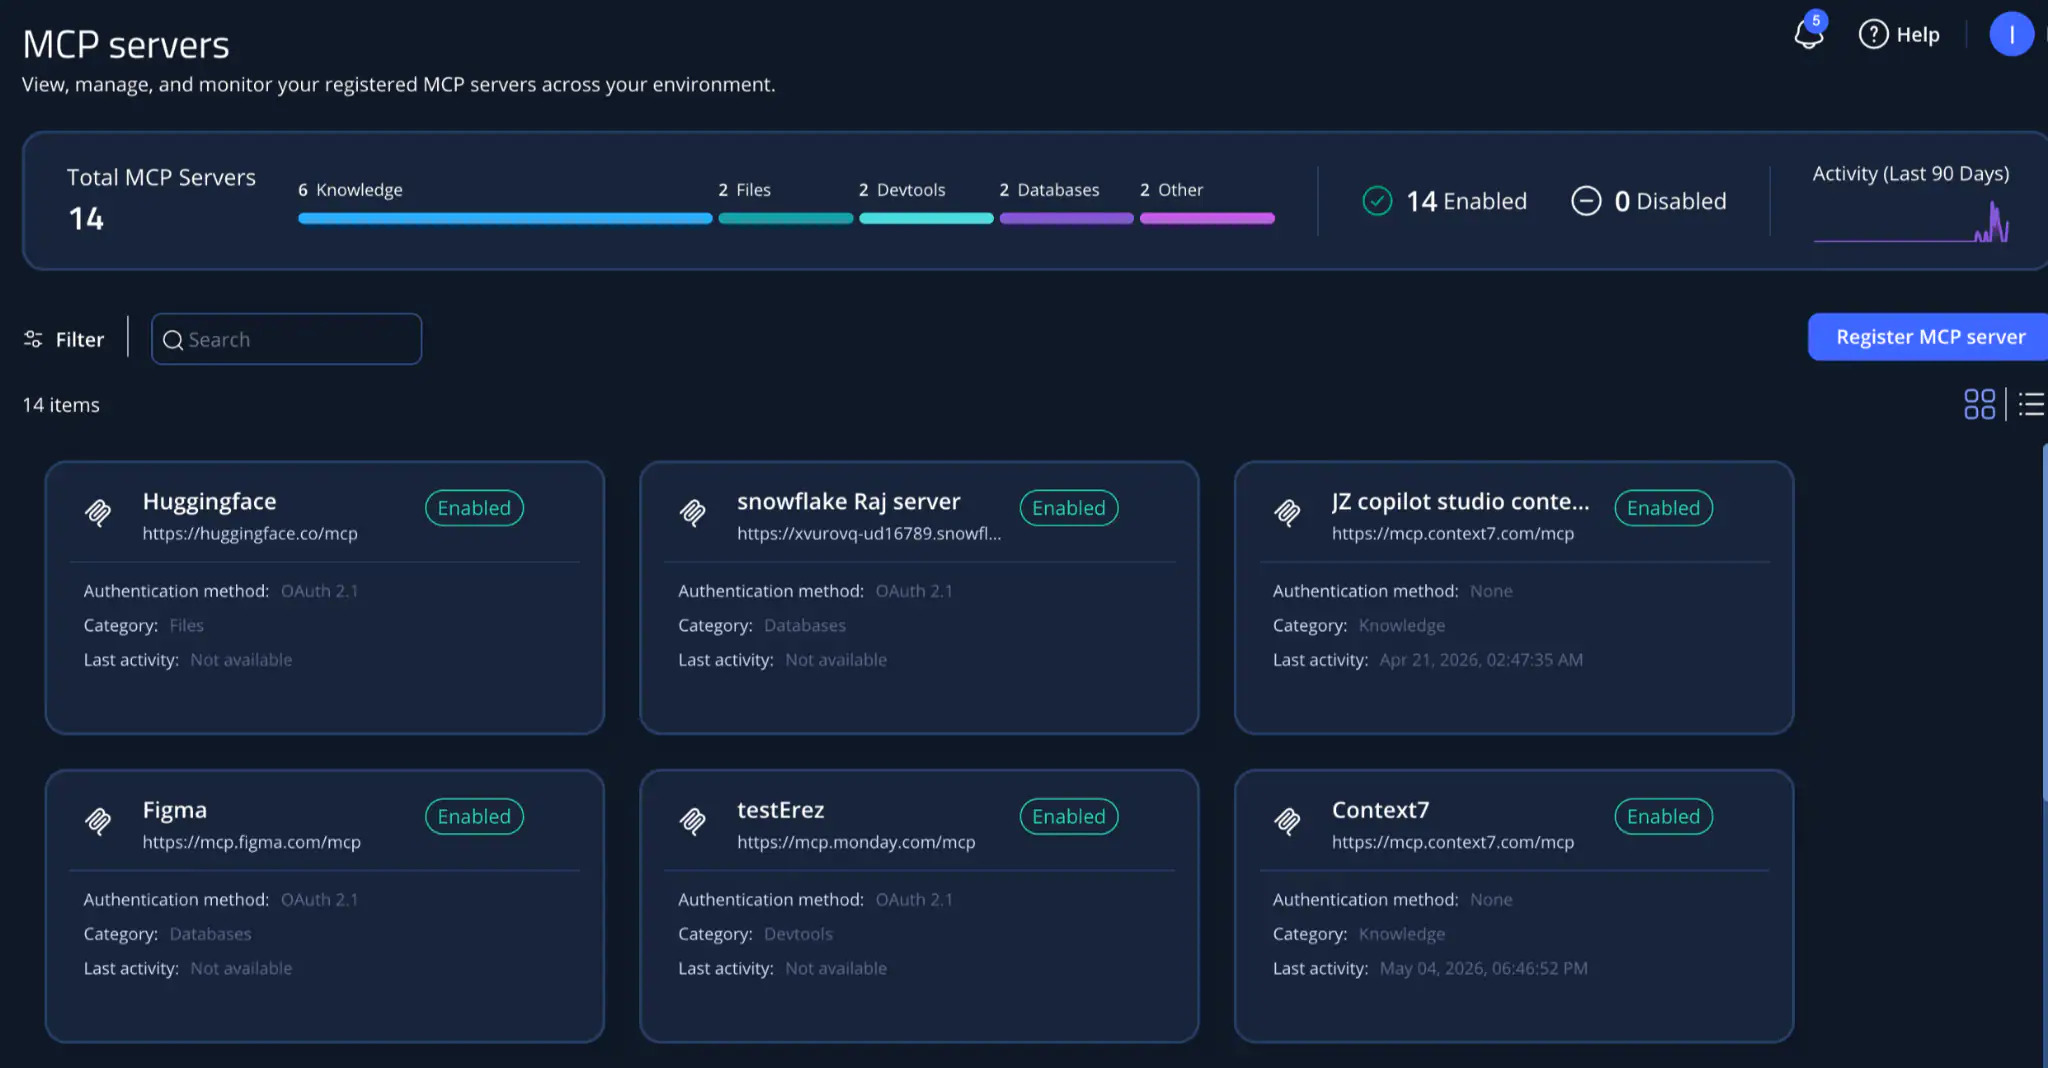
組織現在可以建立遠端 MCP Server 清冊,查看目前正在使用哪些 MCP Server、它們最後一次通訊的時間,並辨識哪些 AI Agent 正等待連線,或尚未設定負責人。

這種可視性也能協助資安團隊成為創新的推動者,建立一份經核准的 MCP Server 清單,讓開發人員知道哪些 MCP 可以安全地提供給 Agent 存取。

MCP Server 儀表板可用來查看、管理並監控整體環境中已註冊的 MCP Server。

2. 透過深度稽核與工作階段監控追蹤 AI Agent

當所有流量都透過 Secure AI Agents 傳遞後,資安團隊可以取得更強的 Agent 活動追溯能力。系統的設計會為每一次互動產生詳盡的稽核軌跡,協助團隊了解 AI Agent 存取了哪一台 MCP Server,以及 AI Agent 實際呼叫了哪些工具或執行哪些動作。

當 Agent 出現非預期行為時,這可以提供資安團隊所需的可視性,協助團隊更快速地調查與回應。

3. 透過受治理的 MCP 存取來控制連線

Secure AI Agents 的核心設計理念之一,是讓開發人員,也就是 Builder,能持續發揮創新能力,同時不犧牲安全。

現在,Builder 可以,而且必須主動註冊新的遠端 MCP Server,才能與 Agent 整合。為了落實嚴格治理,完成 MCP Server 註冊後,系統會先將其設為「停用」狀態。接著必須由資安管理者進行審查,並明確將允許使用的 MCP 標記為「啟用」,AI Agent 才能與它建立連線。

這種做法建立了一套 Human-in-the-loop 的人工核准流程,協助資安團隊維持控制,同時也讓開發人員擁有一條清楚的導入路徑。

4. 透過不受雲端與 Agent 限制的設計,讓 Agent 在任何環境運作

此解決方案的設計具備高度彈性,可以因應持續演進的 AI 環境。無論資安團隊使用 Google、Microsoft 或自行開發的解決方案,Secure AI Agents 都支援不同類型的 AI Agent 連接任何遠端 MCP。隨著 Agentic AI 的採用範圍持續擴大,這能協助組織套用一致的身分安全控制。

Secure AI Agents 提供可視性,並協助建立存取控制。


安全地推進 Agentic AI

AI Agent 是一種快速崛起且功能強大的新型身分,可以代表使用者採取行動,也可以自主運作。

Secure AI Agents 可協助企業套用強化的身分安全控制,例如 JIT 即時權限與嚴格的最小權限原則,將原本可能形成的安全盲區,轉變為更容易管理且可稽核的環境。這讓企業可以更有信心地發揮 AI Agent 的能力,同時不失去對最敏感資料的控制。

這些功能目前已開放給 Secure AI Agents 解決方案的客戶與 Design Partner 使用。想實際看看如何運作?歡迎參加 Webinar:Extend Agentic Identity Security to any MCP Server。

希望進一步針對自身需求討論?與專家聯繫。


FAQ

Q1:MCP Server 主要有哪些安全風險?

主要風險包括缺乏原生身分驗證、身分盲區、長效 Token、政策碎片化,以及 Prompt Injection、憑證竊取與權限提升等威脅。如果缺乏集中式治理,資安團隊可能無法掌握哪些 Agent 正在存取哪些系統、具有哪些權限,或是代表哪些使用者執行操作。

Q2:Secure AI Agents 如何提升 MCP 安全性?

Secure AI Agents 的設計是作為 AI Agent 與 MCP Server 之間的控制點。例如,不讓 Agent 直接持有 MCP 憑證,而是由 Secure AI Agents 代理請求、集中授權、支援更強的稽核能力,並協助資安團隊執行存取政策。

Q3:Secure AI Agents 是否能支援不同的雲端與 Agent 環境?

可以。Secure AI Agents 的設計可支援不同類型的 AI Agent 與遠端 MCP Server,包括 AWS、Azure、Copilot、Claude,以及自行開發的解決方案。


立即聯絡我們  

資訊悅報 Vol.60|RE:FORM DEPLOY: 企業愈大,數位轉型反而愈容易失敗?IT 團隊如何降低跨部門部署風險

部落格來源:9 Most Fascinating Digital Transformation 


9 個最引人入勝、值得借鏡的數位轉型案例

數位轉型將在 2025 年持續成為最重要的商業趨勢之一,全球相關支出預計到 2027 年將接近 4 兆美元。[1] 令人意外的是,研究顯示,每三項數位轉型計畫中,只有一項成功。

究竟是什麼驅動成功的數位轉型?本文將深入探討橫跨零售、銀行、餐飲、物流與消費品等領域的 9 個引人入勝的數位轉型案例。這些令人耳目一新的數位轉型策略,或許能啟發您的企業借鏡其思考方式。現在就讓我們開始。

內容概述

  • 什麼是數位轉型
  • 2025 年數位轉型的四大核心領域
  • 6 個數位轉型策略成功案例
  • 3 個值得借鏡的數位轉型失敗案例
  • RE:FORM 如何為您的數位轉型帶來效益

什麼是數位轉型?

數位轉型(Digital Transformation,簡稱 DX)是企業思維模式的根本轉變,旨在將數位工具與解決方案整合至企業的各個層面。這種「數位優先」的方法不只是採用新的軟體,更要求企業全面重新想像流程、商業模式與客戶體驗。最終目標是運用數位技術,為客戶、員工與企業創造新的價值。


2025 年數位轉型的 4 大核心技術

數位轉型涵蓋一系列正在重塑企業營運方式的技術。根據 IBM 的說法,企業正「愈來愈仰賴資料分析與自動化,以提升獲利能力與客戶滿意度」。[2]

以下是引領下一波數位轉型浪潮的 4 大核心技術:

  1. 人工智慧/機器學習: 這些技術模擬人類智慧,使企業能夠進行即時、資料驅動的決策。應用範圍包括客服聊天機器人、個人化廣告,以及 DevOps 中的自動化。
  2. 混合運算: 將地端基礎架構與雲端解決方案結合,可提供彈性、擴充性與安全性。例如,它支援將工作負載移轉至雲端,同時將關鍵資料保留於地端以因應法遵稽核,並有助於實施災難復原策略。
  3. 資料分析: 透過運用進階資料分析能力,企業可以辨識並預測趨勢、提升營運效率,並推動成長策略。
  4. 物聯網(IoT): IoT 裝置負責蒐集並交換資料,進而自動執行預先定義的動作。例如,智慧感測器可以提升空間利用率,並控制購物中心等室內空間的濕度與溫度等環境因素。

6 個最佳數位轉型成功案例

近年來,無論是歷史悠久的傳統品牌還是市場新秀,都紛紛擁抱創新,以在競爭中保持領先。以下是 6 個出色的數位轉型成功案例,它們不僅讓企業重獲新生,更將企業推向數位時代的新高度。


1. 銀行業數位轉型案例:星展銀行(DBS Bank)

星展銀行的數位轉型成果在金融產業獲得了高度肯定。在過去十年間,他們獲得了多項殊榮,包括「全球最佳銀行」與「全球最佳數位銀行」。

以下是星展銀行幾項值得關注的數位轉型應用:

  • 推出 digibank 行動應用程式等數位平台,為客戶提供流暢的線上銀行服務。此項措施顯著提升了客戶滿意度與參與程度。
  • 建立創新且以技術為核心的企業文化,鼓勵員工保持敏捷並持續創新。這項文化轉型持續推動銀行的數位計畫向前發展。
  • 導入 AI 與機器學習,以改善營運與客戶體驗。例如,星展銀行開發 AI 驅動的解決方案,以簡化流程並提升效率。

星展銀行的數位轉型成果不僅為其贏得產業獎項,也提升了品牌聲譽與客戶滿意度;該銀行股價在 2020 至 2024 年間上漲近 80%,[3] 這在很大程度上歸功於其令人印象深刻的數位化進展。


2. 金融業數位轉型案例:摩根大通(JPMorgan Chase)

摩根大通積極採用 AI 與機器學習技術,用於偵測詐欺、評估風險,以及為客戶提供個人化的財務建議。他們的技術創新同時延伸至內部與外部,為客戶與員工帶來重大影響。例如:

  • 他們的 COiN(Contract Intelligence,合約智慧)平台將法律文件的審查與解讀自動化,把原本需要 360,000 小時完成的工作縮短至數秒。
  • 他們將 AI 與機器學習應用於 300 個使用案例,並於 2023 年創造超過 15 億美元的商業價值。[5]
  • 他們持續投入技術轉型,於 2024 年編列 170 億美元預算,聚焦於核心平台現代化,以及開發推動創新的解決方案。[4]

摩根大通對數位轉型的策略性投資,使其成為技術驅動型金融服務的領導者,為客戶創造實質的商業價值與營運效率。


3. 零售業數位轉型案例:星巴克(Starbucks)

星巴克將飲品點購轉化為更個人化、有趣且具親近感的體驗。他們的數位轉型聚焦於提升客戶參與與營運效率,同時成功支撐穩定的業務成長,而沒有讓營運成本大幅攀升。以下是幾個例子:

  • 行動應用程式與會員獎勵計畫: Starbucks 行動 App 整合點餐、付款與獎勵計畫,提供個人化體驗與促銷活動。這項策略提高了客戶忠誠度,也簡化了交易流程。
  • 人工智慧整合: Starbucks 利用 AI 改善庫存管理並提供個人化客戶互動,進而提升服務效率與滿意度。
  • 數位飛輪策略(Digital Flywheel Strategy): 透過聚焦於獎勵、遊戲化、個人化,以及便利的付款與點餐體驗,Starbucks 將數位與實體的客戶互動整合在一起,進而推動成長並提高客戶留存。

4. 零售業數位轉型案例:樂高集團(LEGO Group)

擁有 92 年歷史的樂高集團,在數位轉型策略的推動下,成功重新活化品牌並擴大市場版圖。

除了開發數位平台與應用程式,提供創新的數位遊戲體驗之外,LEGO 也大幅投資數位解決方案,以支持其永續發展目標。例如,他們利用資料分析改善供應鏈並降低環境衝擊。這與其實現「零衝擊(zero impact)」目標的願景一致。[6]


5. 保險業數位轉型案例:安盛集團(AXA)

AXA 的數位轉型顯著提升了其服務與營運效率。他們尤其投入大量資源發展雲端與混合式解決方案。以下是他們已實施並帶來改變的幾項重要行動:

  • 運用即時資料與分析: 衛星、無人機與感測器負責蒐集資料,以強化 AXA 在風險預防與理賠能力方面的專業知識。[7]
  • Move to the Cloud 計畫: AXA 啟動一項全球計畫,將資料與應用程式移轉至雲端,以提高彈性、擴充性與安全性。該計畫同時支援 AI 與聊天機器人等創新技術的導入。[8]
  • 數位理賠解決方案: AXA 推出數位理賠解決方案,為汽車保險客戶提供流暢的端到端數位體驗。透過更快速、更有效率的理賠處理,這項發展提升了客戶滿意度。

6. 物流業數位轉型案例:Lalamove

最後,Lalamove 的數位轉型將其推向物流產業的前線。其中尤其值得關注的是,Lalamove 的 API 整合提升了公司的營運效率與溝通能力。推動成功的核心措施包括:

  • 行動應用程式平台: Lalamove 開發了一款使用者友善的行動 App,即時媒合客戶與配送司機。[9] 該平台提供即時訂單配對、即時追蹤與多種付款方式等功能,進而提升使用者體驗與營運效率。
  • 資料分析與最佳化: Lalamove 利用資料分析改善配送路線並提升效率。透過分析交通模式與配送資料,Lalamove 得以縮短配送時間並降低營運成本。

這些數位措施強化了 Lalamove 在物流產業中的地位,並促成近年營收與市場占有率的顯著成長。


3 個值得借鏡的數位轉型失敗案例

並非所有的數位轉型努力最終都能成功。相較於中小企業與新創公司,大型組織往往更難成功完成數位轉型。

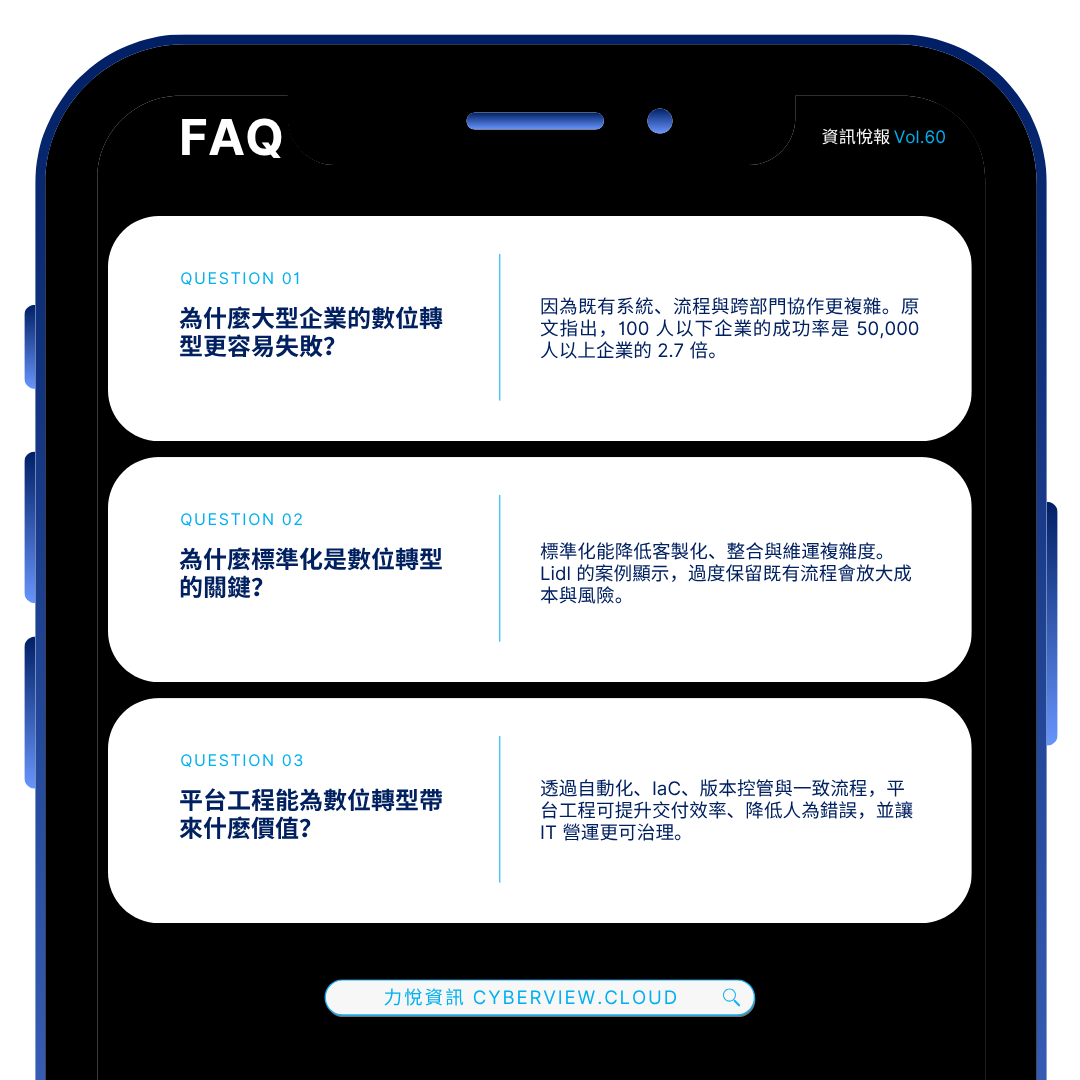
研究顯示,員工人數在 100 人以下的企業,其數位轉型成功機率,是擁有 50,000 名以上員工大型企業的 2.7 倍。[10]

為什麼這些計畫會失敗?我們又能從它們的挫敗中學到什麼?以下將透過 Haribo、McDonald’s 與 Lidl 的案例,了解其策略為何未能達成預期成果。


Haribo:規劃不足導致小熊軟糖短缺

這家以熊形軟糖聞名的糖果大廠,在嘗試導入數位轉型流程以簡化營運時,遭遇了明顯挑戰。最終,由於規劃不足與員工訓練不充分,轉型計畫宣告失敗,進而造成庫存追蹤混亂、原料交付延誤,以及其他供應鏈中斷問題。2018 年的一段期間,其知名小熊軟糖甚至出現供應短缺。

這些問題在轉型後不久造成銷售量下滑 25%,[11] 凸顯大型數位專案中,充分準備與員工訓練的重要性。


McDonald’s:AI 失敗,竟把培根加進冰淇淋

還記得 2024 年那場讓這家餐飲連鎖巨頭陷入停擺的全球技術中斷嗎?從洛杉磯到東京,客戶一度無法點餐與付款,造成重大的銷售損失與聲譽衝擊。但這並非單一事件。這家大型速食連鎖企業近期也曾嘗試將 AI 驅動的點餐系統導入得來速,但最終失敗,導致該計畫終止。

該 AI 系統不但沒有簡化點餐流程,反而經常誤解客戶的訂單,導致錯誤,例如把培根加進冰淇淋。

多次失敗背後的核心原因,歸結於基礎架構可靠性不足與系統整合問題。測試不足,以及缺乏簡便的回滾機制,也進一步阻礙了其數位轉型進程。


Lidl:缺乏標準化,導致 5 億歐元的失敗

平台工程與數位轉型所帶來的最大效益之一,就是標準化。德國折扣零售巨頭 Lidl 在過去的數位轉型過程中,未能有效運用標準化的優勢。他們於 2011 年啟動一項耗資 5 億歐元的專案,希望汰換既有的庫存管理系統。然而,由於幾項關鍵挑戰,該計畫於 2018 年遭到放棄,最終促使這家超市巨頭決定回到原有系統。

導致失敗的關鍵因素

對流程標準化的抗拒: Lidl 傳統上以進貨價格評估庫存,但這與 SAP 採用零售價格的標準作法產生衝突。Lidl 堅持維持既有流程,因此必須進行大量軟體客製化,進而增加系統複雜度與成本。

資料遷移挑戰: 從舊系統移轉至 SAP,需要極為嚴謹的資料準備。Lidl 在這方面面臨相當大的困難,最終造成系統整合問題與效率不佳。


如何透過 RE:FORM 從數位轉型中獲益

數位轉型始於規模小、可管理的步驟。以下是 RE:FORM 如何協助您加速數位化進程的方式:

1. 更快速部署軟體、應用程式與基礎架構

RE:FORM 可協助您將部署速度提升至 5 倍,將部署時間縮短至數分鐘,並將產品上市時間(Time-to-Market)縮短 50%。透過自動化、簡化 CI/CD 流程,以及工具與整合方式的標準化,我們已協助企業客戶實現流暢的轉型。

2. 標準化與自動化

RE:FORM 在 CD 流程中提供完整自動化、快速回滾、版本控管、Everything as Code(一切皆程式碼)、透明的稽核軌跡,以及即時效能監控等功能,以加快回饋與更新的落實速度。

3. 資料驅動決策

透過 RE:FORM 衡量與追蹤 DevOps 效能的能力,企業得以即時取得可採取行動的關鍵洞察。藉由集中且可客製化的儀表板,您的業務、技術、維運與資安團隊都能從實證型洞察中受益,進而簡化決策流程。

4. 節省成本

透過自動化營運流程並減少人為錯誤,RE:FORM 能在提升團隊能力的同時降低成本。由於 RE:FORM 可降低技術門檻並縮短新進人員上手時間,因此能減輕遇缺不補、高流動率或其他人才斷層問題帶來的影響。RE:FORM 能提升團隊效率並釋放更多組織潛力,而無需額外增加人力。

5. 無縫整合與擴充能力

在獲獎團隊的支援下,RE:FORM 能確保與企業既有系統流暢整合,使您的企業得以改善資源配置並更快速擴充,以輕鬆因應市場需求與客戶需要。


正在尋找智慧型 DevOps 與平台工程工具嗎?

數位轉型不是維他命,而是一條生命線。隨著我們邁向 2025 年,未能意識到轉型與採取行動迫切性的企業,勢必將被拋在後頭。

RE:FORM 已透過平台工程成功協助企業以 5 倍速度部署與交付應用程式、軟體及基礎架構,同時確保程式碼完全由企業內部自主掌握。

如果您正在尋找一套智慧型 DevOps 與平台工程工具,協助企業在數位轉型時代持續發展,請聯絡 RE:FORM,以取得更符合需求的解決方案。


立即聯絡我們  

資訊悅報 Vol.59|Vicarius: 單一掃描方式看不完整?企業如何補齊資產盲區,掌握完整風險全貌?

部落格來源網址:https://www.vicarius.io/articles/why-agentless-agent-based-scanning-together-create-a-complete-risk-picture


為什麼結合不同掃描方式,才能看見完整的企業風險全貌?

您的漏洞管理計畫品質,完全取決於它能看見什麼。如果您在複雜的企業混合環境中只執行單一掃描手法,將會有整個類別的資產落入完全看不見的盲區。

這並非廠商的業務話術。這是由每種掃描方式的運作原理所導出的結構性問題。代理程式掃描(Agent-based Scanning)能針對已部署代理程式的受控系統,提供深入且持續的可視性;另一種掃描方式則可針對透過網路或雲端 API 觸及的資產,快速擴大涵蓋範圍。兩種方法都無法完全涵蓋另一方的能力範圍,而且各自遺漏的資產類型並不相同,往往正是風險最容易被忽略的地方。

資安長(CISO)在評估漏洞管理平台時,在考慮其他條件之前必須先問一個問題:這個工具看見的是我的整個攻擊表面,還是只是我本來就已經維運得很好的那一部分?


每種方法的具體運作方式

代理程式掃描(Agent-based Scanning)的運作方式是直接在每個主機上執行軟體,賦予其存取設定檔案、執行中程序以及檔案系統資料的特權權限。相反地,無代理程式掃描(Agentless Scanning)則使用雲端供應商的 API、磁碟快照以及網路協定,從外部評估系統;它們絕不會登入機器或在機器內部執行程式碼。

實際上的差異在於:無代理程式工具更偏向回答「哪些資產可能遭受攻擊」,而代理程式掃描(Agent-based Scanning)則能在執行階段(Runtime)提供更深入的威脅偵測與行為分析,持續掌握主機實際發生的活動。


修正後的覆蓋率全貌

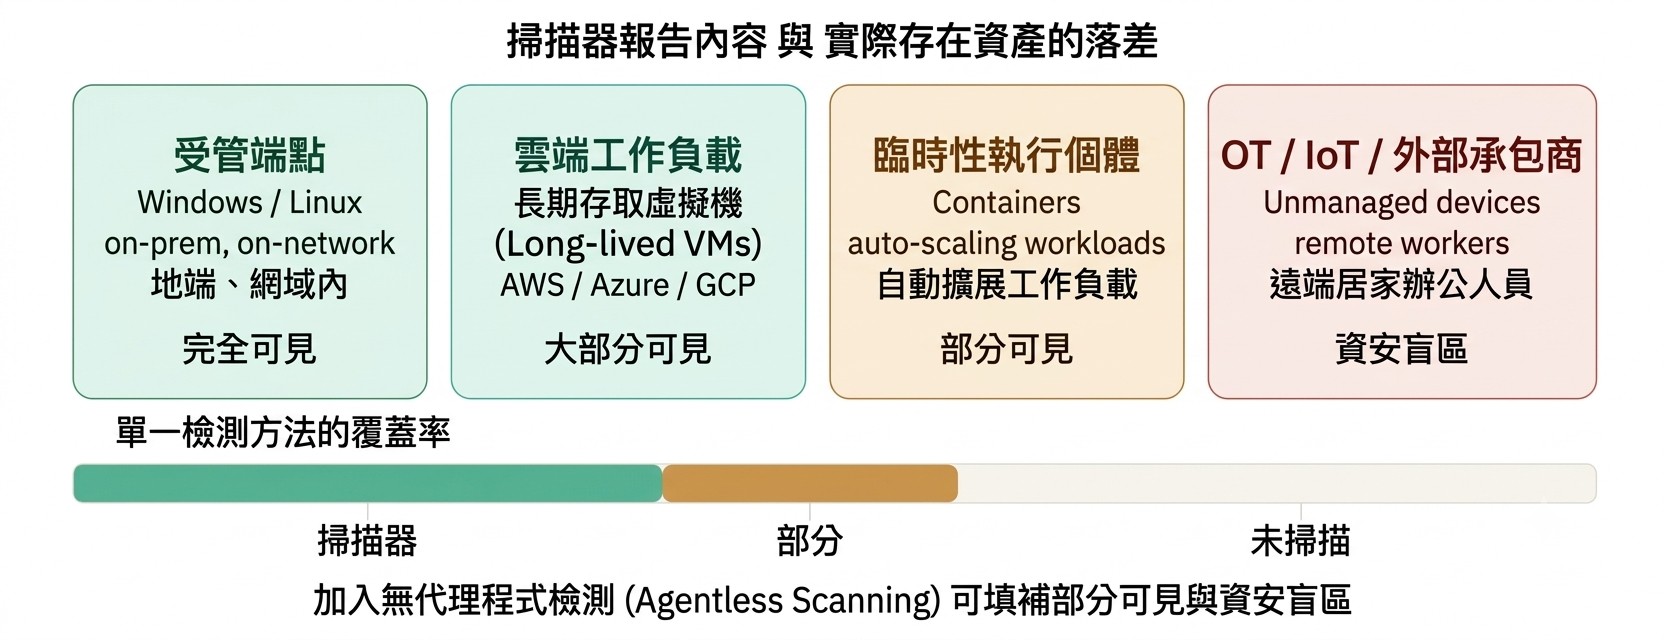
這場討論往往建立在過度理想化的假設上。以下是研究在不同資產類別中所呈現的實際涵蓋情況,以及其中不可忽略的細微差異:

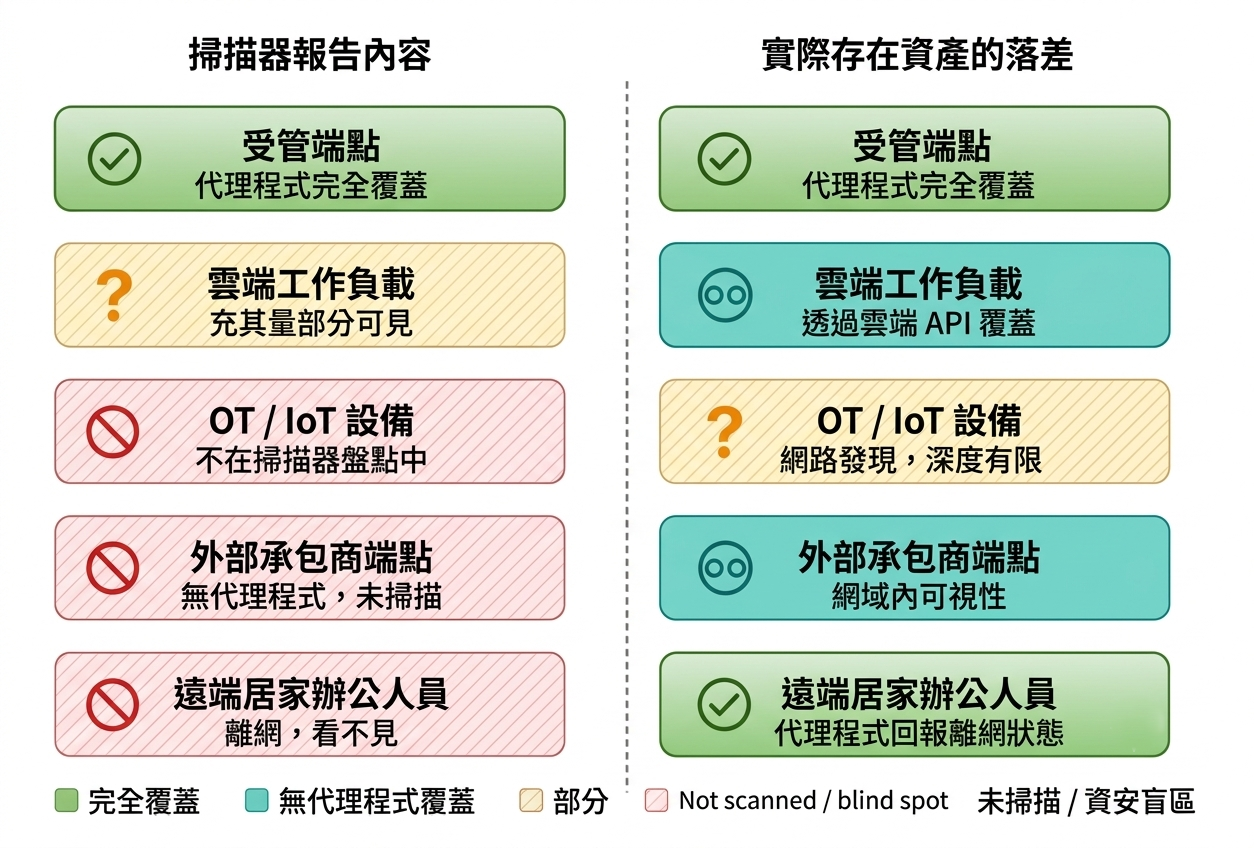
有兩項修正值得從原始表格中明確指出。第一,遠端與離網端點(例如家用網路背後的筆記型電腦):這類資產對於無代理程式掃描而言完全是隱形的。無代理程式掃描需要持續的網路連線,這使其不適用於遠端工作者,因為掃描器無法觸及他們在家用網路背後的設備。在 2020 年之後的勞動力結構中,這是一個極其重要的細微差異。第二,OT 與 IoT 設備:無代理程式掃描可以識別 IoT 設備以及路由器和交換器等網路設備(這些設備沒有支援代理程式的作業系統),這類設備並非都能被完整「發現(Discoverable)」,而是只能達到網路層級可見(Network-visible)。除非能進行經身分驗證的掃描(Authenticated Scan),否則取得的漏洞資料深度通常不如標準端點;即使如此,結果仍受到掃描週期影響。

例如在台灣常見的 IT 維運情境中,當員工將公司配發的筆記型電腦帶回家中工作,且未連回企業 VPN 時,傳統的網路掃描便會完全斷線,這時就必須仰賴代理程式掃描(Agent-based Scanning)才能確保資安防禦不中斷。


容易被利用的盲點

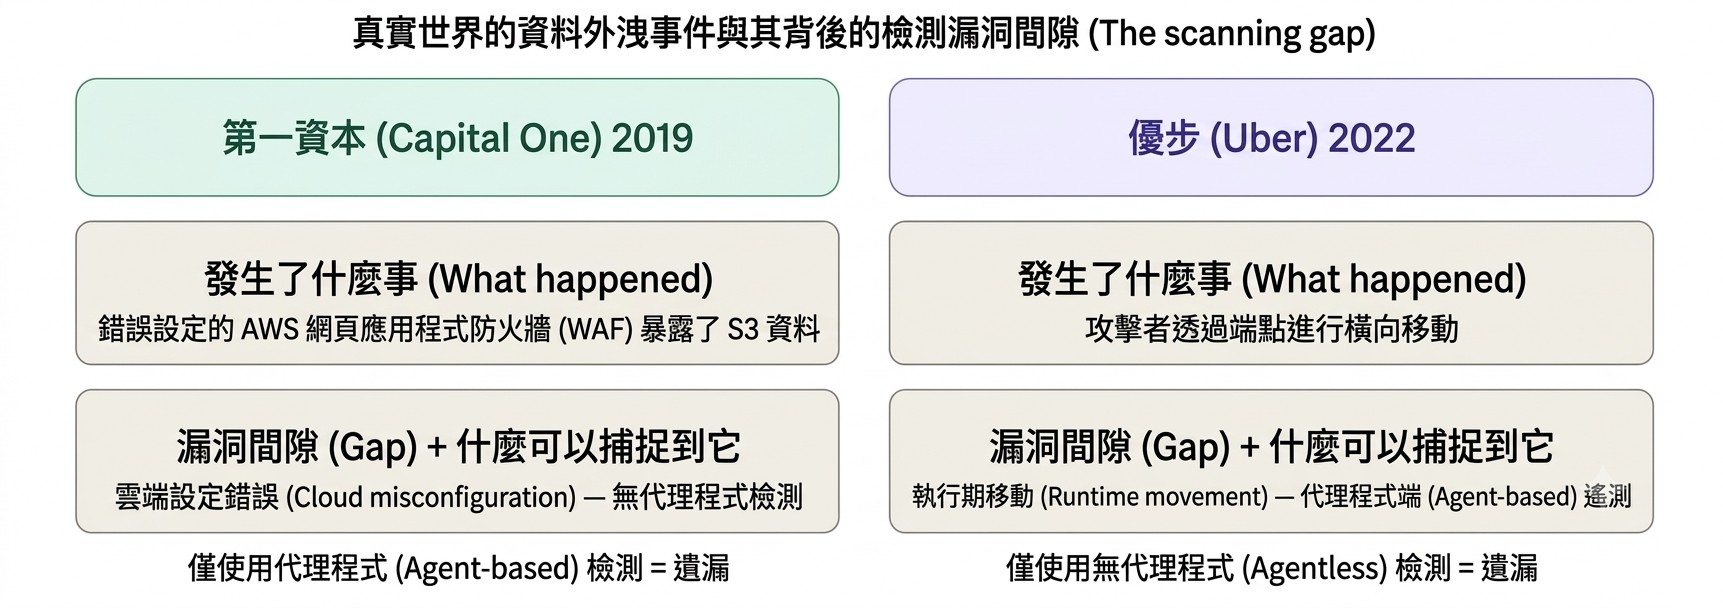
這兩類覆蓋盲區並非紙上談兵。在 Capital One 2019 年的資料外洩事件中,錯誤設定的 AWS WAF 暴露了 S3 資料,這原本是無代理程式掃描可以在事件發生前捕捉到的。而在 Uber 2022 年的資料外洩事件中,來自代理程式感測器的執行階段遙測資料,本可以捕捉到內部橫向移動。

這些事件呈現出一致的模式:不同類型的攻擊,往往會利用組織留下的不同防護缺口。

這在維運上之所以至關重要,是因為合規與稽核需求可能會驅使組織偏向其中一種方法,進而產生覆蓋率的虛假安全感。SOC 2 和 ISO 27001 的規範在紙面上可以透過雲端層級的無代理程式掃描來滿足,但這並不代表受控端點上的執行階段行為威脅得到了防護。稽核雖然過關了,但盲區依然存在。


「結合」的真正定義?

執行兩個獨立的掃描工具並合併 CSV 匯出檔案,並不能稱為結合的方法。這只是一個披著資安計畫外衣的資料對帳問題。

一個真正的多重手法架構需要具備多數單一功能產品無法提供的三項要素:

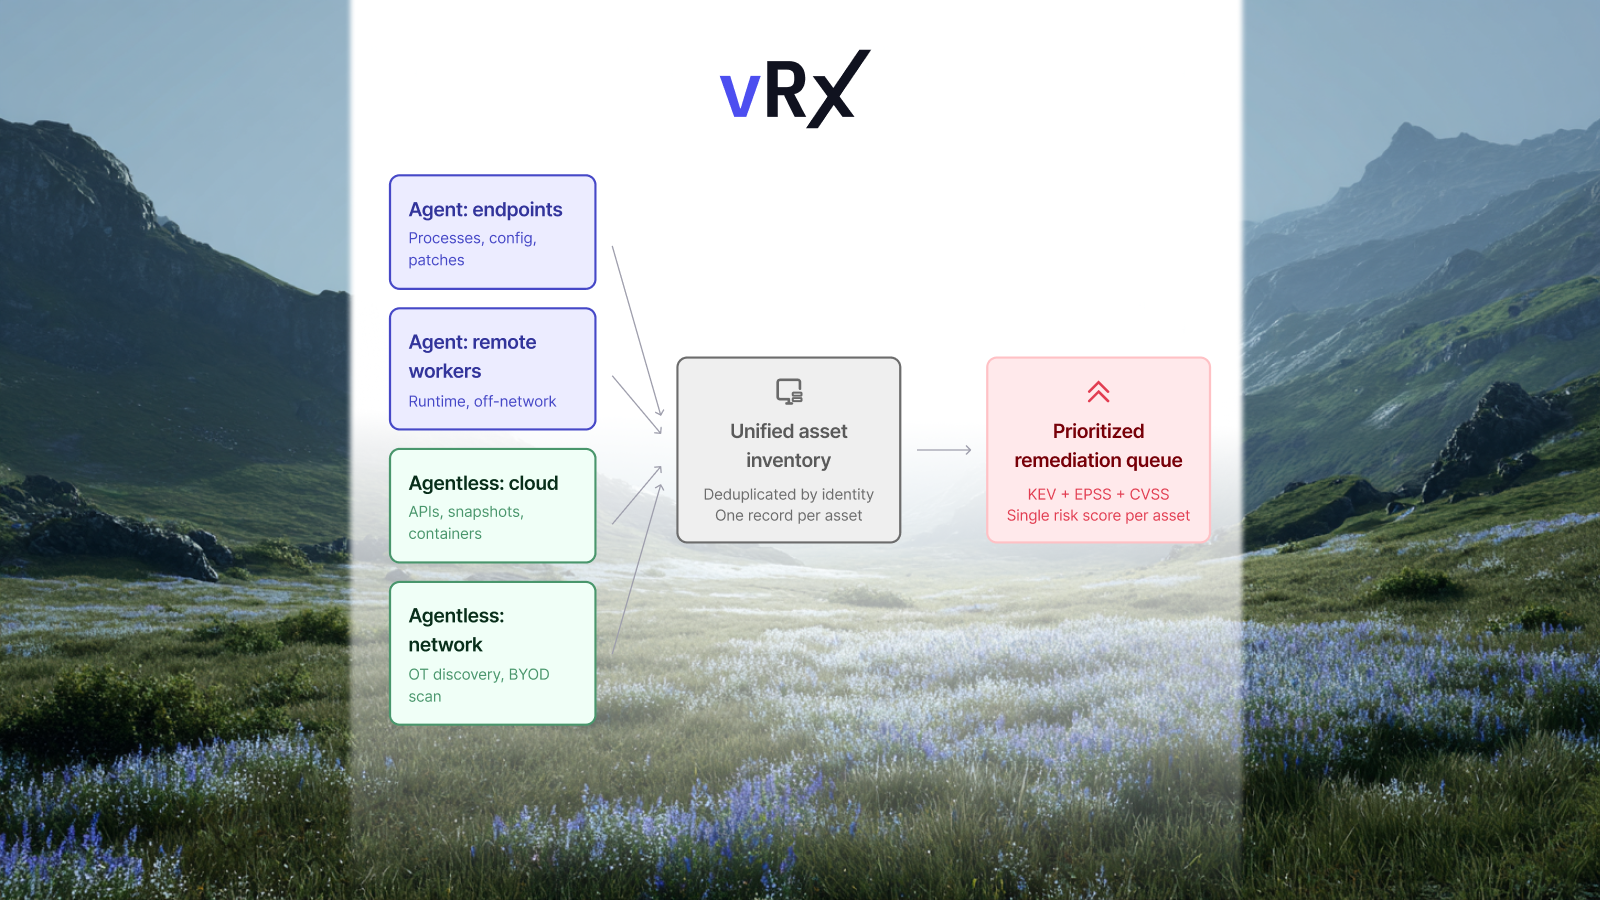
首先,統一資產識別(Unified Asset Identity)。
結合兩種掃描方式可確保廣泛的覆蓋率與豐富的資料,特別是在混合與遠端環境中,但前提是平台必須能夠將無代理程式發現的設備,與其由代理程式管理的對應設備進行媒合,而不會建立重複的紀錄。IP 位址會變更,主機名稱會漂移。如果平台將它們視為不同資產,不僅會造成漏洞數量膨脹,修補成效指標(Remediation Metrics)也會因此失真。

第二,單一風險視角。
來自這兩種方法的發現需要被一同正規化並排出優先順序。在雲端工作負載中透過無代理程式發現的 CVSS 9.8 漏洞,與在受控伺服器上由代理程式發現的 CVSS 9.8 漏洞,應該出現在同一個修補佇列中,並套用相同的優先順序邏輯。

第三,誠實地報告存在的不足之處。
僅執行單一掃描方法所帶來最危險的產物,就是虛假的自信。一個顯示「管理中包含 12,000 個漏洞」,卻未揭露其僅涵蓋 60% 資產清冊的平台,並不是真正的風險管理工具,反而可能形成治理與責任上的風險。

混合型企業環境下的實際運作情況

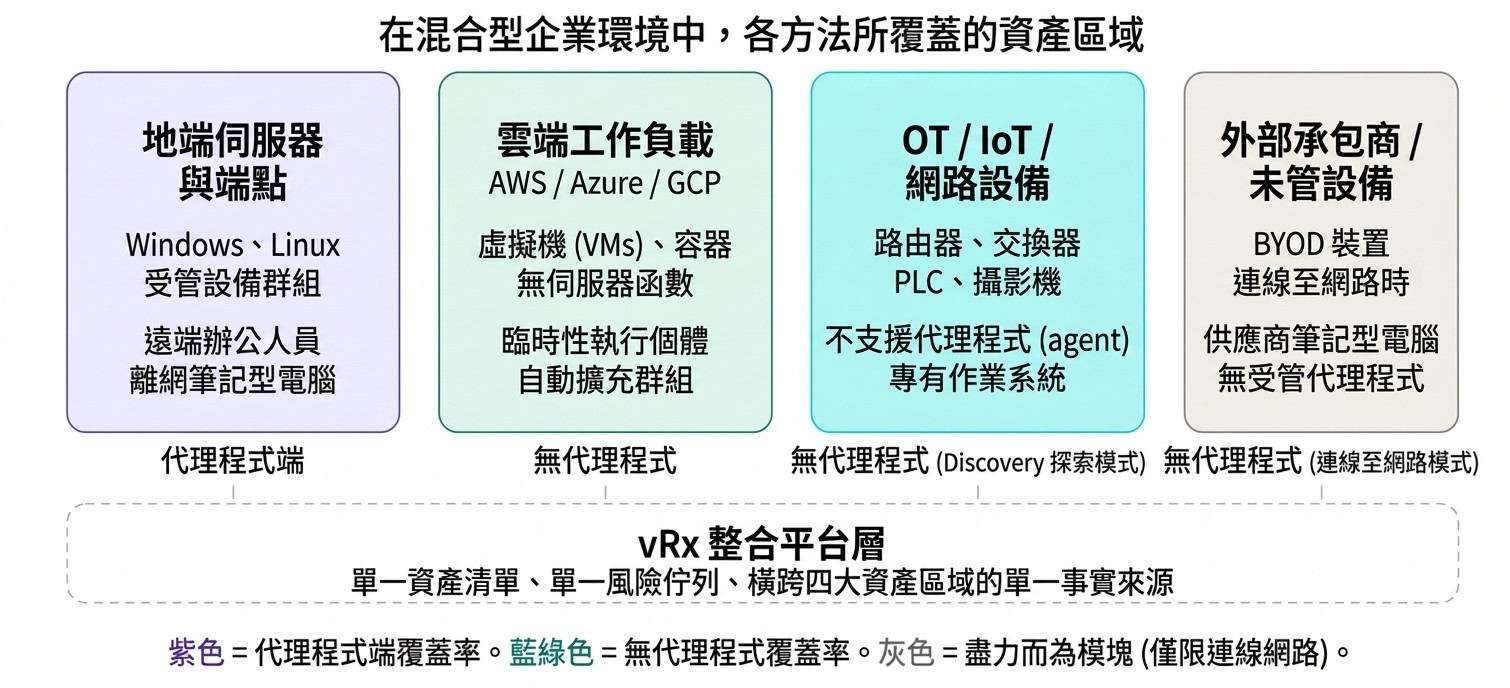
對於同時涵蓋地端基礎架構、雲端工作負載、OT 網路與外部承包商設備的企業環境——也就是現今多數企業的實際樣貌——採取多重掃描方式並非選配,而是建立可被驗證之風險管理的最低必要架構。

對於安全性與可靠性至關重要的關鍵任務地端系統,代理程式掃描(Agent-based Scanning)系統是審慎的選擇;而無代理程式掃描(Agentless Scanning)對於包含異質設備的網路環境而言,則更具彈性與擴充性。資安從業人員的實際建議是一致的:使用無代理程式掃描來獲取全組織的覆蓋率、資產清冊,以及跨所有雲端帳號的組態與漏洞檢查,接著在需要深入執行階段檢測的特定關鍵工作負載上部署代理程式。

這就是其架構。關鍵問題在於,您的平台是否原生支援這種架構,還是必須透過不同元件的整合才能建構?

為什麼 vRx 能夠同時具備這兩項任務?

Vicarius 的 vRx 正是圍繞此一架構而設計:將代理程式掃描(Agent-based Scanning)與無代理程式掃描(Agentless Scanning)視為單一平台內的原生功能,並共同匯入統一資產識別(Unified Asset Identity)清冊中。當一台設備最初透過無代理程式掃描被發現,之後再納入代理程式管理時,不會因此建立重複紀錄。來自兩種來源的漏洞發現會在同一個佇列中進行正規化與排序,並採用一致的風險評分邏輯。

對於管理混合環境的資安長(CISO)而言,採購兩套不同領域的工具再自行對齊輸出,反而會產生前述資料完整性問題:資產清冊失真、去重複化機制在規模擴大後失效,甚至讓提交董事會的數據表面上看似完整,實際涵蓋範圍卻仍存在大量盲區。

平台的核心問題不在於選擇「代理程式或無代理程式」,而是「哪一個平台能原生提供我兩者,而不需要我的團隊去維護兩種資料模型」。

評估漏洞管理平台時,必須問的關鍵問題

在承諾採用任何漏洞管理平台之前,請要求廠商向您展示一份包含該工具「未發現」資產的覆蓋率報告,而不僅僅是它所發現的資產。任何無法區分「資產無漏洞」與「資產未掃描」的平台,都無法提供真實的風險輪廓。

它提供的,只是已知資產的局部快照,而非完整的風險全貌。

如果您希望在單一視角中掌握涵蓋受控端點、雲端工作負載以及未受控設備的真實攻擊表面狀況,歡迎預約產品展示。我們將針對您目前的環境進行覆蓋率評估,並向您展示您現有的工具遺漏了什麼。

另請參閱:

6 個任務:Vicarius 比您現有的漏洞平台更高效

當修補方案不足時:vRx 腳本引擎填補修補缺口


立即聯絡我們